# Swin2SR
## نظرة عامة
قُدِّم نموذج Swin2SR في [Swin2SR: SwinV2 Transformer for Compressed Image Super-Resolution and Restoration](https://huggingface.co/papers/2209.11345) بواسطة Marcos V. Conde وUi-Jin Choi وMaxime Burchi وRadu Timofte. يحسّن Swin2SR نموذج [SwinIR](https://github.com/JingyunLiang/SwinIR/) من خلال دمج طبقات [Swin Transformer v2](swinv2) التي تخفف من مشاكل مثل عدم استقرار التدريب، والفجوات في الدقة بين التدريب المسبق والتدريب الدقيق، والاحتياج الكبير إلى البيانات.
المستخلص من الورقة البحثية هو كالتالي:
*تلعب عملية الضغط دورًا مهمًا في النقل والتخزين الفعال للصور والفيديوهات عبر الأنظمة محدودة النطاق الترددي مثل خدمات البث المباشر والواقع الافتراضي وألعاب الفيديو. ومع ذلك، يؤدي الضغط حتمًا إلى ظهور تشوهات وفقدان المعلومات الأصلية، مما قد يُضعف الجودة البصرية بشكل كبير. ولأسباب من هذا القبيل، أصبحت تحسين جودة الصور المضغوطة موضوعًا بحثيًا شائعًا. في حين أن معظم طرق استعادة الصور المتقدمة تعتمد على الشبكات العصبية التلافيفية، فإن طرق أخرى تعتمد على نماذج التحويلات مثل SwinIR تُظهر أداءً مثيرًا للإعجاب في هذه المهام. في هذه الورقة، نستكشف النموذج الجديد Swin Transformer V2 لتحسين SwinIR في مجال رفع دقة الصور، ولا سيما في سيناريو المدخلات المضغوطة. باستخدام هذه الطريقة، يمكننا معالجة القضايا الرئيسية في تدريب نماذج الرؤية التحويلية، مثل عدم استقرار التدريب، والفجوات في الدقة بين التدريب المسبق والتدريب الدقيق، والحاجة الكبيرة إلى البيانات. أجرينا تجارب على ثلاث مهام تمثيلية: إزالة تشوهات ضغط JPEG، ورفع دقة الصور (الكلاسيكي والخفيف)، ورفع دقة الصور المضغوطة. تُظهر النتائج التجريبية أن طريقتنا، Swin2SR، يمكنها تحسين تقارب التدريب وأداء SwinIR، وهي حل ضمن أفضل خمسة حلول في "AIM 2022 Challenge on Super-Resolution of Compressed Image and Video".*
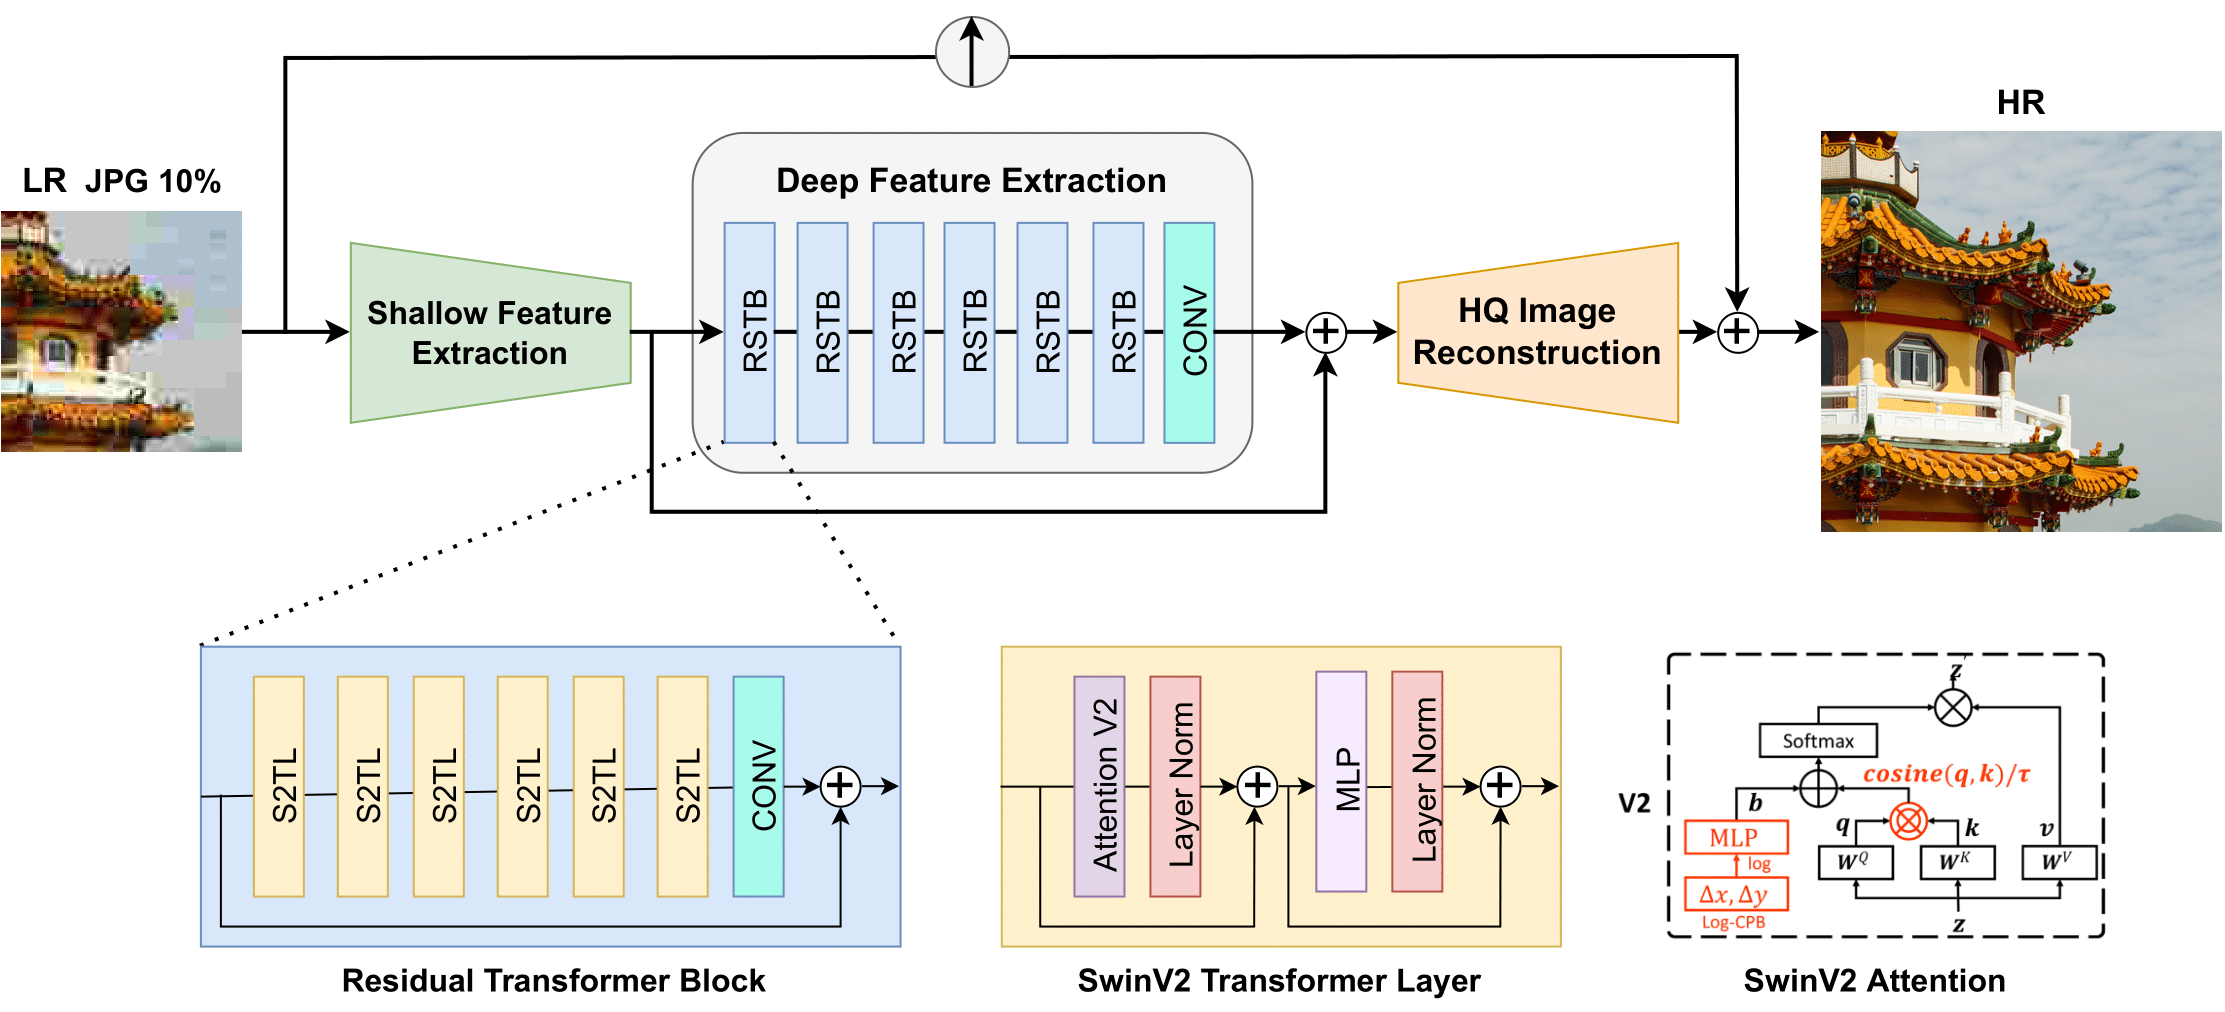 بنية Swin2SR. مأخوذة من الورقة الأصلية.
تمت مساهمة هذا النموذج من قِبل [nielsr](https://huggingface.co/nielsr). يمكن العثور على الكود الأصلي [هنا](https://github.com/mv-lab/swin2sr).
## الموارد
يمكن العثور على كراسات العرض الخاصة بـ Swin2SR [هنا](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Swin2SR).
يمكن العثور على مساحة تجريبية لتفصيل الصور باستخدام SwinSR [هنا](https://huggingface.co/spaces/jjourney1125/swin2sr).
## Swin2SRImageProcessor[[transformers.Swin2SRImageProcessor]]
#### transformers.Swin2SRImageProcessor[[transformers.Swin2SRImageProcessor]]
```python
transformers.Swin2SRImageProcessor(**kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/swin2sr/image_processing_swin2sr.py#L41)
**المعاملات:**
do_convert_rgb (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : يصف الأبعاد القصوى للمدخلات إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كان الحجم من نوع عدد صحيح.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*) : حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enum `PILImageResampling`. لا يؤثر إلا إذا كان `do_resize` مضبوطاً على `True`.
do_rescale (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*، القيمة الافتراضية هي `0.00392156862745098`) : عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطاً على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان سيتم إضافة حشوة إلى الصورة. تتم الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
size_divisor (`int`، *kwargs*، *اختياري*، القيمة الافتراضية هي `self.size_divisor`) : الحجم الذي يجب أن تكون الارتفاع والعرض قابلين للقسمة عليه عند الحشو.
ينشئ معالج صور من نوع Swin2SRImageProcessor.
#### preprocess[[transformers.Swin2SRImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/swin2sr/image_processing_swin2sr.py#L58)
**المعاملات:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : الصورة المراد معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبط `do_rescale=False`.
do_convert_rgb (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : يصف الأبعاد القصوى للمدخلات إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كان الحجم عددًا صحيحًا.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*) : حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enum `PILImageResampling`. لا يؤثر إلا إذا كان `do_resize` مضبوطاً على `True`.
do_rescale (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*) : معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطًا على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إضافة حشوة إلى الصورة. يتم تنفيذ الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
size_divisor (`int`، *kwargs*، *اختياري*، القيمة الافتراضية هي `self.size_divisor`) : الحجم الذي يجب أن تكون الارتفاع والعرض قابلين للقسمة عليه عند الحشو.
**يعيد:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب __call__ ('pixel_values'، وما إلى ذلك).
- **tensor_type** (`Union[None, str, TensorType]`، *اختياري*) -- يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
## Swin2SRImageProcessorPil[[transformers.Swin2SRImageProcessorPil]]
#### transformers.Swin2SRImageProcessorPil[[transformers.Swin2SRImageProcessorPil]]
```python
transformers.Swin2SRImageProcessorPil(**kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/swin2sr/image_processing_pil_swin2sr.py#L42)
**المعاملات:**
do_convert_rgb (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : يصف الأبعاد القصوى للمدخلات إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كان الحجم من نوع عدد صحيح.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*) : حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enum `PILImageResampling`. لا يؤثر إلا إذا كان `do_resize` مضبوطاً على `True`.
do_rescale (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*، القيمة الافتراضية هي `0.00392156862745098`) : عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطاً على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان سيتم إضافة حشوة إلى الصورة. تتم الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
size_divisor (`int`، *kwargs*، *اختياري*، القيمة الافتراضية هي `self.size_divisor`) : الحجم الذي يجب أن تكون الارتفاع والعرض قابلين للقسمة عليه عند الحشو.
ينشئ معالج صور من نوع Swin2SRImageProcessor.
#### preprocess[[transformers.Swin2SRImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/swin2sr/image_processing_pil_swin2sr.py#L59)
**المعاملات:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : الصورة المراد معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبط `do_rescale=False`.
do_convert_rgb (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : يصف الأبعاد القصوى للمدخلات إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كان الحجم عددًا صحيحًا.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*) : حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enum `PILImageResampling`. لا يؤثر إلا إذا كان `do_resize` مضبوطاً على `True`.
do_rescale (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*) : معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطًا على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إضافة حشوة إلى الصورة. يتم تنفيذ الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
size_divisor (`int`، *kwargs*، *اختياري*، القيمة الافتراضية هي `self.size_divisor`) : الحجم الذي يجب أن تكون الارتفاع والعرض قابلين للقسمة عليه عند الحشو.
**يعيد:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب __call__ ('pixel_values'، وما إلى ذلك).
- **tensor_type** (`Union[None, str, TensorType]`، *اختياري*) -- يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
## Swin2SRConfig[[transformers.Swin2SRConfig]]
#### transformers.Swin2SRConfig[[transformers.Swin2SRConfig]]
```python
transformers.Swin2SRConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, image_size: int | list[int] | tuple[int, int] = 64, patch_size: int | list[int] | tuple[int, int] = 1, num_channels: int = 3, num_channels_out: int | None = None, embed_dim: int = 180, depths: list[int] | tuple[int, ...] = (6, 6, 6, 6, 6, 6), num_heads: list[int] | tuple[int, ...] = (6, 6, 6, 6, 6, 6), window_size: int = 8, mlp_ratio: float = 2.0, qkv_bias: bool = True, hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, drop_path_rate: float | int = 0.1, hidden_act: str = 'gelu', use_absolute_embeddings: bool = False, initializer_range: float = 0.02, layer_norm_eps: float = 1e-05, upscale: int = 2, img_range: float = 1.0, resi_connection: str = '1conv', upsampler: str = 'pixelshuffle')
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/swin2sr/configuration_swin2sr.py#L24)
**المعاملات:**
image_size (`Union[int, list[int], tuple[int, int]]`، *اختياري*، القيمة الافتراضية `64`) : حجم (دقة) كل صورة.
patch_size (`Union[int, list[int], tuple[int, int]]`، *اختياري*، القيمة الافتراضية `1`) : حجم (دقة) كل رقعة.
num_channels (`int`، *اختياري*، القيمة الافتراضية `3`) : عدد قنوات الإدخال.
num_channels_out (`int`، *اختياري*، القيمة الافتراضية هي `num_channels`) : عدد قنوات الإخراج. إذا لم يتم تعيينه، فسيتم تعيينه إلى `num_channels`.
embed_dim (`int`، *اختياري*، القيمة الافتراضية `180`) : بُعد التضمينات والحالات المخفية.
depths (`list(int)`، *اختياري*، القيمة الافتراضية `[6, 6, 6, 6, 6, 6]`) : عمق كل طبقة في مُشفِّر Transformer.
num_heads (`list(int)`، *اختياري*، القيمة الافتراضية `[6, 6, 6, 6, 6, 6]`) : عدد رؤوس الانتباه في كل طبقة من طبقات مُشفِّر Transformer.
window_size (`int`، *اختياري*، القيمة الافتراضية 8) : حجم النوافذ.
mlp_ratio (`float`، *اختياري*، القيمة الافتراضية `2.0`) : نسبة بُعد MLP المخفي إلى بُعد التضمين.
qkv_bias (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إضافة انحياز إلى الاستعلامات والمفاتيح والقيم.
hidden_dropout_prob (`Union[float, int]`، *اختياري*، القيمة الافتراضية `0.0`) : احتمال الإسقاط (dropout) لجميع الطبقات المتصلة بالكامل في التضمينات (embeddings) والمشفّر (encoder) والمجمّع (pooler).
attention_probs_dropout_prob (`Union[float, int]`، *اختياري*، القيمة الافتراضية `0.0`) : نسبة الإسقاط (dropout) لاحتمالات الانتباه.
drop_path_rate (`Union[float, int]`، *اختياري*، الافتراضي هو `0.1`) : معدل إسقاط المسار لدمج البقع.
hidden_act (`str`، *اختياري*، القيمة الافتراضية `gelu`) : دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال، `"gelu"`، `"relu"`، `"silu"`، وما إلى ذلك.
use_absolute_embeddings (`bool`, *اختياري*, القيمة الافتراضية هي `False`) : ما إذا كان سيتم استخدام تضمينات المواقع المطلقة.
initializer_range (`float`، *اختياري*، القيمة الافتراضية `0.02`) : الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان.
layer_norm_eps (`float`، *اختياري*، القيمة الافتراضية `1e-05`) : قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة.
upscale (`int`, *اختياري*, القيمة الافتراضية 2) : عامل تكبير الصورة. 2/3/4/8 لدقة فائقة للصورة، و1 لإزالة الضوضاء وتقليل شوائب الضغط
img_range (`float`، *اختياري*، القيمة الافتراضية 1.0) : نطاق قيم صورة الإدخال.
resi_connection (`str`، *اختياري*، القيمة الافتراضية `"1conv"`) : كتلة الالتفاف المستخدمة قبل الاتصال المتبقي في كل مرحلة.
upsampler (`str`، *اختياري*، القيمة الافتراضية `"pixelshuffle"`) : وحدة إعادة البناء. يمكن أن تكون 'pixelshuffle'/'pixelshuffledirect'/'nearest+conv'/None.
هذه فئة الإعدادات (configuration class) لتخزين إعدادات نموذج Swin2SRModel. تُستخدم لاستحداث نموذج Swin2Sr وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ [caidas/swin2sr-classicalsr-x2-64](https://huggingface.co/caidas/swin2sr-classicalsr-x2-64)
ترث كائنات الإعداد من [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) لمزيد من المعلومات.
مثال:
```python
>>> from transformers import Swin2SRConfig, Swin2SRModel
>>> # Initializing a Swin2SR caidas/swin2sr-classicalsr-x2-64 style configuration
>>> configuration = Swin2SRConfig()
>>> # Initializing a model (with random weights) from the caidas/swin2sr-classicalsr-x2-64 style configuration
>>> model = Swin2SRModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## Swin2SRModel[[transformers.Swin2SRModel]]
#### transformers.Swin2SRModel[[transformers.Swin2SRModel]]
```python
transformers.Swin2SRModel(config: Swin2SRConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/swin2sr/modeling_swin2sr.py#L710)
**المعاملات:**
config ([Swin2SRConfig](/docs/transformers/main/ar/model_doc/swin2sr#transformers.Swin2SRConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج Swin2Sr الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.Swin2SRModel.forward]]
```python
forward(pixel_values: Tensor, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/swin2sr/modeling_swin2sr.py#L752)
**المعاملات:**
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`) : المصفوفات المقابلة لصور الإدخال. يمكن الحصول على قيم البكسل باستخدام [Swin2SRImageProcessor](/docs/transformers/main/ar/model_doc/swin2sr#transformers.Swin2SRImageProcessor). راجع [Swin2SRImageProcessor.__call__()](/docs/transformers/main/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل (`processor_class` يستخدم [Swin2SRImageProcessor](/docs/transformers/main/ar/model_doc/swin2sr#transformers.Swin2SRImageProcessor) لمعالجة الصور).
output_attentions (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع مصفوفات الانتباه لجميع طبقات الانتباه. راجع `attentions` ضمن المصفوفات المُرجعة لمزيد من التفاصيل.
output_hidden_states (`bool`, *اختياري*) : ما إذا كان سيتم إرجاع الحالات المخفية لجميع الطبقات. راجع `hidden_states` ضمن الموترات المُرجعة لمزيد من التفاصيل.
return_dict (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع [ModelOutput](/docs/transformers/main/ar/main_classes/output#transformers.utils.ModelOutput) بدلاً من tuple عادي.
**يعيد:** [BaseModelOutput](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutput) أو `tuple(torch.Tensor)`
[BaseModelOutput](/docs/transformers/main/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutput) أو مجموعة مرتبة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتماداً على الإعداد ([Swin2SRConfig](/docs/transformers/main/ar/model_doc/swin2sr#transformers.Swin2SRConfig)) والمدخلات.
تُعيد طريقة [Swin2SRModel](/docs/transformers/main/ar/model_doc/swin2sr#transformers.Swin2SRModel) الخاصة بالتقديم (forward) تعريف الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **last_hidden_state** (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`) -- تسلسل من حالات الإخفاء (hidden-states) عند مخرج الطبقة الأخيرة من النموذج.
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
مثال:
```python
```
## Swin2SRForImageSuperResolution[[transformers.Swin2SRForImageSuperResolution]]
#### transformers.Swin2SRForImageSuperResolution[[transformers.Swin2SRForImageSuperResolution]]
```python
transformers.Swin2SRForImageSuperResolution(config: Swin2SRConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/swin2sr/modeling_swin2sr.py#L943)
**المعاملات:**
config ([Swin2SRConfig](/docs/transformers/main/ar/model_doc/swin2sr#transformers.Swin2SRConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج Swin2SR من مكتبة Transformers مزوّد برأس مُصعِّد (upsampler) في قمته لأغراض رفع دقة الصور واستعادتها.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.Swin2SRForImageSuperResolution.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/swin2sr/modeling_swin2sr.py#L970)
**المعاملات:**
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`، *اختياري*) : المصفوفات المقابلة لصور الإدخال. يمكن الحصول على قيم البكسل باستخدام [Swin2SRImageProcessor](/docs/transformers/main/ar/model_doc/swin2sr#transformers.Swin2SRImageProcessor). راجع [Swin2SRImageProcessor.__call__()](/docs/transformers/main/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل (`processor_class` يستخدم [Swin2SRImageProcessor](/docs/transformers/main/ar/model_doc/swin2sr#transformers.Swin2SRImageProcessor) لمعالجة الصور).
labels (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : تسميات لحساب خسارة نمذجة اللغة المقنّعة. يجب أن تكون الفهارس إما ضمن `[0, ..., config.vocab_size]` أو -100 (انظر `input_ids` docstring). يتم تجاهل الرموز التي تكون فهارسها مضبوطة على `-100` (مقنّعة)، ولا تُحسب الخسارة إلا للرموز التي تسمياتها ضمن `[0, ..., config.vocab_size]`.
output_attentions (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع مصفوفات الانتباه لجميع طبقات الانتباه. راجع `attentions` ضمن المصفوفات المُرجعة لمزيد من التفاصيل.
output_hidden_states (`bool`, *اختياري*) : ما إذا كان سيتم إرجاع الحالات المخفية لجميع الطبقات. راجع `hidden_states` ضمن الموترات المُرجعة لمزيد من التفاصيل.
return_dict (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع [ModelOutput](/docs/transformers/main/ar/main_classes/output#transformers.utils.ModelOutput) بدلاً من tuple عادي.
**يعيد:** `ImageSuperResolutionOutput` أو `tuple(torch.Tensor)`
A `ImageSuperResolutionOutput` or a tuple of `torch.Tensor` (if `return_dict=False` is passed or when `config.return_dict=False`) comprising various elements depending on the configuration ([Swin2SRConfig](/docs/transformers/main/ar/model_doc/swin2sr#transformers.Swin2SRConfig)) and inputs.
تتجاوز طريقة [Swin2SRForImageSuperResolution](/docs/transformers/main/ar/model_doc/swin2sr#transformers.Swin2SRForImageSuperResolution) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` of shape `(1,)`, *اختياري*, يُعاد عند توفير `labels`) -- خسارة إعادة البناء.
- **إعادة البناء** (`torch.Tensor` من الشكل `(batch_size, num_channels, height, width)`) -- الصور المُعاد بناؤها، وقد تكون مُكبَّرة.
- **hidden_states** (`tuple(torch.Tensor)`, *اختياري*, يُعاد عند تمرير `output_hidden_states=True` أو عند `config.output_hidden_states=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل مرحلة) بشكل `(batch_size, sequence_length, hidden_size)`. حالات مخفية (تُسمى أيضًا خرائط الميزات) للنموذج عند مخرجات كل مرحلة.
- **attentions** (`tuple(torch.Tensor)`, *اختياري*, يُعاد عند تمرير `output_attentions=True` أو عند `config.output_attentions=True`) -- مجموعة مرتبة (Tuple) من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, patch_size, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
مثال:
```python
>>> import torch
>>> import numpy as np
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>> from io import BytesIO
>>> from transformers import AutoImageProcessor, Swin2SRForImageSuperResolution
>>> processor = AutoImageProcessor.from_pretrained("caidas/swin2SR-classical-sr-x2-64")
>>> model = Swin2SRForImageSuperResolution.from_pretrained("caidas/swin2SR-classical-sr-x2-64")
>>> url = "https://huggingface.co/spaces/jjourney1125/swin2sr/resolve/main/samples/butterfly.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> # prepare image for the model
>>> inputs = processor(image, return_tensors="pt")
>>> # forward pass
>>> with torch.no_grad():
... outputs = model(**inputs)
>>> output = outputs.reconstruction.data.squeeze().float().cpu().clamp_(0, 1).numpy()
>>> output = np.moveaxis(output, source=0, destination=-1)
>>> output = (output * 255.0).round().astype(np.uint8) # float32 to uint8
>>> # you can visualize `output` with `Image.fromarray`
```