# GIT
## Aperçu
Le modèle GIT a été proposé dans [GIT: A Generative Image-to-text Transformer for Vision and Language](https://huggingface.co/papers/2205.14100) par Jianfeng Wang, Zhengyuan Yang, Xiaowei Hu, Linjie Li, Kevin Lin, Zhe Gan, Zicheng Liu, Ce Liu, Lijuan Wang. GIT est un Transformer de type décodeur uniquement qui exploite l’encodeur visuel de [CLIP](clip) pour conditionner le modèle sur des entrées visuelles en plus du texte. Le modèle obtient des résultats de pointe sur les benchmarks de légendage d’images et de réponse à des questions visuelles.
L'abstract de l'article est le suivant :
*Dans cet article, nous concevons et entraînons un Transformer génératif d'image vers texte, GIT, afin d'unifier des tâches vision-langage telles que la légende d'images/vidéos et la réponse à des questions. Bien que les modèles génératifs offrent une architecture de réseau cohérente entre la pré-entraînement et l'ajustement fin, les travaux existants contiennent généralement des structures complexes (encodeur/décodeur uni/multi-modal) et dépendent de modules externes tels que des détecteurs/étiqueteurs d'objets et la reconnaissance optique de caractères (OCR). Dans GIT, nous simplifions l'architecture en un seul encodeur d'image et un seul décodeur de texte sous une unique tâche de modélisation du langage. Nous augmentons également la taille des données de pré-entraînement et la taille du modèle pour améliorer les performances. Sans fioritures, notre GIT établit de nouveaux états de l'art sur 12 benchmarks exigeants avec une large marge. Par exemple, notre modèle surpasse pour la première fois les performances humaines sur TextCaps (138,2 contre 125,5 en CIDEr). De plus, nous présentons un nouveau schéma de classification d'images et de reconnaissance de texte de scène basé sur la génération, atteignant des performances correctes sur des benchmarks standard.*
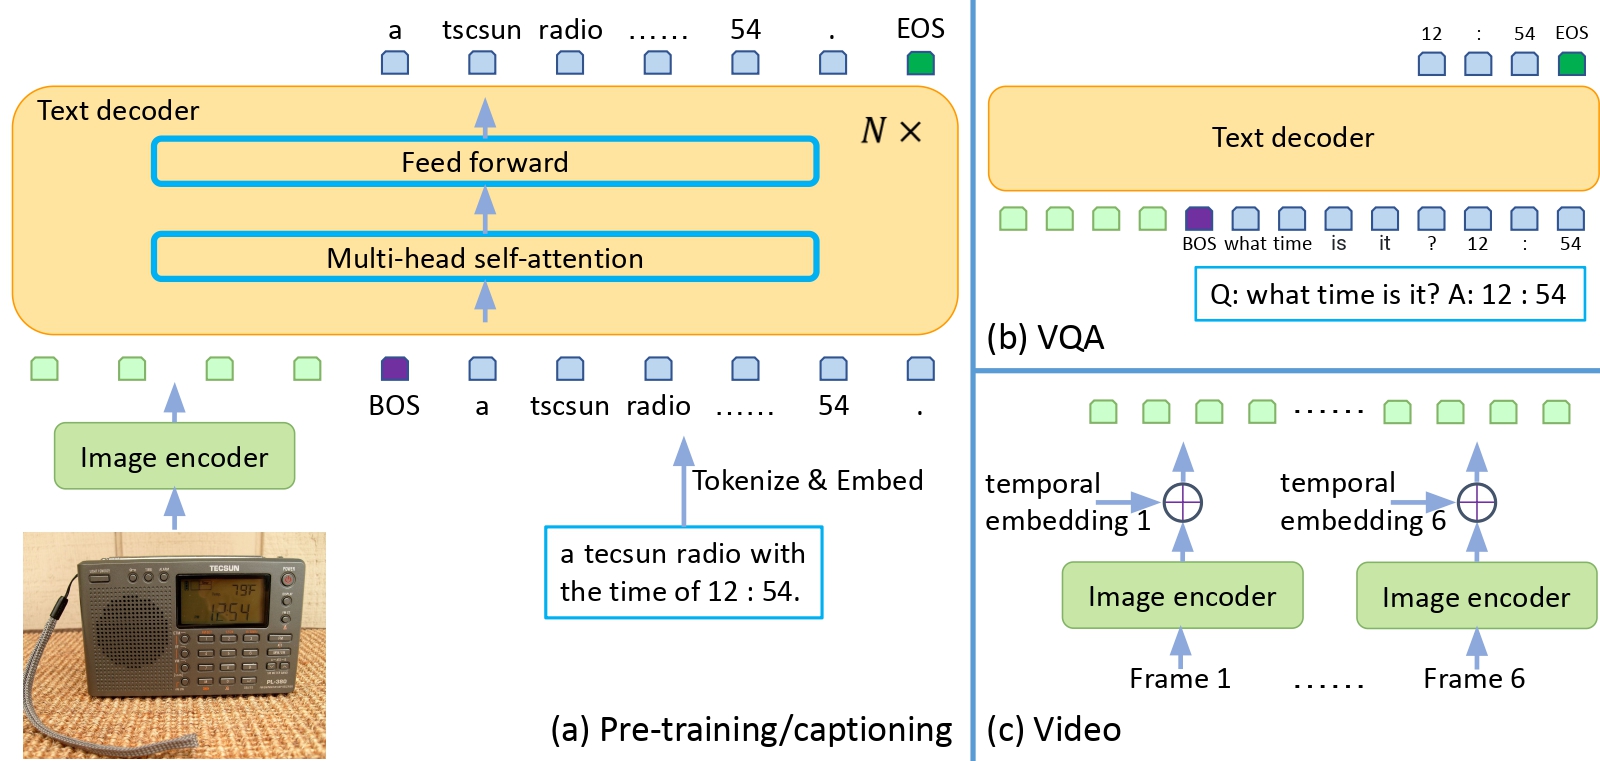 Architecture de GIT. Issue de l'article original.
Ce modèle a été contribué par [nielsr](https://huggingface.co/nielsr). Le code d'origine peut être trouvé [ici](https://github.com/microsoft/GenerativeImage2Text).
## Conseils d'utilisation
- GIT est implémenté de manière très similaire à GPT-2, la seule différence étant que le modèle est également conditionné sur `pixel_values`.
## Ressources
Une liste de ressources officielles Hugging Face et de la communauté (indiquées par 🌎) pour vous aider à démarrer avec GIT.
- Des notebooks de démonstration concernant l'inférence et l'ajustement fin de GIT sur des données personnalisées sont disponibles [ici](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/GIT).
- Voir aussi : [Guide de la tâche de modélisation de langage causale](../tasks/language_modeling)
Si vous souhaitez soumettre une ressource pour qu'elle soit incluse ici, n'hésitez pas à ouvrir une Pull Request et nous la examinerons. La ressource devrait idéalement démontrer quelque chose de nouveau plutôt que de dupliquer une ressource existante.
## GitVisionConfig[[transformers.GitVisionConfig]]
#### transformers.GitVisionConfig[[transformers.GitVisionConfig]]
```python
transformers.GitVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, intermediate_size: int = 3072, num_hidden_layers: int = 12, num_attention_heads: int = 12, num_channels: int = 3, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 16, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: float | int = 0.0, initializer_range: float = 0.02)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/git/configuration_git.py#L27)
**Paramètres :**
hidden_size (`int`, *facultatif*, par défaut `768`) : Dimension des représentations cachées.
intermediate_size (`int`, *facultatif*, par défaut `3072`) : Dimension des représentations MLP.
num_hidden_layers (`int`, *facultatif*, par défaut `12`) : Nombre de couches cachées dans le décodeur Transformer.
num_attention_heads (`int`, *facultatif*, valeur par défaut `12`) : Nombre de têtes d'attention pour chaque couche d'attention du décodeur Transformer.
num_channels (`int`, *facultatif*, par défaut `3`) : Le nombre de canaux d'entrée.
image_size (`Union[int, list[int], tuple[int, int]]`, *facultatif*, valeur par défaut `224`) : La taille (résolution) de chaque image.
patch_size (`Union[int, list[int], tuple[int, int]]`, *facultatif*, valeur par défaut `16`) : La taille (résolution) de chaque patch.
hidden_act (`str`, *facultatif*, par défaut `quick_gelu`) : La fonction d'activation non linéaire (fonction ou chaîne de caractères) dans le décodeur. Par exemple, `"gelu"`, `"relu"`, `"silu"`, etc.
layer_norm_eps (`float`, *facultatif*, valeur par défaut `1e-05`) : L'épsilon utilisé par les couches de normalisation de couche.
attention_dropout (`Union[float, int]`, *facultatif*, valeur par défaut `0.0`) : Le taux de dropout appliqué aux probabilités d'attention.
initializer_range (`float`, *facultatif*, valeur par défaut `0.02`) : L'écart-type de la truncated_normal_initializer utilisé pour l'initialisation de toutes les matrices de poids.
Il s'agit de la classe de configuration destinée à stocker la configuration d'un GitModel. Elle est utilisée pour instancier un modèle Git en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [microsoft/git-base](https://huggingface.co/microsoft/git-base)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
Exemple :
```python
>>> from transformers import GitVisionConfig, GitVisionModel
>>> # Initializing a GitVisionConfig with microsoft/git-base style configuration
>>> configuration = GitVisionConfig()
>>> # Initializing a GitVisionModel (with random weights) from the microsoft/git-base style configuration
>>> model = GitVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## GitVisionModel[[transformers.GitVisionModel]]
#### transformers.GitVisionModel[[transformers.GitVisionModel]]
```python
transformers.GitVisionModel(config: GitVisionConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/git/modeling_git.py#L634)
**Paramètres :**
config ([GitVisionConfig](/docs/transformers/main/fr/model_doc/git#transformers.GitVisionConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Le modèle de vision de CLIP, utilisé dans GIT, sans aucune tête ni projection au-dessus.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.GitVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/git/modeling_git.py#L652)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d'entrée. Les valeurs de pixels peuvent être obtenues à l'aide de [CLIPImageProcessor](/docs/transformers/main/fr/model_doc/clip#transformers.CLIPImageProcessor). Voir [CLIPImageProcessor.__call__()](/docs/transformers/main/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails ([GitProcessor](/docs/transformers/main/fr/model_doc/git#transformers.GitProcessor) utilise [CLIPImageProcessor](/docs/transformers/main/fr/model_doc/clip#transformers.CLIPImageProcessor) pour le traitement des images).
interpolate_pos_encoding (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut interpoler les encodages de position pré-entraînés.
**Retourne :** [BaseModelOutput](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutput) ou `tuple(torch.Tensor)`
Un [BaseModelOutput](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutput) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([GitConfig](/docs/transformers/main/fr/model_doc/git#transformers.GitConfig)) et les entrées.
La méthode forward du modèle [GitVisionModel](/docs/transformers/main/fr/model_doc/git#transformers.GitVisionModel) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **last_hidden_state** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`) -- Séquence d'états cachés à la sortie de la dernière couche du modèle.
- **hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemples :
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, GitVisionModel
>>> processor = AutoProcessor.from_pretrained("microsoft/git-base")
>>> model = GitVisionModel.from_pretrained("microsoft/git-base")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
```
## GitConfig[[transformers.GitConfig]]
#### transformers.GitConfig[[transformers.GitConfig]]
```python
transformers.GitConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vision_config: dict | transformers.models.git.configuration_git.GitVisionConfig | None = None, vocab_size: int = 30522, hidden_size: int = 768, num_hidden_layers: int = 6, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 1024, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, pad_token_id: int | None = 0, use_cache: bool = True, tie_word_embeddings: bool = False, bos_token_id: int | None = 101, eos_token_id: int | list[int] | None = 102, num_image_with_embedding: int | None = None)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/git/configuration_git.py#L62)
**Paramètres :**
vision_config (`Union[dict, ~models.git.configuration_git.GitVisionConfig]`, *facultatif*) : L'objet de configuration ou le dictionnaire du backbone visuel.
vocab_size (`int`, *facultatif*, valeur par défaut `30522`) : Taille du vocabulaire du modèle. Définit le nombre de jetons différents qui peuvent être représentés par `input_ids`.
hidden_size (`int`, *facultatif*, par défaut `768`) : Dimension des représentations cachées.
num_hidden_layers (`int`, *facultatif*, valeur par défaut `6`) : Nombre de couches cachées dans le décodeur Transformer.
num_attention_heads (`int`, *facultatif*, valeur par défaut `12`) : Nombre de têtes d'attention pour chaque couche d'attention du décodeur Transformer.
intermediate_size (`int`, *facultatif*, par défaut `3072`) : Dimension des représentations MLP.
hidden_act (`str`, *facultatif*, par défaut `gelu`) : La fonction d'activation non linéaire (fonction ou chaîne de caractères) dans le décodeur. Par exemple, `"gelu"`, `"relu"`, `"silu"`, etc.
hidden_dropout_prob (`Union[float, int]`, *facultatif*, valeur par défaut `0.1`) : La probabilité de dropout pour toutes les couches entièrement connectées des embeddings, de l'encodeur et du pooler.
attention_probs_dropout_prob (`Union[float, int]`, *facultatif*, valeur par défaut `0.1`) : Le taux de dropout appliqué aux probabilités d'attention.
max_position_embeddings (`int`, *facultatif*, valeur par défaut `1024`) : La longueur de séquence maximale avec laquelle ce modèle pourrait être utilisé.
initializer_range (`float`, *facultatif*, valeur par défaut `0.02`) : L'écart-type de la truncated_normal_initializer utilisé pour l'initialisation de toutes les matrices de poids.
layer_norm_eps (`float`, *facultatif*, par défaut `1e-12`) : L'épsilon utilisé par les couches de normalisation par couche.
pad_token_id (`int`, *facultatif*, valeur par défaut `0`) : Identifiant du jeton utilisé pour le bourrage dans le vocabulaire.
use_cache (`bool`, *facultatif*, valeur par défaut `True`) : Indique si le modèle doit retourner les dernières attentions clés/valeurs (non utilisé par tous les modèles). Pertinent uniquement si `config.is_decoder=True` ou si le modèle est un modèle génératif de type décodeur uniquement.
tie_word_embeddings (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut lier les embeddings de poids selon la correspondance `tied_weights_keys` du modèle.
bos_token_id (`int`, *facultatif*, valeur par défaut `101`) : Identifiant du jeton utilisé pour le début de flux dans le vocabulaire.
eos_token_id (`Union[int, list[int]]`, *facultatif*, valeur par défaut `102`) : Identifiant de jeton utilisé pour la fin de flux dans le vocabulaire.
num_image_with_embedding (`int`, *facultatif*) : Le nombre d'embeddings temporels à ajouter, si le modèle est utilisé pour la légende de vidéos/VQA.
Il s'agit de la classe de configuration destinée à stocker la configuration d'un GitModel. Elle est utilisée pour instancier un modèle Git en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [microsoft/git-base](https://huggingface.co/microsoft/git-base)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
Exemples :
```python
>>> from transformers import GitConfig, GitModel
>>> # Initializing a GIT microsoft/git-base style configuration
>>> configuration = GitConfig()
>>> # Initializing a model (with random weights) from the microsoft/git-base style configuration
>>> model = GitModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## GitProcessor[[transformers.GitProcessor]]
#### transformers.GitProcessor[[transformers.GitProcessor]]
```python
transformers.GitProcessor(image_processor, tokenizer)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/git/processing_git.py#L23)
**Paramètres :**
image_processor (`CLIPImageProcessor`) : le processeur d'images est une entrée obligatoire.
tokenizer (`BertTokenizer`) : le tokenizer est une entrée obligatoire.
Construit un GitProcessor qui encapsule un processeur d’images et un tokenizer en un seul processeur.
[GitProcessor](/docs/transformers/main/fr/model_doc/git#transformers.GitProcessor) offre toutes les fonctionnalités de [CLIPImageProcessor](/docs/transformers/main/fr/model_doc/clip#transformers.CLIPImageProcessor) et [BertTokenizer](/docs/transformers/main/fr/model_doc/lxmert#transformers.BertTokenizer). Consultez [~CLIPImageProcessor](/docs/transformers/main/fr/model_doc/clip#transformers.CLIPImageProcessor) et [~BertTokenizer](/docs/transformers/main/fr/model_doc/lxmert#transformers.BertTokenizer) pour plus d’informations.
#### __appel__[[transformers.GitProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L659)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *facultatif*) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *facultatif*) : La séquence ou le lot de séquences à encoder. Chaque séquence peut être une chaîne de caractères ou une liste de chaînes (chaîne pré-tokenisée). Si vous transmettez une entrée pré-tokenisée, définissez `is_split_into_words=True` pour éviter toute ambiguïté avec les entrées en lot.
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`, *facultatif*) : Vidéo à prétraiter. S'attend à une vidéo unique ou à un lot de vidéos dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des vidéos dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`, *facultatif*) : L'audio ou le lot d'audios à préparer. Chaque audio peut être un tableau NumPy ou un tenseur PyTorch. Dans le cas d'un tableau NumPy/d'un tenseur PyTorch, chaque audio doit avoir la forme (C, T), où C est le nombre de canaux et T est la longueur en échantillons de l'audio.
return_tensors (`str` ou [TensorType](/docs/transformers/main/fr/internal/file_utils#transformers.TensorType), *facultatif*) : Si défini, renverra des tenseurs d'un framework particulier. Les valeurs acceptables sont : - `'pt'` : Renvoie des objets `torch.Tensor` de PyTorch. - `'np'` : Renvoie des objets `np.ndarray` de NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/main/fr/main_classes/processors#transformers.ProcessingKwargs), *facultatif*) : Options de traitement supplémentaires pour chaque modalité (texte, images, vidéos, audio). Les paramètres spécifiques au modèle sont répertoriés ci-dessus ; consultez la classe TypedDict pour la liste complète des arguments pris en charge.
## GitModel[[transformers.GitModel]]
#### transformers.GitModel[[transformers.GitModel]]
```python
transformers.GitModel(config: GitConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/git/modeling_git.py#L707)
**Paramètres :**
config ([GitConfig](/docs/transformers/main/fr/model_doc/git#transformers.GitConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Le transformateur de modèle GIT brut, composé d'un encodeur d'images CLIP et d'un décodeur de texte, qui produit des états cachés bruts
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.GitModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, use_cache: bool | None = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/git/modeling_git.py#L738)
**Paramètres :**
input_ids (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices des jetons de la séquence d'entrée dans le vocabulaire. Le bourrage (padding) sera ignoré par défaut. Les indices peuvent être obtenus à l'aide de [AutoTokenizer](/docs/transformers/main/fr/model_doc/auto#transformers.AutoTokenizer). Consultez [PreTrainedTokenizer.encode()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) et [PreTrainedTokenizer.__call__()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) pour plus de détails. [Que sont les identifiants d'entrée ?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
position_ids (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices des positions des jetons de chaque séquence d'entrée dans les embeddings de position. Sélectionnés dans l'intervalle `[0, config.n_positions - 1]`. [Que sont les position IDs ?](../glossary#position-ids)
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d'entrée. Les valeurs de pixels peuvent être obtenues à l'aide de [CLIPImageProcessor](/docs/transformers/main/fr/model_doc/clip#transformers.CLIPImageProcessor). Voir [CLIPImageProcessor.__call__()](/docs/transformers/main/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails ([GitProcessor](/docs/transformers/main/fr/model_doc/git#transformers.GitProcessor) utilise [CLIPImageProcessor](/docs/transformers/main/fr/model_doc/clip#transformers.CLIPImageProcessor) pour le traitement des images).
inputs_embeds (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) : Facultativement, au lieu de passer `input_ids`, vous pouvez choisir de passer directement une représentation intégrée. Cela est utile si vous souhaitez un meilleur contrôle sur la manière de convertir les indices `input_ids` en vecteurs associés, par rapport à la matrice de recherche d'intégration interne du modèle.
past_key_values (`~cache_utils.Cache`, *facultatif*) : États cachés précalculés (clés et valeurs dans les blocs d'auto-attention et dans les blocs d'attention croisée) qui peuvent être utilisés pour accélérer le décodage séquentiel. Il s'agit généralement des `past_key_values` renvoyés par le modèle à une étape antérieure du décodage, lorsque `use_cache=True` ou `config.use_cache=True`. Seule une instance de [Cache](/docs/transformers/main/fr/internal/generation_utils#transformers.Cache) est autorisée en entrée, voir notre [guide sur le cache kv](https://huggingface.co/docs/transformers/en/kv_cache). Si aucun `past_key_values` n'est transmis, [DynamicCache](/docs/transformers/main/fr/internal/generation_utils#transformers.DynamicCache) est initialisé par défaut. Le modèle renverra le même format de cache que celui fourni en entrée. Si `past_key_values` sont utilisés, l'utilisateur doit fournir uniquement les `input_ids` non traités (ceux pour lesquels les états de clés et de valeurs passées ne sont pas fournis à ce modèle) de forme `(batch_size, unprocessed_length)` au lieu de tous les `input_ids` de forme `(batch_size, sequence_length)`.
use_cache (`bool`, *facultatif*) : Si défini sur `True`, les états clé-valeur de `past_key_values` sont renvoyés et peuvent être utilisés pour accélérer le décodage (voir `past_key_values`).
interpolate_pos_encoding (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut interpoler les encodages de position pré-entraînés.
**Retourne :** [BaseModelOutputWithPooling](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou `tuple(torch.Tensor)`
Un [BaseModelOutputWithPooling](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([GitConfig](/docs/transformers/main/fr/model_doc/git#transformers.GitConfig)) et les entrées.
La méthode forward de [GitModel](/docs/transformers/main/fr/model_doc/git#transformers.GitModel) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **last_hidden_state** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`) -- Séquence d'états cachés à la sortie de la dernière couche du modèle.
- **pooler_output** (`torch.Tensor` de forme `(batch_size, hidden_size)`) -- État caché de la dernière couche du premier jeton de la séquence (jeton de classification) après un traitement supplémentaire par les couches utilisées pour la tâche de pré-entraînement auxiliaire. Par exemple, pour les modèles de la famille BERT, cela renvoie le jeton de classification après traitement par une couche linéaire et une fonction d'activation tanh. Les poids de la couche linéaire sont entraînés à partir de l'objectif de prédiction de la phrase suivante (classification) pendant le pré-entraînement.
- **hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemples :
```python
>>> from transformers import AutoProcessor, AutoModel
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> processor = AutoProcessor.from_pretrained("microsoft/git-base")
>>> model = AutoModel.from_pretrained("microsoft/git-base")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "this is an image of two cats"
>>> inputs = processor(images=image, text=text, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
```
## GitForCausalLM[[transformers.GitForCausalLM]]
#### transformers.GitForCausalLM[[transformers.GitForCausalLM]]
```python
transformers.GitForCausalLM(config: GitConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/git/modeling_git.py#L890)
**Paramètres :**
config ([GitConfig](/docs/transformers/main/fr/model_doc/git#transformers.GitConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Modèle GIT avec une tête de `language modeling` au sommet pour la modélisation de langage autorégressive.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.GitForCausalLM.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, use_cache: bool | None = None, interpolate_pos_encoding: bool = False, logits_to_keep: typing.Union[int, torch.Tensor] = 0, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/git/modeling_git.py#L908)
**Paramètres :**
input_ids (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices des jetons de la séquence d'entrée dans le vocabulaire. Le bourrage (padding) sera ignoré par défaut. Les indices peuvent être obtenus à l'aide de [AutoTokenizer](/docs/transformers/main/fr/model_doc/auto#transformers.AutoTokenizer). Consultez [PreTrainedTokenizer.encode()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) et [PreTrainedTokenizer.__call__()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) pour plus de détails. [Que sont les identifiants d'entrée ?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
position_ids (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices des positions des jetons de chaque séquence d'entrée dans les embeddings de position. Sélectionnés dans l'intervalle `[0, config.n_positions - 1]`. [Que sont les position IDs ?](../glossary#position-ids)
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d'entrée. Les valeurs de pixels peuvent être obtenues à l'aide de [CLIPImageProcessor](/docs/transformers/main/fr/model_doc/clip#transformers.CLIPImageProcessor). Voir [CLIPImageProcessor.__call__()](/docs/transformers/main/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails ([GitProcessor](/docs/transformers/main/fr/model_doc/git#transformers.GitProcessor) utilise [CLIPImageProcessor](/docs/transformers/main/fr/model_doc/clip#transformers.CLIPImageProcessor) pour le traitement des images).
inputs_embeds (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) : Facultativement, au lieu de passer `input_ids`, vous pouvez choisir de passer directement une représentation intégrée. Cela est utile si vous souhaitez un meilleur contrôle sur la manière de convertir les indices `input_ids` en vecteurs associés, par rapport à la matrice de recherche d'intégration interne du modèle.
labels (`torch.LongTensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Étiquettes pour le calcul de la perte de modélisation du langage de gauche à droite (prédiction du mot suivant). Les indices doivent être dans `[-100, 0, ..., config.vocab_size]` (voir la docstring de `input_ids`). Les jetons dont l'indice est défini sur `-100` sont ignorés (masqués) ; la perte n'est calculée que pour les jetons dont l'étiquette est dans `[0, ..., config.vocab_size]`.
past_key_values (`~cache_utils.Cache`, *facultatif*) : États cachés précalculés (clés et valeurs dans les blocs d'auto-attention et dans les blocs d'attention croisée) qui peuvent être utilisés pour accélérer le décodage séquentiel. Il s'agit généralement des `past_key_values` renvoyés par le modèle à une étape antérieure du décodage, lorsque `use_cache=True` ou `config.use_cache=True`. Seule une instance de [Cache](/docs/transformers/main/fr/internal/generation_utils#transformers.Cache) est autorisée en entrée, voir notre [guide sur le cache kv](https://huggingface.co/docs/transformers/en/kv_cache). Si aucun `past_key_values` n'est transmis, [DynamicCache](/docs/transformers/main/fr/internal/generation_utils#transformers.DynamicCache) est initialisé par défaut. Le modèle renverra le même format de cache que celui fourni en entrée. Si `past_key_values` sont utilisés, l'utilisateur doit fournir uniquement les `input_ids` non traités (ceux pour lesquels les états de clés et de valeurs passées ne sont pas fournis à ce modèle) de forme `(batch_size, unprocessed_length)` au lieu de tous les `input_ids` de forme `(batch_size, sequence_length)`.
use_cache (`bool`, *facultatif*) : Si défini sur `True`, les états clé-valeur de `past_key_values` sont renvoyés et peuvent être utilisés pour accélérer le décodage (voir `past_key_values`).
interpolate_pos_encoding (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut interpoler les encodages de position pré-entraînés.
logits_to_keep (`Union[int, torch.Tensor]`, *facultatif*, valeur par défaut `0`) : Si c'est un `int`, calcule les logits pour les `logits_to_keep` derniers jetons. Si c'est `0`, calcule les logits pour tous les `input_ids` (cas particulier). Seuls les logits du dernier jeton sont nécessaires pour la génération, et les calculer uniquement pour ce jeton peut faire économiser de la mémoire, ce qui devient assez significatif pour les séquences longues ou les tailles de vocabulaire importantes. Si c'est un `torch.Tensor`, il doit être 1D et correspondre aux indices à conserver dans la dimension de la longueur de la séquence. C'est utile lors de l'utilisation du format de tenseurs empilés (une seule dimension pour le lot et la longueur de la séquence).
**Retourne :** [CausalLMOutputWithPast](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.CausalLMOutputWithPast) ou `tuple(torch.Tensor)`
Un [CausalLMOutputWithPast](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.CausalLMOutputWithPast) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments en fonction de la configuration ([GitConfig](/docs/transformers/main/fr/model_doc/git#transformers.GitConfig)) et des entrées.
La méthode forward de [GitForCausalLM](/docs/transformers/main/fr/model_doc/git#transformers.GitForCausalLM) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **loss** (`torch.Tensor` de forme `(1,)`, *facultatif*, renvoyé lorsque `labels` est fourni) -- Perte de modélisation du langage (pour la prédiction du jeton suivant).
- **logits** (`torch.Tensor` de forme `(batch_size, sequence_length, config.vocab_size)`) -- Scores de prédiction de la tête de modélisation du langage (scores pour chaque jeton du vocabulaire avant SoftMax).
- **past_key_values** (`Cache`, *facultatif*, renvoyé lorsque `use_cache=True` est passé ou lorsque `config.use_cache=True`) -- Il s'agit d'une instance de [Cache](/docs/transformers/main/fr/internal/generation_utils#transformers.Cache). Pour plus de détails, consultez notre [guide sur le cache kv](https://huggingface.co/docs/transformers/en/kv_cache).
Contient des états cachés précalculés (clés et valeurs dans les blocs d'auto-attention) qui peuvent être utilisés (voir l'entrée `past_key_values`) pour accélérer le décodage séquentiel.
- **hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemples :
Exemple de légende d’image :
```python
>>> from transformers import AutoProcessor, AutoModelForCausalLM
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> processor = AutoProcessor.from_pretrained("microsoft/git-base-coco")
>>> model = AutoModelForCausalLM.from_pretrained("microsoft/git-base-coco")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> pixel_values = processor(images=image, return_tensors="pt").pixel_values
>>> generated_ids = model.generate(pixel_values=pixel_values, max_length=50)
>>> generated_caption = processor.batch_decode(generated_ids, skip_special_tokens=True)[0]
>>> print(generated_caption)
two cats sleeping on a pink blanket next to remotes.
```
Exemple de question-réponse visuelle (VQA) :
```python
>>> from transformers import AutoProcessor, AutoModelForCausalLM
>>> from huggingface_hub import hf_hub_download
>>> from PIL import Image
>>> processor = AutoProcessor.from_pretrained("microsoft/git-base-textvqa")
>>> model = AutoModelForCausalLM.from_pretrained("microsoft/git-base-textvqa")
>>> file_path = hf_hub_download(repo_id="nielsr/textvqa-sample", filename="bus.png", repo_type="dataset")
>>> image = Image.open(file_path).convert("RGB")
>>> pixel_values = processor(images=image, return_tensors="pt").pixel_values
>>> question = "what does the front of the bus say at the top?"
>>> input_ids = processor(text=question, add_special_tokens=False).input_ids
>>> input_ids = [processor.tokenizer.cls_token_id] + input_ids
>>> input_ids = torch.tensor(input_ids).unsqueeze(0)
>>> generated_ids = model.generate(pixel_values=pixel_values, input_ids=input_ids, max_length=50)
>>> print(processor.batch_decode(generated_ids, skip_special_tokens=True))
['what does the front of the bus say at the top? special']
```
Exemple de légende de vidéo :
```python
>>> import av
>>> import numpy as np
>>> from PIL import Image
>>> from huggingface_hub import hf_hub_download
>>> from transformers import AutoProcessor, AutoModelForCausalLM
>>> processor = AutoProcessor.from_pretrained("microsoft/git-base-vatex")
>>> model = AutoModelForCausalLM.from_pretrained("microsoft/git-base-vatex")
>>> # set seed for reproducibility
>>> np.random.seed(45)
>>> def read_video_pyav(container, indices):
... '''
... Decode the video with PyAV decoder.
... Args:
... container (`av.container.input.InputContainer`): PyAV container.
... indices (`list[int]`): List of frame indices to decode.
... Returns:
... result (np.ndarray): np array of decoded frames of shape (num_frames, height, width, 3).
... '''
... frames = []
... container.seek(0)
... start_index = indices[0]
... end_index = indices[-1]
... for i, frame in enumerate(container.decode(video=0)):
... if i > end_index:
... break
... if i >= start_index and i in indices:
... frames.append(frame)
... return np.stack([x.to_ndarray(format="rgb24") for x in frames])
>>> def sample_frame_indices(clip_len, frame_sample_rate, seg_len):
... '''
... Sample a given number of frame indices from the video.
... Args:
... clip_len (`int`): Total number of frames to sample.
... frame_sample_rate (`int`): Sample every n-th frame.
... seg_len (`int`): Maximum allowed index of sample's last frame.
... Returns:
... indices (`list[int]`): List of sampled frame indices
... '''
... converted_len = int(clip_len * frame_sample_rate)
... end_idx = np.random.randint(converted_len, seg_len)
... start_idx = end_idx - converted_len
... indices = np.linspace(start_idx, end_idx, num=clip_len)
... indices = np.clip(indices, start_idx, end_idx - 1).astype(np.int64)
... return indices
>>> # load video
>>> file_path = hf_hub_download(
... repo_id="nielsr/video-demo", filename="eating_spaghetti.mp4", repo_type="dataset"
... )
>>> container = av.open(file_path)
>>> # sample frames
>>> num_frames = model.config.num_image_with_embedding
>>> indices = sample_frame_indices(
... clip_len=num_frames, frame_sample_rate=4, seg_len=container.streams.video[0].frames
... )
>>> frames = read_video_pyav(container, indices)
>>> pixel_values = processor(images=list(frames), return_tensors="pt").pixel_values
>>> generated_ids = model.generate(pixel_values=pixel_values, max_length=50)
>>> print("Generated caption:", processor.batch_decode(generated_ids, skip_special_tokens=True))
Generated caption: ['a woman is sitting at a table and she is talking about the food she is holding.']
```