# Grounding DINO
## Aperçu
Le modèle Grounding DINO a été proposé dans [Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection](https://huggingface.co/papers/2303.05499) par Shilong Liu, Zhaoyang Zeng, Tianhe Ren, Feng Li, Hao Zhang, Jie Yang, Chunyuan Li, Jianwei Yang, Hang Su, Jun Zhu, Lei Zhang. Grounding DINO étend un modèle de détection d'objets en ensemble fermé avec un encodeur de texte, permettant ainsi la détection d'objets en ensemble ouvert. Le modèle obtient des résultats remarquables, tels que 52,5 AP sur COCO en zéro-shot.
L'abstract de l'article est le suivant :
*Dans cet article, nous présentons un détecteur d'objets en jeu ouvert, appelé Grounding DINO, qui combine le détecteur basé sur les Transformers, DINO, avec un pré-entraînement ancré, permettant de détecter des objets arbitraires à partir d'entrées humaines telles que des noms de catégories ou des expressions référentielles. La solution clé de la détection d'objets en jeu ouvert consiste à introduire le langage dans un détecteur en jeu fermé pour une généralisation des concepts en jeu ouvert. Pour fusionner efficacement les modalités langage et vision, nous divisons conceptuellement un détecteur en jeu fermé en trois phases et proposons une solution de fusion étroite, qui comprend un amplificateur de caractéristiques, une sélection de requêtes guidée par le langage et un décodeur inter-modalités pour la fusion inter-modalités. Alors que les travaux précédents évaluent principalement la détection d'objets en jeu ouvert sur de nouvelles catégories, nous proposons d'évaluer également la compréhension des expressions référentielles pour des objets spécifiés par des attributs. Grounding DINO obtient des résultats remarquables dans les trois configurations, y compris sur les benchmarks COCO, LVIS, ODinW et RefCOCO/+/g. Grounding DINO atteint un AP de 52,5 sur le benchmark de transfert zéro-shot de détection COCO, c'est-à-dire sans aucune donnée d'entraînement provenant de COCO. Il établit un nouveau record sur le benchmark zéro-shot ODinW avec un AP moyen de 26,1.*
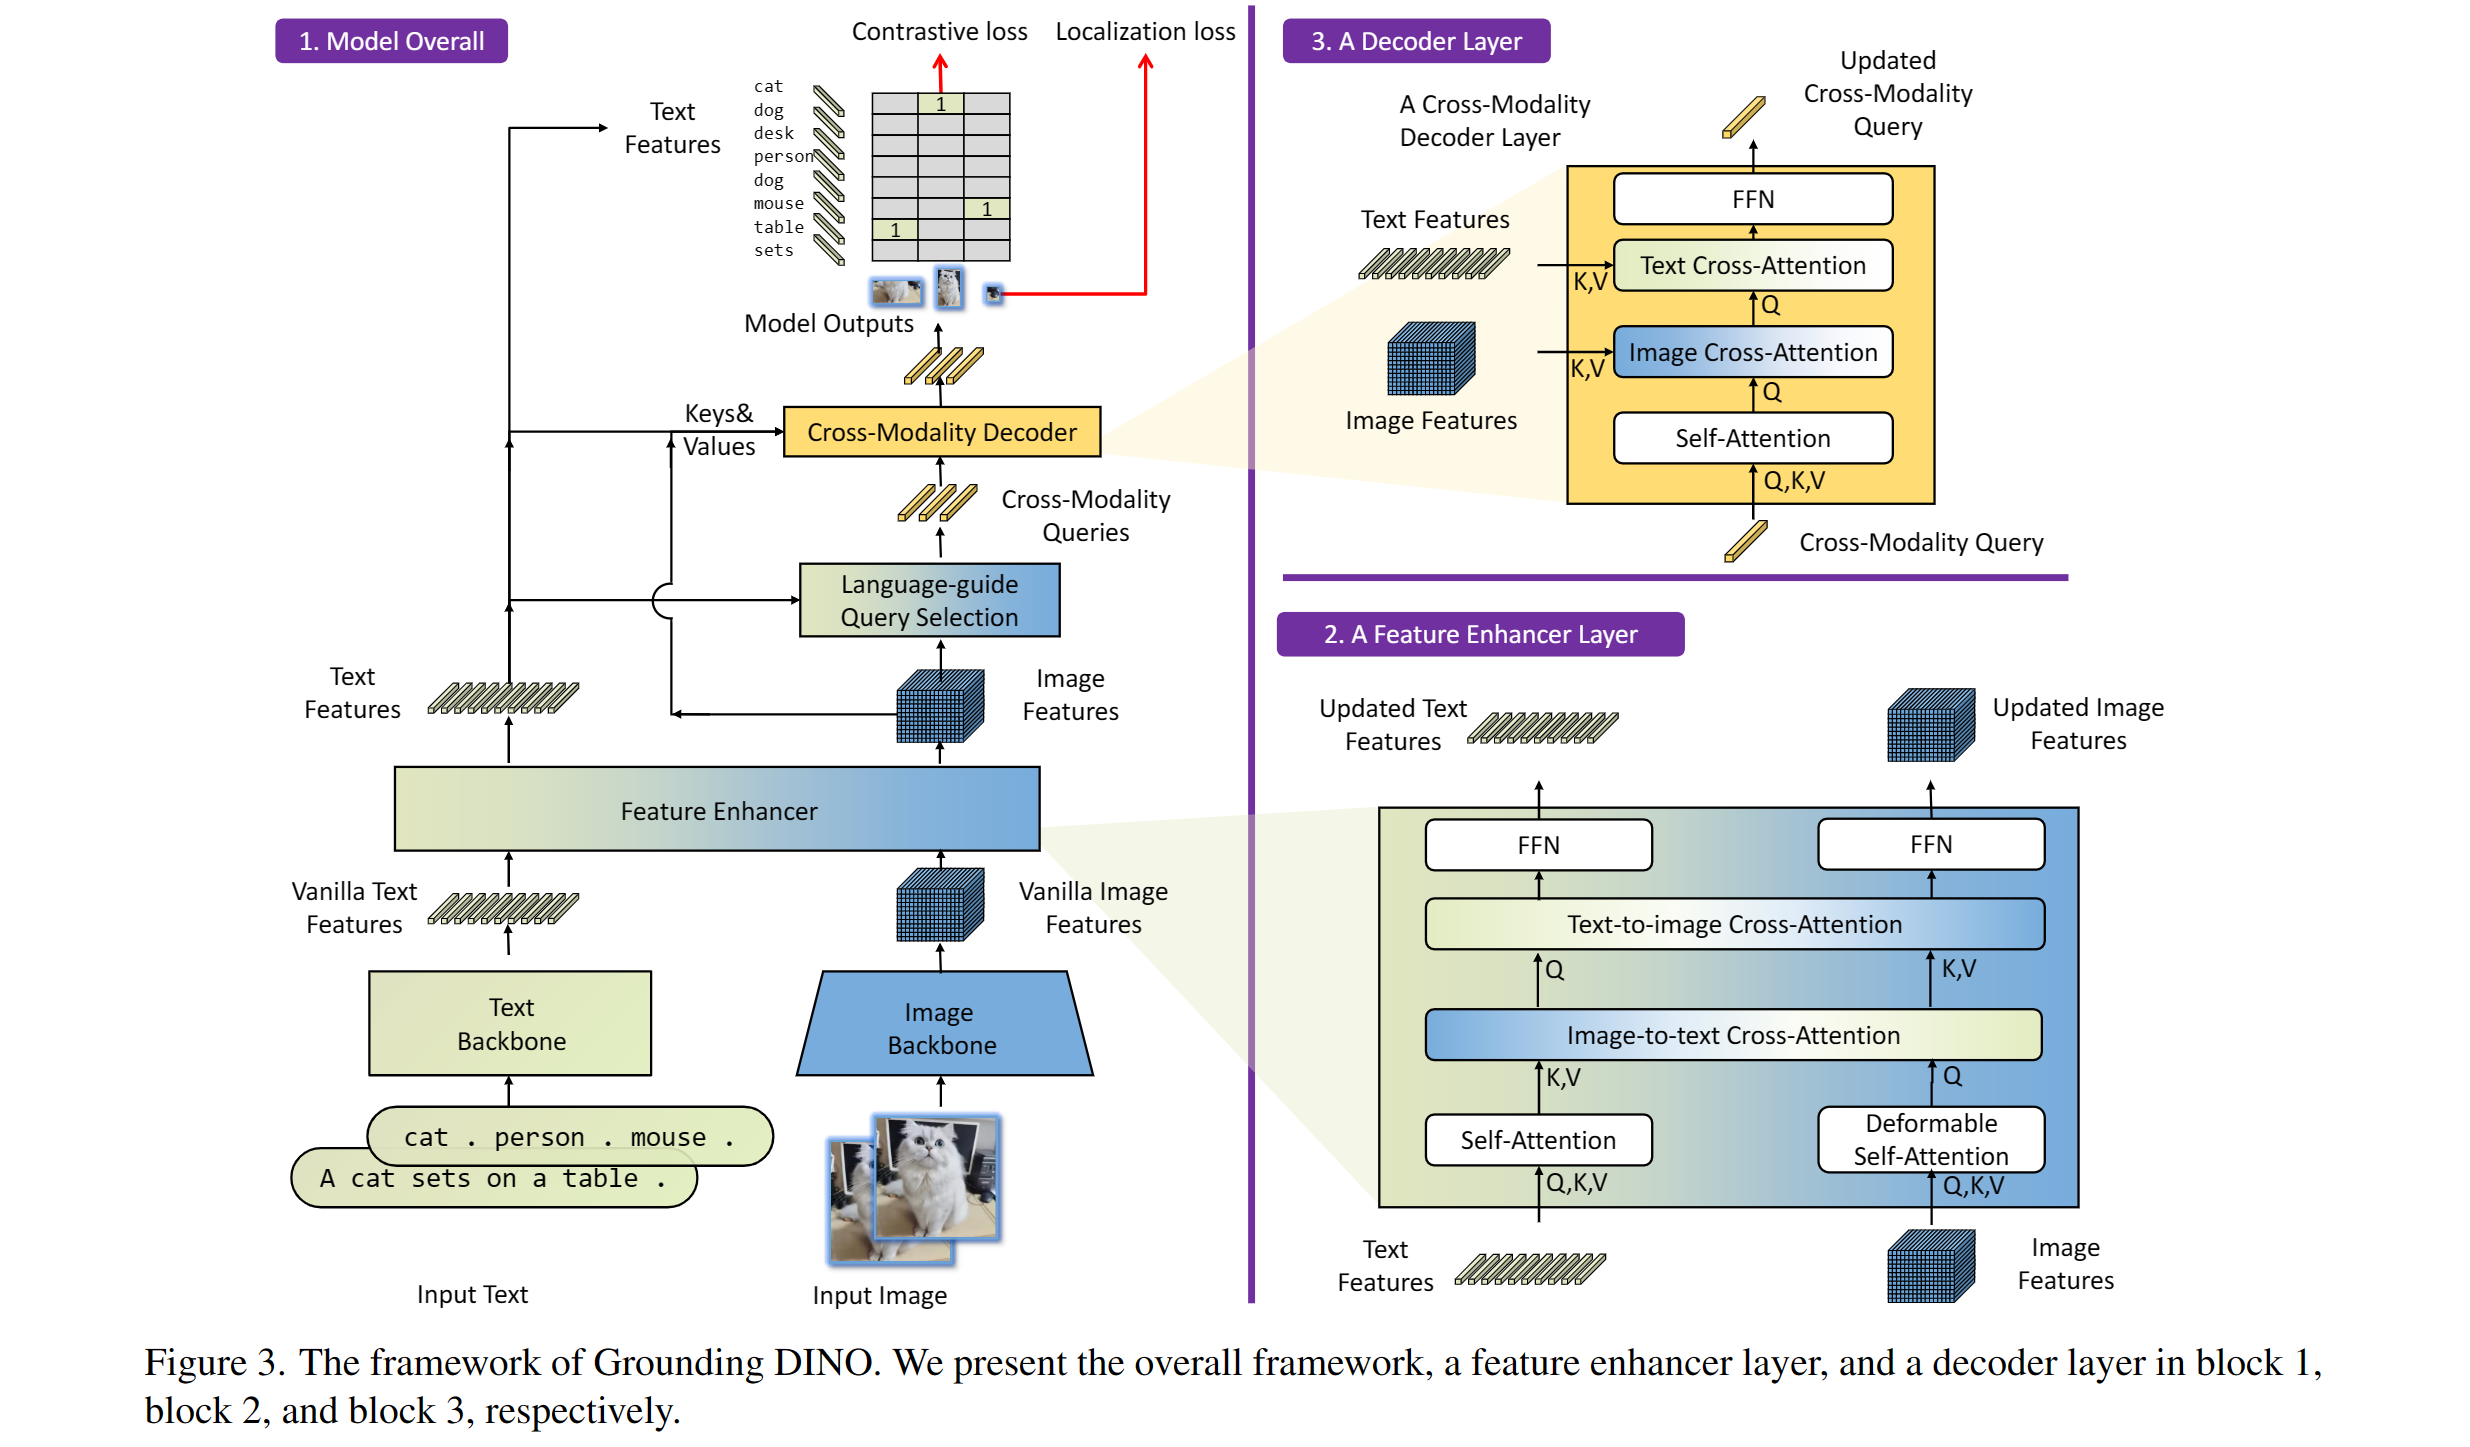 Aperçu de Grounding DINO. Tiré de l'article original.
Ce modèle a été contribué par [EduardoPacheco](https://huggingface.co/EduardoPacheco) et [nielsr](https://huggingface.co/nielsr). Le code d'origine peut être trouvé [ici](https://github.com/IDEA-Research/GroundingDINO).
## Conseils d'utilisation
- On peut utiliser [GroundingDinoProcessor](/docs/transformers/main/fr/model_doc/grounding-dino#transformers.GroundingDinoProcessor) pour préparer des paires image-texte pour le modèle.
- Pour séparer les classes dans le texte, utilisez un point, par exemple "a cat. a dog."
- Lors de l’utilisation de plusieurs classes (par exemple `"a cat. a dog."`), utilisez `post_process_grounded_object_detection` de [GroundingDinoProcessor](/docs/transformers/main/fr/model_doc/grounding-dino#transformers.GroundingDinoProcessor) pour post-traiter les sorties. En effet, les étiquettes renvoyées par `post_process_object_detection` représentent les indices de la dimension du modèle où prob > threshold.
Voici comment utiliser le modèle pour la détection d'objets en zéro tirage :
```python
import requests
import torch
from PIL import Image
from transformers import AutoProcessor, AutoModelForZeroShotObjectDetection
model_id = "IDEA-Research/grounding-dino-tiny"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForZeroShotObjectDetection.from_pretrained(model_id, device_map="auto")
image_url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(image_url, stream=True).raw)
# Check for cats and remote controls
text_labels = [["a cat", "a remote control"]]
inputs = processor(images=image, text=text_labels, return_tensors="pt").to(model.device)
with torch.no_grad():
outputs = model(**inputs)
results = processor.post_process_grounded_object_detection(
outputs,
inputs.input_ids,
threshold=0.4,
text_threshold=0.3,
target_sizes=[image.size[::-1]]
)
# Retrieve the first image result
result = results[0]
for box, score, labels in zip(result["boxes"], result["scores"], result["labels"]):
box = [round(x, 2) for x in box.tolist()]
print(f"Detected {labels} with confidence {round(score.item(), 3)} at location {box}")
Detected a cat with confidence 0.468 at location [344.78, 22.9, 637.3, 373.62]
Detected a cat with confidence 0.426 at location [11.74, 51.55, 316.51, 473.22]
```
## Grounded SAM
Il est possible de combiner Grounding DINO avec le modèle [Segment Anything](sam) pour la génération de masques basée sur le texte, comme introduit dans [Grounded SAM: Assembling Open-World Models for Diverse Visual Tasks](https://huggingface.co/papers/2401.14159). Vous pouvez consulter ce [carnet de démonstration](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/Grounding%20DINO/GroundingDINO_with_Segment_Anything.ipynb) 🌍 pour plus de détails.
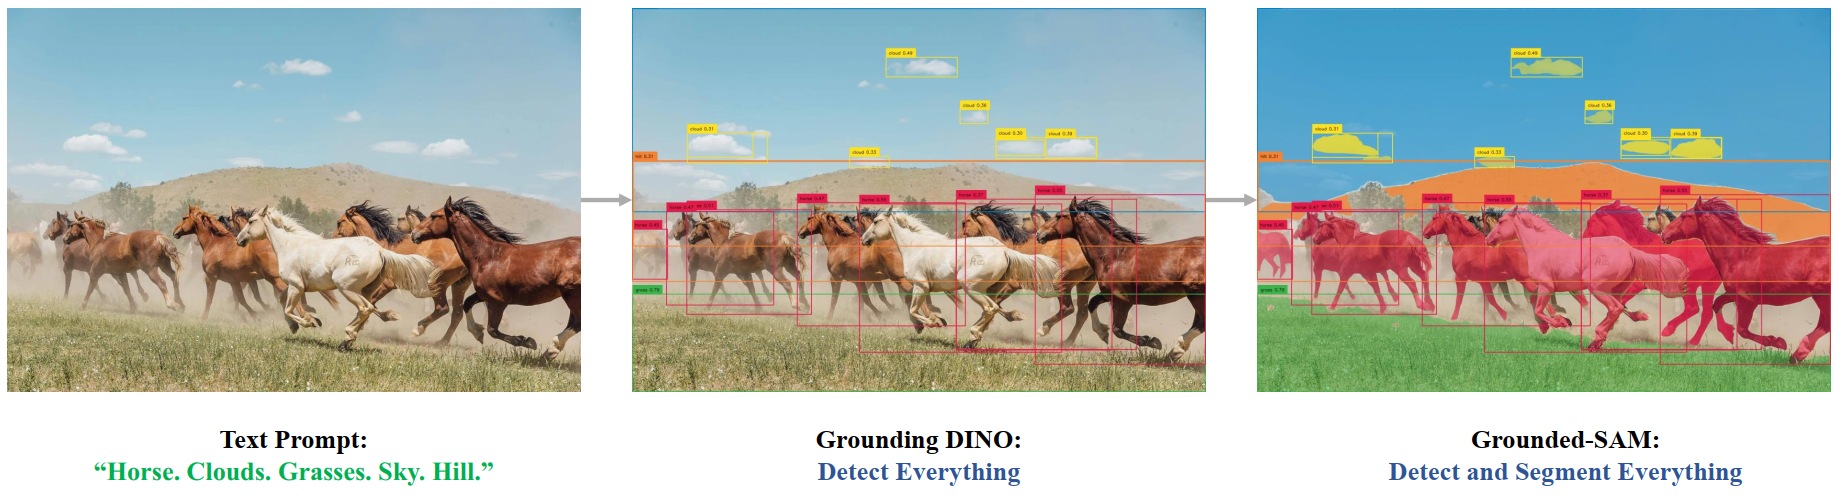 Aperçu de Grounded SAM. Extrait du dépôt d'origine.
## Ressources
Une liste de ressources officielles Hugging Face et de la communauté (indiquées par 🌎) pour vous aider à démarrer avec Grounding DINO. Si vous souhaitez soumettre une ressource pour qu'elle soit incluse ici, n'hésitez pas à ouvrir une Pull Request et nous la examinerons ! La ressource devrait idéalement démontrer quelque chose de nouveau plutôt que de dupliquer une ressource existante.
- Des notebooks de démonstration concernant l'inférence avec Grounding DINO ainsi que sa combinaison avec [SAM](sam) sont disponibles [ici](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Grounding%20DINO). 🌎
## GroundingDinoImageProcessor[[transformers.GroundingDinoImageProcessor]]
#### transformers.GroundingDinoImageProcessor[[transformers.GroundingDinoImageProcessor]]
```python
transformers.GroundingDinoImageProcessor(**kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/image_processing_grounding_dino.py#L308)
**Paramètres :**
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'shortest_edge' : 800, 'longest_edge': 1333}`) : Décrit les dimensions d'entrée maximales pour le modèle.
default_to_square (`bool`, *kwargs*, *facultatif*, valeur par défaut `False`) : Indique s'il faut par défaut redimensionner l'image en un carré si la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, par défaut `2`) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*, valeur par défaut `0.00392156862745098`) : Facteur de remise à l'échelle appliqué à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.485, 0.456, 0.406]`) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.229, 0.224, 0.225]`) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
format (`str`, *kwargs*, *facultatif*, par défaut `AnnotationFormat.COCO_DETECTION`) : Format des données des annotations. L'une des valeurs "coco_detection" ou "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut convertir les annotations au format attendu par le modèle GROUNDING_DINO. Convertit les boîtes englobantes au format `(center_x, center_y, width, height)` et dans l'intervalle `[0, 1]`. Peut être remplacé par le paramètre `do_convert_annotations` de la méthode `preprocess`.
Construit un processeur d’image GroundingDinoImageProcessor.
#### prétraiter[[transformers.GroundingDinoImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = None, return_segmentation_masks: bool | None = None, masks_path: str | pathlib.Path | None = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/image_processing_grounding_dino.py#L563)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
annotations (`AnnotationType` ou `list[AnnotationType]`, *facultatif*) : Annotations à transformer en fonction du bourrage appliqué aux images.
return_segmentation_masks (`bool`, *facultatif*, par défaut `self.return_segmentation_masks`) : Indique s'il faut retourner les masques de segmentation.
masks_path (`str` ou `pathlib.Path`, *facultatif*) : Chemin vers le répertoire contenant les masques de segmentation.
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*) : Indique s'il faut par défaut redimensionner l'image en un carré lorsque la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*) : Facteur de redimensionnement à appliquer à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
format (`str`, *kwargs*, *facultatif*, par défaut `AnnotationFormat.COCO_DETECTION`) : Format des données des annotations. L'une des valeurs "coco_detection" ou "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut convertir les annotations au format attendu par le modèle GROUNDING_DINO. Convertit les boîtes englobantes au format `(center_x, center_y, width, height)` et dans l'intervalle `[0, 1]`. Peut être remplacé par le paramètre `do_convert_annotations` de la méthode `preprocess`.
**Retourne :** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode __call__ (« pixel_values », etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *facultatif*) -- Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
## GroundingDinoImageProcessorPil[[transformers.GroundingDinoImageProcessorPil]]
#### transformers.GroundingDinoImageProcessorPil[[transformers.GroundingDinoImageProcessorPil]]
```python
transformers.GroundingDinoImageProcessorPil(**kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/image_processing_pil_grounding_dino.py#L300)
**Paramètres :**
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'shortest_edge' : 800, 'longest_edge': 1333}`) : Décrit les dimensions d'entrée maximales pour le modèle.
default_to_square (`bool`, *kwargs*, *facultatif*, valeur par défaut `False`) : Indique s'il faut par défaut redimensionner l'image en un carré si la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, par défaut `2`) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*, valeur par défaut `0.00392156862745098`) : Facteur de remise à l'échelle appliqué à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.485, 0.456, 0.406]`) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.229, 0.224, 0.225]`) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
format (`str`, *kwargs*, *facultatif*, par défaut `AnnotationFormat.COCO_DETECTION`) : Format des données des annotations. L'une des valeurs "coco_detection" ou "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut convertir les annotations au format attendu par le modèle GROUNDING_DINO. Convertit les boîtes englobantes au format `(center_x, center_y, width, height)` et dans l'intervalle `[0, 1]`. Peut être remplacé par le paramètre `do_convert_annotations` de la méthode `preprocess`.
Construit un processeur d’image GroundingDinoImageProcessor.
#### prétraiter[[transformers.GroundingDinoImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = None, return_segmentation_masks: bool | None = None, masks_path: str | pathlib.Path | None = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/image_processing_pil_grounding_dino.py#L568)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
annotations (`AnnotationType` ou `list[AnnotationType]`, *facultatif*) : Annotations à transformer en fonction du bourrage appliqué aux images.
return_segmentation_masks (`bool`, *facultatif*, par défaut `self.return_segmentation_masks`) : Indique s'il faut retourner les masques de segmentation.
masks_path (`str` ou `pathlib.Path`, *facultatif*) : Chemin vers le répertoire contenant les masques de segmentation.
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*) : Indique s'il faut par défaut redimensionner l'image en un carré lorsque la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*) : Facteur de redimensionnement à appliquer à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
format (`str`, *kwargs*, *facultatif*, par défaut `AnnotationFormat.COCO_DETECTION`) : Format des données des annotations. L'une des valeurs "coco_detection" ou "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut convertir les annotations au format attendu par le modèle GROUNDING_DINO. Convertit les boîtes englobantes au format `(center_x, center_y, width, height)` et dans l'intervalle `[0, 1]`. Peut être remplacé par le paramètre `do_convert_annotations` de la méthode `preprocess`.
**Retourne :** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode __call__ (« pixel_values », etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *facultatif*) -- Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
#### post_process_object_detection[[transformers.GroundingDinoImageProcessorPil.post_process_object_detection]]
```python
post_process_object_detection(outputs: GroundingDinoObjectDetectionOutput, threshold: float = 0.1, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/image_processing_pil_grounding_dino.py#L713)
**Paramètres :**
outputs (`GroundingDinoObjectDetectionOutput`) : Sorties brutes du modèle.
threshold (`float`, *facultatif*, valeur par défaut 0,1) : Seuil de score à appliquer pour conserver les prédictions de détection d'objets.
target_sizes (`torch.Tensor` ou `list[tuple[int, int]]`, *facultatif*) : Tenseur de forme `(batch_size, 2)` ou liste de tuples (`tuple[int, int]`) contenant la taille cible `(height, width)` de chaque image du lot. Si non défini, les prédictions ne seront pas redimensionnées.
**Retourne :** `list[Dict]`
Une liste de dictionnaires, chaque dictionnaire contenant les clés suivantes :
- "scores" : les scores de confiance pour chaque boîte prédite sur l'image.
- "labels" : Index des classes prédites par le modèle sur l'image.
- "boxes" : Boîtes englobantes de l'image au format (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
Convertit la sortie brute de [GroundingDinoForObjectDetection](/docs/transformers/main/fr/model_doc/grounding-dino#transformers.GroundingDinoForObjectDetection) en boîtes englobantes finales au format (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
## GroundingDinoProcessor[[transformers.GroundingDinoProcessor]]
#### transformers.GroundingDinoProcessor[[transformers.GroundingDinoProcessor]]
```python
transformers.GroundingDinoProcessor(image_processor, tokenizer)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/processing_grounding_dino.py#L115)
**Paramètres :**
image_processor (`GroundingDinoImageProcessor`) : le processeur d'images est une entrée obligatoire.
tokenizer (`BertTokenizer`) : le tokenizer est une entrée obligatoire.
Construit un GroundingDinoProcessor qui encapsule un processeur d’images et un tokeniseur en un seul processeur.
[GroundingDinoProcessor](/docs/transformers/main/fr/model_doc/grounding-dino#transformers.GroundingDinoProcessor) offre toutes les fonctionnalités de [GroundingDinoImageProcessor](/docs/transformers/main/fr/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor) et de [BertTokenizer](/docs/transformers/main/fr/model_doc/lxmert#transformers.BertTokenizer). Consultez [~GroundingDinoImageProcessor](/docs/transformers/main/fr/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor) et [~BertTokenizer](/docs/transformers/main/fr/model_doc/lxmert#transformers.BertTokenizer) pour plus d’informations.
#### __appel__[[transformers.GroundingDinoProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L659)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *facultatif*) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *facultatif*) : La séquence ou le lot de séquences à encoder. Chaque séquence peut être une chaîne de caractères ou une liste de chaînes (chaîne pré-tokenisée). Si vous transmettez une entrée pré-tokenisée, définissez `is_split_into_words=True` pour éviter toute ambiguïté avec les entrées en lot.
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`, *facultatif*) : Vidéo à prétraiter. S'attend à une vidéo unique ou à un lot de vidéos dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des vidéos dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`, *facultatif*) : L'audio ou le lot d'audios à préparer. Chaque audio peut être un tableau NumPy ou un tenseur PyTorch. Dans le cas d'un tableau NumPy/d'un tenseur PyTorch, chaque audio doit avoir la forme (C, T), où C est le nombre de canaux et T est la longueur en échantillons de l'audio.
return_tensors (`str` ou [TensorType](/docs/transformers/main/fr/internal/file_utils#transformers.TensorType), *facultatif*) : Si défini, renverra des tenseurs d'un framework particulier. Les valeurs acceptables sont : - `'pt'` : Renvoie des objets `torch.Tensor` de PyTorch. - `'np'` : Renvoie des objets `np.ndarray` de NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/main/fr/main_classes/processors#transformers.ProcessingKwargs), *facultatif*) : Options de traitement supplémentaires pour chaque modalité (texte, images, vidéos, audio). Les paramètres spécifiques au modèle sont répertoriés ci-dessus ; consultez la classe TypedDict pour la liste complète des arguments pris en charge.
#### post_process_grounded_object_detection[[transformers.GroundingDinoProcessor.post_process_grounded_object_detection]]
```python
post_process_grounded_object_detection(outputs: GroundingDinoObjectDetectionOutput, input_ids: transformers.utils.generic.TensorType | None = None, threshold: float = 0.25, text_threshold: float = 0.25, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None, text_labels: list[list[str]] | None = None)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/processing_grounding_dino.py#L143)
**Paramètres :**
outputs (`GroundingDinoObjectDetectionOutput`) : Sorties brutes du modèle.
input_ids (`torch.LongTensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Les identifiants de jetons du texte d'entrée. S'ils ne sont pas fournis, ils seront pris depuis la sortie du modèle.
threshold (`float`, *facultatif*, valeur par défaut 0,25) : Seuil à appliquer pour conserver les prédictions de détection d'objets en fonction du score de confiance.
text_threshold (`float`, *facultatif*, valeur par défaut 0,25) : Seuil de score pour conserver les prédictions de détection de texte.
target_sizes (`torch.Tensor` ou `list[tuple[int, int]]`, *facultatif*) : Tenseur de forme `(batch_size, 2)` ou liste de tuples (`tuple[int, int]`) contenant la taille cible `(height, width)` de chaque image du lot. Si non défini, les prédictions ne seront pas redimensionnées.
text_labels (`list[list[str]]`, *facultatif*) : Liste des étiquettes candidates à détecter sur chaque image. Pour le moment, elle n'*est PAS utilisée*, mais elle est requise dans la signature du pipeline de détection d'objets zéro-shot. Les étiquettes textuelles sont plutôt extraites du tenseur `input_ids` fourni dans `outputs`.
**Retourne :** `list[Dict]`
Une liste de dictionnaires, chaque dictionnaire contenant
- **scores** : tenseur des scores de confiance pour les objets détectés
- **boxes** : tenseur de boîtes englobantes au format [x0, y0, x1, y1]
- **labels** : liste des étiquettes de texte pour chaque objet détecté (seront remplacées par des identifiants entiers dans la v4.51.0)
- **text_labels** : liste des étiquettes de texte pour les objets détectés
Convertit la sortie brute de [GroundingDinoForObjectDetection](/docs/transformers/main/fr/model_doc/grounding-dino#transformers.GroundingDinoForObjectDetection) en boîtes englobantes finales au format (top_left_x, top_left_y, bottom_right_x, bottom_right_y) et récupère l'étiquette de texte associée.
## GroundingDinoConfig[[transformers.GroundingDinoConfig]]
#### transformers.GroundingDinoConfig[[transformers.GroundingDinoConfig]]
```python
transformers.GroundingDinoConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, is_encoder_decoder: bool = True, backbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, num_queries: int = 900, encoder_layers: int = 6, encoder_ffn_dim: int = 2048, encoder_attention_heads: int = 8, decoder_layers: int = 6, decoder_ffn_dim: int = 2048, decoder_attention_heads: int = 8, activation_function: str = 'relu', d_model: int = 256, dropout: float | int = 0.1, attention_dropout: float | int = 0.0, activation_dropout: float | int = 0.0, auxiliary_loss: bool = False, position_embedding_type: str = 'sine', num_feature_levels: int = 4, encoder_n_points: int = 4, decoder_n_points: int = 4, two_stage: bool = True, class_cost: float = 1.0, bbox_cost: float = 5.0, giou_cost: float = 2.0, bbox_loss_coefficient: float = 5.0, giou_loss_coefficient: float = 2.0, focal_alpha: float = 0.25, disable_custom_kernels: bool = False, max_text_len: int = 256, text_enhancer_dropout: float | int = 0.0, fusion_droppath: float | int = 0.1, fusion_dropout: float | int = 0.0, embedding_init_target: bool = True, query_dim: int = 4, decoder_bbox_embed_share: bool = True, two_stage_bbox_embed_share: bool = False, positional_embedding_temperature: int = 20, init_std: float = 0.02, layer_norm_eps: float = 1e-05, tie_word_embeddings: bool = True)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/configuration_grounding_dino.py#L28)
**Paramètres :**
is_encoder_decoder (`bool`, *facultatif*, valeur par défaut `True`) : Indique si le modèle est utilisé comme encodeur/décodeur ou non.
backbone_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *facultatif*) : La configuration du modèle de base.
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *facultatif*) : L'objet de configuration ou le dictionnaire du backbone de texte.
num_queries (`int`, *facultatif*, valeur par défaut 900) : Nombre de requêtes d'objets, c'est-à-dire de slots de détection. C'est le nombre maximal d'objets que [GroundingDinoModel](/docs/transformers/main/fr/model_doc/grounding-dino#transformers.GroundingDinoModel) peut détecter dans une image unique.
encoder_layers (`int`, *facultatif*, valeur par défaut `6`) : Nombre de couches cachées dans l'encodeur Transformer. Utilise la même valeur que `num_layers` si non défini.
encoder_ffn_dim (`int`, *facultatif*, valeur par défaut `2048`) : Dimension de la couche « intermédiaire » (souvent appelée couche feed-forward) dans l'encodeur.
encoder_attention_heads (`int`, *facultatif*, valeur par défaut `8`) : Nombre de têtes d'attention pour chaque couche d'attention dans l'encodeur Transformer.
decoder_layers (`int`, *facultatif*, valeur par défaut `6`) : Nombre de couches cachées dans le décodeur Transformer. Utilise la même valeur que `num_layers` si non défini.
decoder_ffn_dim (`int`, *facultatif*, valeur par défaut `2048`) : Dimension de la couche « intermédiaire » (souvent appelée couche feed-forward) du décodeur.
decoder_attention_heads (`int`, *facultatif*, valeur par défaut `8`) : Nombre de têtes d'attention pour chaque couche d'attention du décodeur Transformer.
activation_function (`str`, *facultatif*, par défaut `relu`) : Fonction d'activation non linéaire (fonction ou chaîne de caractères) du décodeur. Par exemple, `"gelu"`, `"relu"`, `"silu"`, etc.
d_model (`int`, *facultatif*, par défaut `256`) : Taille des couches d'encodeur et de la couche pooler.
dropout (`Union[float, int]`, *facultatif*, valeur par défaut `0.1`) : Le ratio pour toutes les couches de dropout.
attention_dropout (`Union[float, int]`, *facultatif*, valeur par défaut `0.0`) : Le taux de dropout appliqué aux probabilités d'attention.
activation_dropout (`Union[float, int]`, *facultatif*, valeur par défaut `0.0`) : Le taux de dropout pour les activations à l'intérieur de la couche entièrement connectée.
auxiliary_loss (`bool`, *facultatif*, par défaut `False`) : Indique si les pertes de décodage auxiliaires (pertes à chaque couche du décodeur) doivent être utilisées.
position_embedding_type (`str`, *facultatif*, par défaut `"sine"`) : Type d'embeddings de position à utiliser sur les caractéristiques de l'image. Soit `"sine"` ou `"learned"`.
num_feature_levels (`int`, *facultatif*, par défaut 4) : Le nombre de niveaux de caractéristiques d'entrée.
encoder_n_points (`int`, *facultatif*, valeur par défaut : 4) : Le nombre de clés échantillonnées à chaque niveau de caractéristique pour chaque tête d'attention dans l'encodeur.
decoder_n_points (`int`, *facultatif*, valeur par défaut : 4) : Le nombre de clés échantillonnées à chaque niveau de fonction pour chaque tête d'attention dans le décodeur.
two_stage (`bool`, *facultatif*, valeur par défaut `True`) : Indique s'il faut appliquer un DETR déformable en deux étapes, où les propositions de régions sont également générées par une variante de Grounding DINO, puis transmises au décodeur pour un raffinement itératif des boîtes englobantes.
class_cost (`float`, *facultatif*, valeur par défaut `1.0`) : Poids relatif de l'erreur de classification dans le coût d'appariement hongrois.
bbox_cost (`float`, *facultatif*, valeur par défaut `5.0`) : Poids relatif de l'erreur de boîte englobante L1 dans le coût d'appariement hongrois.
giou_cost (`float`, *facultatif*, valeur par défaut `2.0`) : Poids relatif de la perte d'IoU généralisée dans le coût d'appariement hongrois.
bbox_loss_coefficient (`float`, *facultatif*, valeur par défaut `5.0`) : Poids relatif de la perte de boîte englobante L1 dans la perte de segmentation panoptique.
giou_loss_coefficient (`float`, *facultatif*, valeur par défaut `2.0`) : Poids relatif de la perte IoU généralisée dans la perte de segmentation panoptique.
focal_alpha (`float`, *facultatif*, valeur par défaut `0.25`) : Paramètre alpha de la focal loss.
disable_custom_kernels (`bool`, *facultatif*, valeur par défaut `False`) : Désactive l'utilisation de noyaux CUDA et CPU personnalisés. Cette option est nécessaire pour l'export ONNX, car les noyaux personnalisés ne sont pas pris en charge par l'export ONNX de PyTorch.
max_text_len (`int`, *facultatif*, valeur par défaut : 256) : La longueur maximale de l'entrée texte.
text_enhancer_dropout (`float`, *facultatif*, valeur par défaut 0.0) : Le taux de dropout pour l'améliorateur de texte.
fusion_droppath (`float`, *facultatif*, valeur par défaut 0.1) : Le ratio de droppath pour le module de fusion.
fusion_dropout (`float`, *facultatif*, valeur par défaut 0.0) : Le taux de dropout pour le module de fusion.
embedding_init_target (`bool`, *facultatif*, valeur par défaut `True`) : Indique s'il faut initialiser la cible avec des poids d'Embedding.
query_dim (`int`, *facultatif*, par défaut 4) : La dimension du vecteur de requête.
decoder_bbox_embed_share (`bool`, *facultatif*, valeur par défaut `True`) : Indique s'il faut partager la tête de régression des boîtes englobantes (bbox) pour toutes les couches du décodeur.
two_stage_bbox_embed_share (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut partager l'embedding de bbox entre le générateur de bbox à deux étapes et la génération de propositions de régions.
positional_embedding_temperature (`float`, *facultatif*, valeur par défaut : 20) : La température des Sine Positional Embedding utilisée avec le vision backbone.
init_std (`float`, *facultatif*, valeur par défaut `0.02`) : L'écart-type de la truncated_normal_initializer utilisé pour l'initialisation de toutes les matrices de poids.
layer_norm_eps (`float`, *facultatif*, valeur par défaut `1e-05`) : L'épsilon utilisé par les couches de normalisation de couche.
tie_word_embeddings (`bool`, *facultatif*, valeur par défaut `True`) : Indique s'il faut lier les embeddings de poids selon la correspondance `tied_weights_keys` du modèle.
Il s'agit de la classe de configuration permettant de stocker la configuration d'un modèle Grounding Dino. Elle est utilisée pour instancier un modèle Grounding Dino en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [IDEA-Research/grounding-dino-tiny](https://huggingface.co/IDEA-Research/grounding-dino-tiny)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
Exemples :
```python
>>> from transformers import GroundingDinoConfig, GroundingDinoModel
>>> # Initializing a Grounding DINO IDEA-Research/grounding-dino-tiny style configuration
>>> configuration = GroundingDinoConfig()
>>> # Initializing a model (with random weights) from the IDEA-Research/grounding-dino-tiny style configuration
>>> model = GroundingDinoModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## GroundingDinoModel[[transformers.GroundingDinoModel]]
#### transformers.GroundingDinoModel[[transformers.GroundingDinoModel]]
```python
transformers.GroundingDinoModel(config: GroundingDinoConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/modeling_grounding_dino.py#L1866)
**Paramètres :**
config ([GroundingDinoConfig](/docs/transformers/main/fr/model_doc/grounding-dino#transformers.GroundingDinoConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Le modèle Grounding DINO brut (composé d'un backbone et d'un Transformer encodeur-décodeur) qui produit des états cachés bruts sans aucune tête spécifique au sommet.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.GroundingDinoModel.forward]]
```python
forward(pixel_values: Tensor, input_ids: Tensor, token_type_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.Tensor] = None, encoder_outputs = None, output_attentions = None, output_hidden_states = None, return_dict = None, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/modeling_grounding_dino.py#L2008)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`) : Les tenseurs correspondant aux images d'entrée. Les valeurs des pixels peuvent être obtenues à l'aide de [GroundingDinoImageProcessor](/docs/transformers/main/fr/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor). Voir [GroundingDinoImageProcessor.__call__()](/docs/transformers/main/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails ([GroundingDinoProcessor](/docs/transformers/main/fr/model_doc/grounding-dino#transformers.GroundingDinoProcessor) utilise [GroundingDinoImageProcessor](/docs/transformers/main/fr/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor) pour le traitement des images).
input_ids (`torch.LongTensor` de forme `(batch_size, text_sequence_length)`) : Indices des jetons de la séquence d'entrée dans le vocabulaire. Le bourrage sera ignoré par défaut si vous le fournissez. Les indices peuvent être obtenus à l'aide de [AutoTokenizer](/docs/transformers/main/fr/model_doc/auto#transformers.AutoTokenizer). Voir [BertTokenizer.__call__()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) pour plus de détails.
token_type_ids (`torch.LongTensor` de forme `(batch_size, text_sequence_length)`, *facultatif*) : Indices de jetons de segment pour indiquer les première et deuxième parties des entrées. Les indices sont sélectionnés dans `[0, 1]` : 0 correspond à un jeton de `sentence A`, 1 correspond à un jeton de `sentence B` [Que sont les identifiants de type de jeton ?](../glossary#token-type-ids)
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
pixel_mask (`torch.Tensor` de forme `(batch_size, height, width)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux valeurs de pixels de bourrage. Les valeurs du masque sont comprises dans `[0, 1]` : - 1 pour les pixels réels (c.-à-d. **non masqués**), - 0 pour les pixels de bourrage (c.-à-d. **masqués**). [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
encoder_outputs (``) : Tuple consists of (`last_hidden_state`, *optional*: `hidden_states`, *optional*: `attentions`) `last_hidden_state` of shape `(batch_size, sequence_length, hidden_size)`, *optional*) is a sequence of hidden-states at the output of the last layer of the encoder. Used in the cross-attention of the decoder.
output_attentions (``) : Whether or not to return the attentions tensors of all attention layers. See `attentions` under returned tensors for more detail.
output_hidden_states (``) : Whether or not to return the hidden states of all layers. See `hidden_states` under returned tensors for more detail.
return_dict (``) : Indique s'il faut retourner un [ModelOutput](/docs/transformers/main/fr/main_classes/output#transformers.utils.ModelOutput) plutôt qu'un simple tuple.
**Retourne :** `GroundingDinoModelOutput` ou `tuple(torch.Tensor)`
Un `GroundingDinoModelOutput` ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([GroundingDinoConfig](/docs/transformers/main/fr/model_doc/grounding-dino#transformers.GroundingDinoConfig)) et les entrées.
La méthode forward du modèle [GroundingDinoModel](/docs/transformers/main/fr/model_doc/grounding-dino#transformers.GroundingDinoModel) surcharge la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **last_hidden_state** (`torch.Tensor` de forme `(batch_size, num_queries, hidden_size)`) -- Séquence d'états cachés à la sortie de la dernière couche du décodeur du modèle.
- **init_reference_points** (`torch.Tensor` de forme `(batch_size, num_queries, 4)`) -- Points de référence initiaux transmis au décodeur du Transformer.
- **intermediate_hidden_states** (`torch.Tensor` de forme `(batch_size, config.decoder_layers, num_queries, hidden_size)`) -- États cachés intermédiaires empilés (sortie de chaque couche du décodeur).
- **intermediate_reference_points** (`torch.Tensor` de forme `(batch_size, config.decoder_layers, num_queries, 4)`) -- Points de référence intermédiaires empilés (points de référence de chaque couche du décodeur).
- **decoder_hidden_states** (`tuple[torch.Tensor]`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d'embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du décodeur à la sortie de chaque couche, plus les sorties de l'intégration initiale.
- **decoder_attentions** (`tuple[tuple[torch.Tensor]]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Poids d'attention du décodeur, après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'auto-attention.
- **encoder_last_hidden_state_vision** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) -- Séquence d'états cachés à la sortie de la dernière couche de l'encodeur du modèle.
- **encoder_last_hidden_state_text** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) -- Séquence d'états cachés à la sortie de la dernière couche de l'encodeur du modèle.
- **encoder_vision_hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings visuels + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`. États cachés de l'encodeur visuel à la sortie de chaque couche, ainsi que les sorties des embeddings initiaux.
- **encoder_text_hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings de texte + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`. États cachés de l'encodeur de texte à la sortie de chaque couche, ainsi que les sorties des embeddings initiaux.
- **encoder_attentions** (`tuple(tuple(torch.Tensor))`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de tuples de `torch.Tensor` (un pour l'attention de chaque couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`. Poids des attentions après le softmax d'attention, utilisés pour calculer la moyenne pondérée dans les têtes d'attention texte-vision, vision-texte, texte-enhancer (auto-attention) et attention déformable multi-échelle. softmax d'attention, utilisé pour calculer la moyenne pondérée dans les têtes d'attention binaire.
- **enc_outputs_class** (`torch.Tensor` de forme `(batch_size, sequence_length, config.num_labels)`, *facultatif*, renvoyé lorsque `config.two_stage=True`) -- Scores des boîtes englobantes prédites, où les `config.num_queries` boîtes englobantes ayant les scores les plus élevés sont sélectionnées comme propositions de régions dans la première étape. Sortie de la classification binaire des boîtes englobantes (c.-à-d. premier plan et arrière-plan).
- **enc_outputs_coord_logits** (`torch.Tensor` de forme `(batch_size, sequence_length, 4)`, *facultatif*, renvoyé lorsque `config.two_stage=True`) -- Logits des coordonnées des boîtes englobantes prédites à la première étape.
- **encoder_logits** (`torch.Tensor` de forme `(batch_size, sequence_length, config.num_labels)`, *facultatif*, renvoyé lorsque `config.two_stage=True`) -- Logits des `config.num_queries` boîtes englobantes les mieux notées à la première étape.
- **encoder_pred_boxes** (`torch.Tensor` de forme `(batch_size, sequence_length, 4)`, *facultatif*, renvoyé lorsque `config.two_stage=True`) -- Coordonnées des `config.num_queries` boîtes englobantes les mieux notées de la première étape.
Exemples :
```python
>>> from transformers import AutoProcessor, AutoModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "a cat."
>>> processor = AutoProcessor.from_pretrained("IDEA-Research/grounding-dino-tiny")
>>> model = AutoModel.from_pretrained("IDEA-Research/grounding-dino-tiny")
>>> inputs = processor(images=image, text=text, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 900, 256]
```
## GroundingDinoForObjectDetection[[transformers.GroundingDinoForObjectDetection]]
#### transformers.GroundingDinoForObjectDetection[[transformers.GroundingDinoForObjectDetection]]
```python
transformers.GroundingDinoForObjectDetection(config: GroundingDinoConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/modeling_grounding_dino.py#L2376)
**Paramètres :**
config ([GroundingDinoConfig](/docs/transformers/main/fr/model_doc/grounding-dino#transformers.GroundingDinoConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Modèle Grounding DINO (composé d'un backbone et d'un Transformer encodeur-décodeur) avec des têtes de détection d'objets au sommet, pour des tâches telles que la détection COCO.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.GroundingDinoForObjectDetection.forward]]
```python
forward(pixel_values: Tensor, input_ids: LongTensor, token_type_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, pixel_mask: typing.Optional[torch.BoolTensor] = None, encoder_outputs: transformers.models.grounding_dino.modeling_grounding_dino.GroundingDinoEncoderOutput | tuple | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, labels: list[dict[str, typing.Union[torch.LongTensor, torch.Tensor]]] | None = None, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/modeling_grounding_dino.py#L2417)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`) : Les tenseurs correspondant aux images d'entrée. Les valeurs des pixels peuvent être obtenues à l'aide de [GroundingDinoImageProcessor](/docs/transformers/main/fr/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor). Voir [GroundingDinoImageProcessor.__call__()](/docs/transformers/main/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails ([GroundingDinoProcessor](/docs/transformers/main/fr/model_doc/grounding-dino#transformers.GroundingDinoProcessor) utilise [GroundingDinoImageProcessor](/docs/transformers/main/fr/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor) pour le traitement des images).
input_ids (`torch.LongTensor` de forme `(batch_size, text_sequence_length)`) : Indices des jetons de la séquence d'entrée dans le vocabulaire. Le bourrage sera ignoré par défaut si vous le fournissez. Les indices peuvent être obtenus à l'aide de [AutoTokenizer](/docs/transformers/main/fr/model_doc/auto#transformers.AutoTokenizer). Voir [BertTokenizer.__call__()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) pour plus de détails.
token_type_ids (`torch.LongTensor` de forme `(batch_size, text_sequence_length)`, *facultatif*) : Indices de jetons de segment pour indiquer les première et deuxième parties des entrées. Les indices sont sélectionnés dans `[0, 1]` : 0 correspond à un jeton de `sentence A`, 1 correspond à un jeton de `sentence B` [Que sont les identifiants de type de jeton ?](../glossary#token-type-ids)
attention_mask (`torch.LongTensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
pixel_mask (`torch.BoolTensor` de forme `(batch_size, height, width)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux valeurs de pixels de bourrage. Les valeurs du masque sont comprises dans `[0, 1]` : - 1 pour les pixels réels (c'est-à-dire **non masqués**), - 0 pour les pixels de bourrage (c'est-à-dire **masqués**). [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
encoder_outputs (`Union[~models.grounding_dino.modeling_grounding_dino.GroundingDinoEncoderOutput, tuple]`, *facultatif*) : Le tuple est composé de (`last_hidden_state`, *facultatif* : `hidden_states`, *facultatif* : `attentions`) `last_hidden_state` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) est une séquence d'états cachés à la sortie de la dernière couche de l'encodeur. Utilisé dans l'attention croisée du décodeur.
output_attentions (`bool`, *facultatif*) : Indique s'il faut ou non retourner les tenseurs d'attention de toutes les couches d'attention. Voir `attentions` sous les tenseurs retournés pour plus de détails.
output_hidden_states (`bool`, *facultatif*) : Indique s'il faut retourner les états cachés de toutes les couches. Voir `hidden_states` dans les tenseurs retournés pour plus de détails.
return_dict (`bool`, *facultatif*) : Indique s'il faut retourner un [ModelOutput](/docs/transformers/main/fr/main_classes/output#transformers.utils.ModelOutput) plutôt qu'un simple tuple.
labels (`list[Dict]` de longueur `(batch_size,)`, *facultatif*) : Étiquettes pour le calcul de la perte de correspondance bipartite. Liste de dictionnaires, chaque dictionnaire contenant au moins les 2 clés suivantes : 'class_labels' et 'boxes' (les étiquettes de classes et les boîtes englobantes d'une image du lot, respectivement). Les étiquettes de classes elles-mêmes doivent être un `torch.LongTensor` de longueur `(number of bounding boxes in the image,)` et les boîtes un `torch.Tensor` de forme `(number of bounding boxes in the image, 4)`.
La méthode forward de [GroundingDinoForObjectDetection](/docs/transformers/main/fr/model_doc/grounding-dino#transformers.GroundingDinoForObjectDetection) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
Exemples :
```python
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> import torch
>>> from PIL import Image
>>> from transformers import AutoProcessor, AutoModelForZeroShotObjectDetection
>>> model_id = "IDEA-Research/grounding-dino-tiny"
>>> device = "cuda"
>>> processor = AutoProcessor.from_pretrained(model_id)
>>> model = AutoModelForZeroShotObjectDetection.from_pretrained(model_id).to(device)
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> # Check for cats and remote controls
>>> text_labels = [["a cat", "a remote control"]]
>>> inputs = processor(images=image, text=text_labels, return_tensors="pt").to(device)
>>> with torch.no_grad():
... outputs = model(**inputs)
>>> results = processor.post_process_grounded_object_detection(
... outputs,
... threshold=0.4,
... text_threshold=0.3,
... target_sizes=[(image.height, image.width)]
... )
>>> # Retrieve the first image result
>>> result = results[0]
>>> for box, score, text_label in zip(result["boxes"], result["scores"], result["text_labels"]):
... box = [round(x, 2) for x in box.tolist()]
... print(f"Detected {text_label} with confidence {round(score.item(), 3)} at location {box}")
Detected a cat with confidence 0.479 at location [344.7, 23.11, 637.18, 374.28]
Detected a cat with confidence 0.438 at location [12.27, 51.91, 316.86, 472.44]
Detected a remote control with confidence 0.478 at location [38.57, 70.0, 176.78, 118.18]
```