# BridgeTower
## Tổng quan
Mô hình BridgeTower được đề xuất trong [BridgeTower: Building Bridges Between Encoders in Vision-Language Representative Learning](https://huggingface.co/papers/2206.08657) của Xiao Xu, Chenfei Wu, Shachar Rosenman, Vasudev Lal, Wanxiang Che, Nan Duan. Mục tiêu của mô hình này là xây dựng một cầu nối giữa mỗi bộ mã hóa đơn phương thức và bộ mã hóa đa phương thức, nhằm cho phép tương tác toàn diện và chi tiết ở từng lớp của bộ mã hóa đa phương thức, từ đó đạt được hiệu suất đáng kể trên nhiều tác vụ hạ nguồn với chi phí hiệu suất và tính toán bổ sung gần như không đáng kể.
Bài báo này đã được chấp nhận tại hội nghị [AAAI'23](https://aaai.org/Conferences/AAAI-23/).
Tóm tắt từ bài báo như sau:
*Các mô hình Vision-Language (VL) có kiến trúc TWO-TOWER đã thống trị lĩnh vực học biểu diễn thị giác-ngôn ngữ trong những năm gần đây. Các mô hình VL hiện tại hoặc sử dụng các bộ mã hóa đơn phương thức nhẹ và học cách trích xuất, căn chỉnh và kết hợp cả hai phương thức đồng thời trong một bộ mã hóa liên phương thức sâu, hoặc đưa các biểu diễn đơn phương thức từ lớp cuối của các bộ mã hóa đơn phương thức được huấn luyện trước sâu vào bộ mã hóa liên phương thức phía trên. Cả hai cách tiếp cận đều có khả năng hạn chế việc học biểu diễn thị giác-ngôn ngữ và giới hạn hiệu suất của mô hình. Trong bài báo này, chúng tôi đề xuất BRIDGETOWER, trong đó giới thiệu nhiều lớp cầu nối tạo kết nối giữa các lớp trên cùng của các bộ mã hóa đơn phương thức và mỗi lớp của bộ mã hóa liên phương thức. Điều này cho phép căn chỉnh và kết hợp liên phương thức từ dưới lên một cách hiệu quả giữa các biểu diễn thị giác và văn bản ở các cấp độ ngữ nghĩa khác nhau của các bộ mã hóa đơn phương thức được huấn luyện trước trong bộ mã hóa liên phương thức. Được huấn luyện trước chỉ với 4 triệu hình ảnh, BRIDGETOWER đạt hiệu suất tiên tiến (state-of-the-art) trên nhiều tác vụ thị giác-ngôn ngữ hạ nguồn khác nhau. Cụ thể, trên bộ test-std của VQAv2, BRIDGETOWER đạt độ chính xác 78,73%, vượt qua mô hình tiên tiến trước đó là METER 1,09% với cùng dữ liệu huấn luyện trước và chi phí tham số cũng như tính toán bổ sung gần như không đáng kể. Đáng chú ý, khi mở rộng quy mô mô hình thêm, BRIDGETOWER đạt độ chính xác 81,15%, vượt qua các mô hình được huấn luyện trước trên các bộ dữ liệu lớn hơn nhiều bậc độ lớn.*
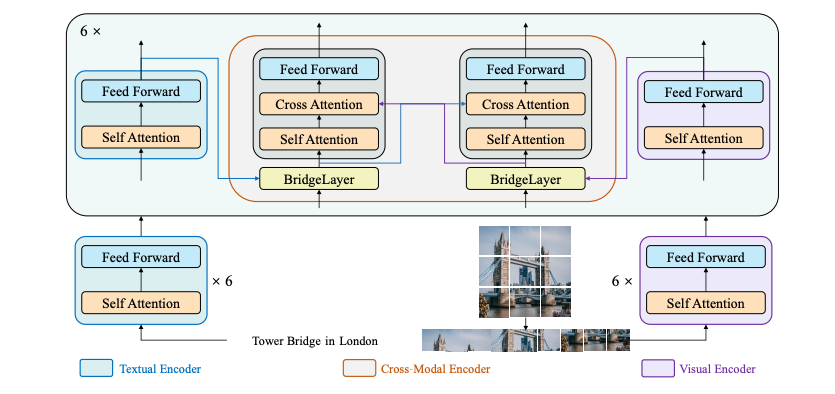 Kiến trúc BridgeTower. Được trích từ bài báo gốc.
Mô hình này được đóng góp bởi [Anahita Bhiwandiwalla](https://huggingface.co/anahita-b), [Tiep Le](https://huggingface.co/Tile) và [Shaoyen Tseng](https://huggingface.co/shaoyent). Mã nguồn gốc có thể được tìm thấy [tại đây](https://github.com/microsoft/BridgeTower).
## Mẹo và ví dụ sử dụng
BridgeTower bao gồm một bộ mã hóa thị giác, một bộ mã hóa văn bản và một bộ mã hóa đa phương thức với nhiều lớp cầu nối nhẹ. Mục tiêu của cách tiếp cận này là xây dựng một cầu nối giữa mỗi bộ mã hóa đơn phương thức và bộ mã hóa đa phương thức, nhằm cho phép tương tác toàn diện và chi tiết ở từng lớp của bộ mã hóa đa phương thức. Về nguyên tắc, người ta có thể áp dụng bất kỳ bộ mã hóa thị giác, văn bản hay đa phương thức nào trong kiến trúc được đề xuất.
[BridgeTowerProcessor](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerProcessor) đóng gói [RobertaTokenizer](/docs/transformers/main/vi/model_doc/led#transformers.RobertaTokenizer) và [BridgeTowerImageProcessor](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) thành một instance duy nhất để lần lượt mã hóa văn bản và chuẩn bị hình ảnh.
Ví dụ sau cho thấy cách chạy học tương phản bằng [BridgeTowerProcessor](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerProcessor) và [BridgeTowerForContrastiveLearning](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerForContrastiveLearning).
```python
import requests
from PIL import Image
from transformers import BridgeTowerForContrastiveLearning, BridgeTowerProcessor
url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
texts = ["An image of two cats chilling on a couch", "A football player scoring a goal"]
processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc")
model = BridgeTowerForContrastiveLearning.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc", device_map="auto")
# forward pass
scores = dict()
for text in texts:
# prepare inputs
encoding = processor(image, text, return_tensors="pt").to(model.device)
outputs = model(**encoding)
scores[text] = outputs
```
Ví dụ sau cho thấy cách chạy truy xuất ảnh-văn bản bằng [BridgeTowerProcessor](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerProcessor) và [BridgeTowerForImageAndTextRetrieval](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerForImageAndTextRetrieval).
```python
import requests
from PIL import Image
from transformers import BridgeTowerForImageAndTextRetrieval, BridgeTowerProcessor
url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
texts = ["An image of two cats chilling on a couch", "A football player scoring a goal"]
processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
model = BridgeTowerForImageAndTextRetrieval.from_pretrained("BridgeTower/bridgetower-base-itm-mlm", device_map="auto")
# forward pass
scores = dict()
for text in texts:
# prepare inputs
encoding = processor(image, text, return_tensors="pt").to(model.device)
outputs = model(**encoding)
scores[text] = outputs.logits[0, 1].item()
```
Ví dụ sau cho thấy cách chạy mô hình hóa ngôn ngữ có che (masked language modeling) bằng [BridgeTowerProcessor](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerProcessor) và [BridgeTowerForMaskedLM](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerForMaskedLM).
```python
from transformers import BridgeTowerProcessor, BridgeTowerForMaskedLM
from PIL import Image
import requests
url = "http://images.cocodataset.org/val2017/000000360943.jpg"
image = Image.open(requests.get(url, stream=True).raw).convert("RGB")
text = "a looking out of the window"
processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
model = BridgeTowerForMaskedLM.from_pretrained("BridgeTower/bridgetower-base-itm-mlm", device_map="auto")
# prepare inputs
encoding = processor(image, text, return_tensors="pt").to(model.device)
# forward pass
outputs = model(**encoding)
results = processor.decode(outputs.logits.argmax(dim=-1).squeeze(0).tolist())
print(results)
.a cat looking out of the window.
```
Mẹo:
- Cài đặt này của BridgeTower sử dụng [RobertaTokenizer](/docs/transformers/main/vi/model_doc/led#transformers.RobertaTokenizer) để tạo các vector nhúng văn bản và mô hình CLIP/ViT của OpenAI để tính toán các vector nhúng thị giác.
- Các checkpoint cho [bridgeTower-base](https://huggingface.co/BridgeTower/bridgetower-base) và [bridgetower masked language modeling and image text matching](https://huggingface.co/BridgeTower/bridgetower-base-itm-mlm) đã được phát hành.
- Vui lòng tham khảo [Bảng 5](https://huggingface.co/papers/2206.08657) để xem hiệu suất của BridgeTower trong Image Retrieval và các tác vụ downstream khác.
## BridgeTowerConfig[[transformers.BridgeTowerConfig]]
#### transformers.BridgeTowerConfig[[transformers.BridgeTowerConfig]]
```python
transformers.BridgeTowerConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, share_cross_modal_transformer_layers: bool = True, hidden_act: str = 'gelu', hidden_size: int = 768, initializer_factor: float | int = 1, layer_norm_eps: float = 1e-05, share_link_tower_layers: bool = False, link_tower_type: str = 'add', num_attention_heads: int = 12, num_hidden_layers: int = 6, tie_word_embeddings: bool = False, init_layernorm_from_vision_encoder: bool = False, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/configuration_bridgetower.py#L104)
**Tham số:**
share_cross_modal_transformer_layers (`bool`, *tùy chọn*, mặc định là `True`) : Xác định xem các lớp transformer đa chế độ có được chia sẻ hay không.
hidden_act (`str`, *tùy chọn*, mặc định là `gelu`) : Hàm kích hoạt phi tuyến (hàm hoặc chuỗi) trong bộ giải mã. Ví dụ, `"gelu"`, `"relu"`, `"silu"`, v.v.
hidden_size (`int`, *optional*, mặc định là `768`) : Kích thước của các biểu diễn ẩn.
initializer_factor (`Union[float, int]`, *tùy chọn*, mặc định là `1`) : Hệ số để khởi tạo tất cả các ma trận trọng số (nên giữ ở mức 1, được sử dụng bên trong cho việc kiểm tra khởi tạo).
layer_norm_eps (`float`, *tuỳ chọn*, mặc định là `1e-05`) : Epsilon được sử dụng bởi các lớp chuẩn hóa lớp (layer normalization).
share_link_tower_layers (`bool`, *tuỳ chọn*, mặc định là `False`) : Xác định xem các lớp bridge/link tower có được chia sẻ hay không.
link_tower_type (`str`, *tùy chọn*, mặc định là `"add"`) : Kiểu của lớp bridge/link.
num_attention_heads (`int`, *tùy chọn*, mặc định là `12`) : Số lượng đầu chú ý cho mỗi lớp chú ý trong bộ giải mã Transformer.
num_hidden_layers (`int`, *tuỳ chọn*, mặc định là `6`) : Số lượng lớp ẩn trong bộ giải mã Transformer.
tie_word_embeddings (`bool`, *tùy chọn*, mặc định là `False`) : Có nên gắn kết các nhúng trọng số theo ánh xạ `tied_weights_keys` của mô hình hay không.
init_layernorm_from_vision_encoder (`bool`, *tùy chọn*, mặc định là `False`) : Có khởi tạo LayerNorm từ bộ mã hóa thị giác hay không.
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *tùy chọn*) : Đối tượng config hoặc từ điển của text backbone.
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *tùy chọn*) : Đối tượng config hoặc từ điển của vision backbone.
Đây là lớp cấu hình để lưu trữ cấu hình của một BridgeTowerModel. Nó được sử dụng để khởi tạo một mô hình Bridgetower theo các đối số được chỉ định, xác định kiến trúc của mô hình. Khởi tạo một cấu hình với các giá trị mặc định sẽ tạo ra một cấu hình tương tự như cấu hình của [BridgeTower/bridgetower-base](https://huggingface.co/BridgeTower/bridgetower-base)
Các đối tượng cấu hình kế thừa từ [PreTrainedConfig](/docs/transformers/main/vi/main_classes/configuration#transformers.PreTrainedConfig) và có thể được sử dụng để kiểm soát đầu ra của mô hình. Đọc tài liệu từ [PreTrainedConfig](/docs/transformers/main/vi/main_classes/configuration#transformers.PreTrainedConfig) để biết thêm thông tin.
Ví dụ:
```python
>>> from transformers import BridgeTowerModel, BridgeTowerConfig
>>> # Initializing a BridgeTower BridgeTower/bridgetower-base style configuration
>>> configuration = BridgeTowerConfig()
>>> # Initializing a model from the BridgeTower/bridgetower-base style configuration
>>> model = BridgeTowerModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## BridgeTowerTextConfig[[transformers.BridgeTowerTextConfig]]
#### transformers.BridgeTowerTextConfig[[transformers.BridgeTowerTextConfig]]
```python
transformers.BridgeTowerTextConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 50265, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, initializer_factor: float | int = 1, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 514, type_vocab_size: int = 1, layer_norm_eps: float = 1e-05, pad_token_id: int | None = 1, bos_token_id: int | None = 0, eos_token_id: int | list[int] | None = 2, use_cache: bool = True, is_decoder: bool = False, add_cross_attention: bool = False)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/configuration_bridgetower.py#L65)
**Tham số:**
vocab_size (`int`, *tùy chọn*, mặc định là `50265`) : Kích thước từ vựng của mô hình. Xác định số lượng token khác nhau có thể được biểu diễn bởi `input_ids`.
hidden_size (`int`, *optional*, mặc định là `768`) : Kích thước của các biểu diễn ẩn.
num_hidden_layers (`int`, *tuỳ chọn*, mặc định là `12`) : Số lượng lớp ẩn trong bộ giải mã Transformer.
num_attention_heads (`int`, *tùy chọn*, mặc định là `12`) : Số lượng đầu chú ý cho mỗi lớp chú ý trong bộ giải mã Transformer.
initializer_factor (`Union[float, int]`, *tùy chọn*, mặc định là `1`) : Hệ số để khởi tạo tất cả các ma trận trọng số (nên giữ ở mức 1, được sử dụng bên trong cho việc kiểm tra khởi tạo).
intermediate_size (`int`, *tuỳ chọn*, mặc định là `3072`) : Kích thước của các biểu diễn MLP.
hidden_act (`str`, *tùy chọn*, mặc định là `gelu`) : Hàm kích hoạt phi tuyến (hàm hoặc chuỗi) trong bộ giải mã. Ví dụ, `"gelu"`, `"relu"`, `"silu"`, v.v.
hidden_dropout_prob (`Union[float, int]`, *tùy chọn*, mặc định là `0.1`) : Xác suất dropout cho tất cả các lớp fully connected trong embeddings, encoder và pooler.
attention_probs_dropout_prob (`Union[float, int]`, *tùy chọn*, mặc định là `0.1`) : Tỷ lệ dropout cho các xác suất chú ý.
max_position_embeddings (`int`, *tuỳ chọn*, mặc định là `514`) : Độ dài tối đa của chuỗi mà mô hình này có thể được sử dụng.
type_vocab_size (`int`, *tùy chọn*, mặc định là `1`) : Kích thước từ vựng của `token_type_ids`.
layer_norm_eps (`float`, *tuỳ chọn*, mặc định là `1e-05`) : Epsilon được sử dụng bởi các lớp chuẩn hóa lớp (layer normalization).
pad_token_id (`int`, *tuỳ chọn*, mặc định là `1`) : Id của token được sử dụng để đệm (padding) trong từ vựng.
bos_token_id (`int`, *tuỳ chọn*, mặc định là `0`) : Id của token được dùng cho đầu luồng (beginning-of-stream) trong từ vựng.
eos_token_id (`Union[int, list[int]]`, *tùy chọn*, mặc định là `2`) : Id của token được sử dụng cho end-of-stream trong bảng từ vựng.
use_cache (`bool`, *tùy chọn*, mặc định là `True`) : Xác định xem mô hình có nên trả về các chú ý key/values cuối cùng hay không (không được sử dụng bởi tất cả các mô hình). Chỉ liên quan nếu `config.is_decoder=True` hoặc khi mô hình là mô hình sinh chỉ có decoder.
is_decoder (`bool`, *tùy chọn*, mặc định là `False`) : Xác định xem mô hình có được sử dụng như một bộ giải mã (decoder) hay không. Nếu `False`, mô hình sẽ được sử dụng như một bộ mã hóa (encoder).
add_cross_attention (`bool`, *tùy chọn*, mặc định là `False`) : Xác định xem có nên thêm các lớp cross-attention vào mô hình hay không.
Đây là lớp cấu hình để lưu trữ cấu hình của một BridgeTowerModel. Nó được sử dụng để khởi tạo một mô hình Bridgetower theo các đối số được chỉ định, xác định kiến trúc của mô hình. Khởi tạo một cấu hình với các giá trị mặc định sẽ tạo ra một cấu hình tương tự như cấu hình của [BridgeTower/bridgetower-base](https://huggingface.co/BridgeTower/bridgetower-base)
Các đối tượng cấu hình kế thừa từ [PreTrainedConfig](/docs/transformers/main/vi/main_classes/configuration#transformers.PreTrainedConfig) và có thể được sử dụng để kiểm soát đầu ra của mô hình. Đọc tài liệu từ [PreTrainedConfig](/docs/transformers/main/vi/main_classes/configuration#transformers.PreTrainedConfig) để biết thêm thông tin.
Ví dụ:
```python
>>> from transformers import BridgeTowerTextConfig
>>> # Initializing a BridgeTower BridgeTower/bridgetower-base style configuration for the text model
>>> configuration = BridgeTowerTextConfig()
>>> # Accessing the configuration
>>> configuration
```
## BridgeTowerVisionConfig[[transformers.BridgeTowerVisionConfig]]
#### transformers.BridgeTowerVisionConfig[[transformers.BridgeTowerVisionConfig]]
```python
transformers.BridgeTowerVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, num_hidden_layers: int = 12, num_channels: int = 3, patch_size: int | list[int] | tuple[int, int] = 16, image_size: int | list[int] | tuple[int, int] = 288, initializer_factor: float | int = 1, layer_norm_eps: float = 1e-05, stop_gradient: bool = False, share_layernorm: bool = True, remove_last_layer: bool = False)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/configuration_bridgetower.py#L27)
**Tham số:**
hidden_size (`int`, *optional*, mặc định là `768`) : Kích thước của các biểu diễn ẩn.
num_hidden_layers (`int`, *tuỳ chọn*, mặc định là `12`) : Số lượng lớp ẩn trong bộ giải mã Transformer.
num_channels (`int`, *tuỳ chọn*, mặc định là `3`) : Số lượng kênh đầu vào.
patch_size (`Union[int, list[int], tuple[int, int]]`, *tùy chọn*, mặc định là `16`) : Kích thước (độ phân giải) của mỗi patch.
image_size (`Union[int, list[int], tuple[int, int]]`, *tùy chọn*, mặc định là `288`) : Kích thước (độ phân giải) của mỗi hình ảnh.
initializer_factor (`Union[float, int]`, *tùy chọn*, mặc định là `1`) : Hệ số để khởi tạo tất cả các ma trận trọng số (nên giữ ở mức 1, được sử dụng bên trong cho việc kiểm tra khởi tạo).
layer_norm_eps (`float`, *tuỳ chọn*, mặc định là `1e-05`) : Epsilon được sử dụng bởi các lớp chuẩn hóa lớp (layer normalization).
stop_gradient (`bool`, *tùy chọn*, mặc định là `False`) : Có dừng gradient cho quá trình huấn luyện hay không.
share_layernorm (`bool`, *tùy chọn*, mặc định là `True`) : Xác định xem các lớp LayerNorm có được chia sẻ hay không.
remove_last_layer (`bool`, *tùy chọn*, mặc định là `False`) : Có nên loại bỏ lớp cuối cùng khỏi bộ mã hóa thị giác hay không.
Đây là lớp cấu hình để lưu trữ cấu hình của một BridgeTowerModel. Nó được sử dụng để khởi tạo một mô hình Bridgetower theo các đối số được chỉ định, xác định kiến trúc của mô hình. Khởi tạo một cấu hình với các giá trị mặc định sẽ tạo ra một cấu hình tương tự như cấu hình của [BridgeTower/bridgetower-base](https://huggingface.co/BridgeTower/bridgetower-base)
Các đối tượng cấu hình kế thừa từ [PreTrainedConfig](/docs/transformers/main/vi/main_classes/configuration#transformers.PreTrainedConfig) và có thể được sử dụng để kiểm soát đầu ra của mô hình. Đọc tài liệu từ [PreTrainedConfig](/docs/transformers/main/vi/main_classes/configuration#transformers.PreTrainedConfig) để biết thêm thông tin.
Ví dụ:
```python
>>> from transformers import BridgeTowerVisionConfig
>>> # Initializing a BridgeTower BridgeTower/bridgetower-base style configuration for the vision model
>>> configuration = BridgeTowerVisionConfig()
>>> # Accessing the configuration
>>> configuration
```
## BridgeTowerImageProcessor[[transformers.BridgeTowerImageProcessor]]
#### transformers.BridgeTowerImageProcessor[[transformers.BridgeTowerImageProcessor]]
```python
transformers.BridgeTowerImageProcessor(**kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/image_processing_bridgetower.py#L76)
**Tham số:**
do_convert_rgb (`bool`, *kwargs*, *optional*) : Có chuyển đổi hình ảnh sang RGB hay không.
do_resize (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Xác định có thay đổi kích thước ảnh hay không.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, mặc định là `{'shortest_edge' : 288}`): Mô tả kích thước đầu vào tối đa cho mô hình.
default_to_square (`bool`, *kwargs*, *optional*, mặc định là `False`) : Có nên mặc định sử dụng ảnh vuông khi thay đổi kích thước hay không, nếu size là một số nguyên.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, mặc định là `{'shortest_edge' : 288}`): Kích thước của ảnh đầu ra sau khi áp dụng `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, mặc định là `3`) : Bộ lọc lấy mẫu lại (resampling filter) được sử dụng khi thay đổi kích thước ảnh. Giá trị này có thể là một trong các hằng số liệt kê (enum) của `PILImageResampling`. Chỉ có hiệu lực khi `do_resize` được đặt thành `True`.
do_rescale (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Xác định có nên điều chỉnh lại tỷ lệ ảnh hay không.
rescale_factor (`float`, *kwargs*, *optional*, mặc định là `0.00392156862745098`) : Hệ số để điều chỉnh lại kích thước ảnh nếu `do_rescale` được đặt thành `True`.
do_normalize (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Có chuẩn hóa hình ảnh hay không.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, mặc định là `[0.48145466, 0.4578275, 0.40821073]`) : Giá trị trung bình của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, mặc định là `[0.26862954, 0.26130258, 0.27577711]`) : Độ lệch chuẩn của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
do_pad (`bool`, *kwargs*, *optional*, mặc định là `True`) : Xác định có chèn padding cho ảnh hay không. Padding được thực hiện đến kích thước lớn nhất trong batch hoặc đến kích thước vuông cố định cho từng ảnh. Chiến lược padding cụ thể phụ thuộc vào model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước ở dạng `{"height": int, "width" int}` để đệm (pad) các ảnh. Phải lớn hơn kích thước của bất kỳ ảnh nào được cung cấp cho tiền xử lý. Nếu `pad_size` không được cung cấp, các ảnh sẽ được đệm đến chiều cao và chiều rộng lớn nhất trong batch. Chỉ được áp dụng khi `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*, mặc định là `True`) : Xác định có cắt ảnh theo kiểu căn giữa hay không.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *tuỳ chọn*) : Chỉ hỗ trợ `ChannelDimension.FIRST`. Được thêm vào để tương thích với các bộ xử lý chậm.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Định dạng chiều kênh cho ảnh đầu vào. Nếu không được đặt, định dạng chiều kênh sẽ được suy ra từ ảnh đầu vào. Có thể là một trong các giá trị sau: - `"channels_first"` hoặc `ChannelDimension.FIRST`: ảnh ở định dạng (num_channels, height, width). - `"channels_last"` hoặc `ChannelDimension.LAST`: ảnh ở định dạng (height, width, num_channels). - `"none"` hoặc `ChannelDimension.NONE`: ảnh ở định dạng (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Thiết bị để xử lý các video. Nếu không được đặt, thiết bị sẽ được suy ra từ các video đầu vào.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Trả về các tensor đã xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor.
disable_grouping (`bool`, *kwargs*, *optional*) : Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *tuỳ chọn*) : Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý.
size_divisor (`int`, *kwargs*, mặc định là `32`) : Kích thước để đảm bảo cả chiều cao lẫn chiều rộng đều chia hết.
Tạo một bộ xử lý ảnh BridgeTowerImageProcessor.
#### preprocess[[transformers.BridgeTowerImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Tham số:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ảnh cần tiền xử lý. Kỳ vọng một ảnh đơn hoặc một lô ảnh có giá trị pixel từ 0 đến 255. Nếu truyền vào các ảnh có giá trị pixel từ 0 đến 1, hãy đặt `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *tùy chọn*) : Cờ dành cho nhà phát triển cho các đầu vào dạng ảnh bổ sung cũng sẽ được tiền xử lý. Chỉ sử dụng cờ này nếu việc truyền các đầu vào dưới dạng kwarg không hoạt động. Ví dụ, `preprocess(images, masks=masks)` là tùy chọn được ưu tiên nhưng có thể gây ra các vấn đề về thứ tự ưu tiên của đối số đối với một số mô hình. Trong những trường hợp đó, có thể sử dụng `preprocess(images, image_like_inputs={"masks": masks})` thay thế.
do_convert_rgb (`bool`, *kwargs*, *optional*) : Có chuyển đổi hình ảnh sang RGB hay không.
do_resize (`bool`, *kwargs*, *optional*) : Xác định có nên thay đổi kích thước ảnh hay không.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*): Mô tả các kích thước đầu vào tối đa của mô hình.
default_to_square (`bool`, *kwargs*, *tuỳ chọn*) : Có mặc định dùng ảnh vuông khi thay đổi kích thước hay không, nếu size là một số nguyên.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước của ảnh đầu ra sau khi áp dụng `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Bộ lọc resampling để sử dụng khi thay đổi kích thước ảnh. Giá trị này có thể là một trong các enum `PILImageResampling`. Chỉ có hiệu lực khi `do_resize` được đặt thành `True`.
do_rescale (`bool`, *kwargs*, *tuỳ chọn*) : Xác định có nên điều chỉnh lại tỷ lệ hình ảnh hay không.
rescale_factor (`float`, *kwargs*, *optional*) : Hệ số để thay đổi tỷ lệ ảnh nếu `do_rescale` được đặt thành `True`.
do_normalize (`bool`, *kwargs*, *tuỳ chọn*) : Xác định có chuẩn hóa hình ảnh hay không.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Giá trị trung bình của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Độ lệch chuẩn của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
do_pad (`bool`, *kwargs*, *optional*) : Xác định có chèn padding cho ảnh hay không. Padding được thực hiện đến kích thước lớn nhất trong batch hoặc đến một kích thước vuông cố định cho mỗi ảnh. Chiến lược padding cụ thể phụ thuộc vào model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước ở dạng `{"height": int, "width" int}` để đệm (pad) các ảnh. Phải lớn hơn kích thước của bất kỳ ảnh nào được cung cấp cho tiền xử lý. Nếu `pad_size` không được cung cấp, các ảnh sẽ được đệm đến chiều cao và chiều rộng lớn nhất trong batch. Chỉ được áp dụng khi `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Có nên cắt ảnh theo kiểu căn giữa hay không.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *tuỳ chọn*) : Chỉ hỗ trợ `ChannelDimension.FIRST`. Được thêm vào để tương thích với các bộ xử lý chậm.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Định dạng chiều kênh cho ảnh đầu vào. Nếu không được đặt, định dạng chiều kênh sẽ được suy ra từ ảnh đầu vào. Có thể là một trong các giá trị sau: - `"channels_first"` hoặc `ChannelDimension.FIRST`: ảnh ở định dạng (num_channels, height, width). - `"channels_last"` hoặc `ChannelDimension.LAST`: ảnh ở định dạng (height, width, num_channels). - `"none"` hoặc `ChannelDimension.NONE`: ảnh ở định dạng (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Thiết bị để xử lý các video. Nếu không được đặt, thiết bị sẽ được suy ra từ các video đầu vào.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Trả về các tensor đã xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor.
disable_grouping (`bool`, *kwargs*, *optional*) : Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *tuỳ chọn*) : Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý.
**Trả về:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Từ điển chứa các danh sách/mảng/tensor được trả về bởi phương thức __call__ ('pixel_values', v.v.).
- **tensor_type** (`Union[None, str, TensorType]`, *tùy chọn*) -- Bạn có thể cung cấp tensor_type tại đây để chuyển đổi các danh sách số nguyên trong Tensor PyTorch/Numpy khi khởi tạo.
Tiền xử lý một hình ảnh hoặc một lô hình ảnh.
## BridgeTowerImageProcessorPil[[transformers.BridgeTowerImageProcessorPil]]
#### transformers.BridgeTowerImageProcessorPil[[transformers.BridgeTowerImageProcessorPil]]
```python
transformers.BridgeTowerImageProcessorPil(**kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/image_processing_pil_bridgetower.py#L70)
**Tham số:**
do_convert_rgb (`bool`, *kwargs*, *optional*) : Có chuyển đổi hình ảnh sang RGB hay không.
do_resize (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Xác định có thay đổi kích thước ảnh hay không.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, mặc định là `{'shortest_edge' : 288}`): Mô tả kích thước đầu vào tối đa cho mô hình.
default_to_square (`bool`, *kwargs*, *optional*, mặc định là `False`) : Có nên mặc định sử dụng ảnh vuông khi thay đổi kích thước hay không, nếu size là một số nguyên.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, mặc định là `{'shortest_edge' : 288}`): Kích thước của ảnh đầu ra sau khi áp dụng `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, mặc định là `3`) : Bộ lọc lấy mẫu lại (resampling filter) được sử dụng khi thay đổi kích thước ảnh. Giá trị này có thể là một trong các hằng số liệt kê (enum) của `PILImageResampling`. Chỉ có hiệu lực khi `do_resize` được đặt thành `True`.
do_rescale (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Xác định có nên điều chỉnh lại tỷ lệ ảnh hay không.
rescale_factor (`float`, *kwargs*, *optional*, mặc định là `0.00392156862745098`) : Hệ số để điều chỉnh lại kích thước ảnh nếu `do_rescale` được đặt thành `True`.
do_normalize (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Có chuẩn hóa hình ảnh hay không.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, mặc định là `[0.48145466, 0.4578275, 0.40821073]`) : Giá trị trung bình của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, mặc định là `[0.26862954, 0.26130258, 0.27577711]`) : Độ lệch chuẩn của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
do_pad (`bool`, *kwargs*, *optional*, mặc định là `True`) : Xác định có chèn padding cho ảnh hay không. Padding được thực hiện đến kích thước lớn nhất trong batch hoặc đến kích thước vuông cố định cho từng ảnh. Chiến lược padding cụ thể phụ thuộc vào model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước ở dạng `{"height": int, "width" int}` để đệm (pad) các ảnh. Phải lớn hơn kích thước của bất kỳ ảnh nào được cung cấp cho tiền xử lý. Nếu `pad_size` không được cung cấp, các ảnh sẽ được đệm đến chiều cao và chiều rộng lớn nhất trong batch. Chỉ được áp dụng khi `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*, mặc định là `True`) : Xác định có cắt ảnh theo kiểu căn giữa hay không.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *tuỳ chọn*) : Chỉ hỗ trợ `ChannelDimension.FIRST`. Được thêm vào để tương thích với các bộ xử lý chậm.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Định dạng chiều kênh cho ảnh đầu vào. Nếu không được đặt, định dạng chiều kênh sẽ được suy ra từ ảnh đầu vào. Có thể là một trong các giá trị sau: - `"channels_first"` hoặc `ChannelDimension.FIRST`: ảnh ở định dạng (num_channels, height, width). - `"channels_last"` hoặc `ChannelDimension.LAST`: ảnh ở định dạng (height, width, num_channels). - `"none"` hoặc `ChannelDimension.NONE`: ảnh ở định dạng (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Thiết bị để xử lý các video. Nếu không được đặt, thiết bị sẽ được suy ra từ các video đầu vào.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Trả về các tensor đã xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor.
disable_grouping (`bool`, *kwargs*, *optional*) : Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *tuỳ chọn*) : Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý.
size_divisor (`int`, *kwargs*, mặc định là `32`) : Kích thước để đảm bảo cả chiều cao lẫn chiều rộng đều chia hết.
Tạo một bộ xử lý ảnh BridgeTowerImageProcessor.
#### preprocess[[transformers.BridgeTowerImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Tham số:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ảnh cần tiền xử lý. Kỳ vọng một ảnh đơn hoặc một lô ảnh có giá trị pixel từ 0 đến 255. Nếu truyền vào các ảnh có giá trị pixel từ 0 đến 1, hãy đặt `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *tùy chọn*) : Cờ dành cho nhà phát triển cho các đầu vào dạng ảnh bổ sung cũng sẽ được tiền xử lý. Chỉ sử dụng cờ này nếu việc truyền các đầu vào dưới dạng kwarg không hoạt động. Ví dụ, `preprocess(images, masks=masks)` là tùy chọn được ưu tiên nhưng có thể gây ra các vấn đề về thứ tự ưu tiên của đối số đối với một số mô hình. Trong những trường hợp đó, có thể sử dụng `preprocess(images, image_like_inputs={"masks": masks})` thay thế.
do_convert_rgb (`bool`, *kwargs*, *optional*) : Có chuyển đổi hình ảnh sang RGB hay không.
do_resize (`bool`, *kwargs*, *optional*) : Xác định có nên thay đổi kích thước ảnh hay không.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*): Mô tả các kích thước đầu vào tối đa của mô hình.
default_to_square (`bool`, *kwargs*, *tuỳ chọn*) : Có mặc định dùng ảnh vuông khi thay đổi kích thước hay không, nếu size là một số nguyên.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước của ảnh đầu ra sau khi áp dụng `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Bộ lọc resampling để sử dụng khi thay đổi kích thước ảnh. Giá trị này có thể là một trong các enum `PILImageResampling`. Chỉ có hiệu lực khi `do_resize` được đặt thành `True`.
do_rescale (`bool`, *kwargs*, *tuỳ chọn*) : Xác định có nên điều chỉnh lại tỷ lệ hình ảnh hay không.
rescale_factor (`float`, *kwargs*, *optional*) : Hệ số để thay đổi tỷ lệ ảnh nếu `do_rescale` được đặt thành `True`.
do_normalize (`bool`, *kwargs*, *tuỳ chọn*) : Xác định có chuẩn hóa hình ảnh hay không.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Giá trị trung bình của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Độ lệch chuẩn của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
do_pad (`bool`, *kwargs*, *optional*) : Xác định có chèn padding cho ảnh hay không. Padding được thực hiện đến kích thước lớn nhất trong batch hoặc đến một kích thước vuông cố định cho mỗi ảnh. Chiến lược padding cụ thể phụ thuộc vào model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước ở dạng `{"height": int, "width" int}` để đệm (pad) các ảnh. Phải lớn hơn kích thước của bất kỳ ảnh nào được cung cấp cho tiền xử lý. Nếu `pad_size` không được cung cấp, các ảnh sẽ được đệm đến chiều cao và chiều rộng lớn nhất trong batch. Chỉ được áp dụng khi `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Có nên cắt ảnh theo kiểu căn giữa hay không.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *tuỳ chọn*) : Chỉ hỗ trợ `ChannelDimension.FIRST`. Được thêm vào để tương thích với các bộ xử lý chậm.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Định dạng chiều kênh cho ảnh đầu vào. Nếu không được đặt, định dạng chiều kênh sẽ được suy ra từ ảnh đầu vào. Có thể là một trong các giá trị sau: - `"channels_first"` hoặc `ChannelDimension.FIRST`: ảnh ở định dạng (num_channels, height, width). - `"channels_last"` hoặc `ChannelDimension.LAST`: ảnh ở định dạng (height, width, num_channels). - `"none"` hoặc `ChannelDimension.NONE`: ảnh ở định dạng (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Thiết bị để xử lý các video. Nếu không được đặt, thiết bị sẽ được suy ra từ các video đầu vào.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Trả về các tensor đã xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor.
disable_grouping (`bool`, *kwargs*, *optional*) : Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *tuỳ chọn*) : Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý.
**Trả về:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Từ điển chứa các danh sách/mảng/tensor được trả về bởi phương thức __call__ ('pixel_values', v.v.).
- **tensor_type** (`Union[None, str, TensorType]`, *tùy chọn*) -- Bạn có thể cung cấp tensor_type tại đây để chuyển đổi các danh sách số nguyên trong Tensor PyTorch/Numpy khi khởi tạo.
Tiền xử lý một hình ảnh hoặc một lô hình ảnh.
## BridgeTowerProcessor[[transformers.BridgeTowerProcessor]]
#### transformers.BridgeTowerProcessor[[transformers.BridgeTowerProcessor]]
```python
transformers.BridgeTowerProcessor(image_processor, tokenizer)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/processing_bridgetower.py#L42)
**Tham số:**
image_processor (`BridgeTowerImageProcessor`) : Bộ xử lý ảnh là một đầu vào bắt buộc.
tokenizer (`RobertaTokenizer`) : Tokenizer là một đầu vào bắt buộc.
Tạo một BridgeTowerProcessor, đóng gói một bộ xử lý ảnh và một tokenizer thành một bộ xử lý duy nhất.
[BridgeTowerProcessor](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerProcessor) cung cấp đầy đủ các chức năng của [BridgeTowerImageProcessor](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) và [RobertaTokenizer](/docs/transformers/main/vi/model_doc/led#transformers.RobertaTokenizer). Xem [~BridgeTowerImageProcessor](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) và [~RobertaTokenizer](/docs/transformers/main/vi/model_doc/led#transformers.RobertaTokenizer) để biết thêm thông tin.
#### __call__[[transformers.BridgeTowerProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L659)
**Tham số:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *tùy chọn*) : Ảnh cần tiền xử lý. Kỳ vọng một ảnh đơn hoặc một lô ảnh với giá trị pixel dao động từ 0 đến 255. Nếu truyền vào các ảnh có giá trị pixel nằm trong khoảng từ 0 đến 1, hãy đặt `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *tùy chọn*) : Chuỗi hoặc lô các chuỗi cần được mã hóa. Mỗi chuỗi có thể là một chuỗi ký tự hoặc một danh sách các chuỗi ký tự (chuỗi đã được tách token trước). Nếu bạn truyền vào đầu vào đã tách token trước, hãy đặt `is_split_into_words=True` để tránh nhầm lẫn với các đầu vào dạng lô.
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`, *optional*) : Video cần tiền xử lý. Kỳ vọng một video đơn hoặc một batch video với giá trị pixel từ 0 đến 255. Nếu truyền vào video có giá trị pixel từ 0 đến 1, hãy đặt `do_rescale=False`.
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`, *optional*) : Âm thanh hoặc lô âm thanh cần được chuẩn bị. Mỗi âm thanh có thể là mảng NumPy hoặc tensor PyTorch. Trong trường hợp là mảng NumPy/tensor PyTorch, mỗi âm thanh nên có hình dạng (C, T), trong đó C là số kênh và T là độ dài mẫu của âm thanh.
return_tensors (`str` hoặc [TensorType](/docs/transformers/main/vi/internal/file_utils#transformers.TensorType), *optional*) : Nếu được đặt, sẽ trả về các tensor của một framework cụ thể. Các giá trị chấp nhận được là: - `'pt'`: Trả về các đối tượng `torch.Tensor` của PyTorch. - `'np'`: Trả về các đối tượng `np.ndarray` của NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/main/vi/main_classes/processors#transformers.ProcessingKwargs), *optional*) : Các tùy chọn xử lý bổ sung cho từng phương thức (text, images, videos, audio). Các tham số cụ thể của model được liệt kê ở trên; xem lớp TypedDict để biết danh sách đầy đủ các đối số được hỗ trợ.
## BridgeTowerModel[[transformers.BridgeTowerModel]]
#### transformers.BridgeTowerModel[[transformers.BridgeTowerModel]]
```python
transformers.BridgeTowerModel(config: BridgeTowerConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/modeling_bridgetower.py#L1079)
**Tham số:**
config ([BridgeTowerConfig](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số của mô hình.
Model transformer của BridgeTower Model không có đầu cụ thể nào, trả về đối tượng BridgeTowerModelOutput
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.BridgeTowerModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, image_token_type_idx: int | None = None, labels: typing.Optional[torch.LongTensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/modeling_bridgetower.py#L1152)
**Tham số:**
input_ids (`torch.LongTensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của các token trong chuỗi đầu vào theo từ vựng. Mặc định, các token đệm (padding) sẽ bị bỏ qua. Có thể lấy chỉ số bằng cách sử dụng [AutoTokenizer](/docs/transformers/main/vi/model_doc/auto#transformers.AutoTokenizer). Xem [PreTrainedTokenizer.encode()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) và [PreTrainedTokenizer.__call__()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) để biết chi tiết. [ID đầu vào là gì?](../glossary#input-ids)
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Các chỉ số token phân đoạn để chỉ định phần đầu và phần thứ hai của các đầu vào. Các chỉ số được chọn trong `[0, 1]`: - 0 tương ứng với token *câu A*, - 1 tương ứng với token *câu B*. [Các ID loại token là gì?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` có shape `(batch_size, num_channels, image_size, image_size)`, *tùy chọn*) : Các tensor tương ứng với các ảnh đầu vào. Giá trị pixel có thể được lấy bằng cách sử dụng [BridgeTowerImageProcessor](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerImageProcessor). Xem [BridgeTowerImageProcessor.__call__()](/docs/transformers/main/vi/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) để biết chi tiết ([BridgeTowerProcessor](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerProcessor) sử dụng [BridgeTowerImageProcessor](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) để xử lý ảnh).
pixel_mask (`torch.LongTensor` có hình dạng `(batch_size, height, width)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các giá trị pixel đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các pixel thực (tức là **không bị che**), - 0 cho các pixel đệm (tức là **bị che**). [Mặt nạ chú ý là gì?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `input_ids`, bạn có thể chọn cách truyền trực tiếp một biểu diễn nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi các chỉ số `input_ids` thành các vector liên quan so với ma trận tra cứu nhúng nội bộ của mô hình.
image_embeds (`torch.Tensor` có hình dạng `(batch_size, num_patches, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `pixel_values`, bạn có thể chọn truyền trực tiếp một biểu diễn đã nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi `pixel_values` thành các patch embeddings.
image_token_type_idx (`int`, *optional*) : - Các id loại token cho hình ảnh.
labels (`torch.LongTensor` có hình dạng `(batch_size,)`, *tùy chọn*) : Nhãn hiện chưa được hỗ trợ.
interpolate_pos_encoding (`bool`, *tùy chọn*, mặc định là `False`) : Có nội suy các mã hóa vị trí được huấn luyện trước hay không.
**Trả về:** `BridgeTowerModelOutput` hoặc `tuple(torch.Tensor)`
Một `BridgeTowerModelOutput` hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([BridgeTowerConfig](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerConfig)) và đầu vào.
Phương thức forward của [BridgeTowerModel](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerModel) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **text_features** (`torch.Tensor` có hình dạng `(batch_size, text_sequence_length, hidden_size)`) -- Chuỗi các hidden-states tại đầu ra văn bản của lớp cuối cùng của mô hình.
- **image_features** (`torch.Tensor` có hình dạng `(batch_size, image_sequence_length, hidden_size)`) -- Chuỗi các hidden-states tại đầu ra ảnh của lớp cuối cùng của mô hình.
- **pooler_output** (`torch.Tensor` có shape `(batch_size, hidden_size x 2)`) -- Kết quả nối (concatenation) của hidden-state lớp cuối của token đầu tiên (classification token) của chuỗi văn bản và chuỗi ảnh, tương ứng, sau khi được xử lý thêm qua các lớp dùng cho các tác vụ pretraining phụ trợ.
- **hidden_states** (`tuple[torch.Tensor]`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple các `torch.Tensor` (một cho đầu ra của embeddings, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple[torch.Tensor]`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
```python
>>> from transformers import BridgeTowerProcessor, BridgeTowerModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> # prepare image and text
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "hello world"
>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base")
>>> model = BridgeTowerModel.from_pretrained("BridgeTower/bridgetower-base")
>>> inputs = processor(image, text, return_tensors="pt")
>>> outputs = model(**inputs)
>>> outputs.keys()
odict_keys(['text_features', 'image_features', 'pooler_output'])
```
## BridgeTowerForContrastiveLearning[[transformers.BridgeTowerForContrastiveLearning]]
#### transformers.BridgeTowerForContrastiveLearning[[transformers.BridgeTowerForContrastiveLearning]]
```python
transformers.BridgeTowerForContrastiveLearning(config: BridgeTowerConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/modeling_bridgetower.py#L1603)
**Tham số:**
config ([BridgeTowerConfig](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số của mô hình.
Mô hình BridgeTower với một đầu tương phản hình ảnh-văn bản ở trên cùng, tính toán tổn thất tương phản hình ảnh-văn bản.
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.BridgeTowerForContrastiveLearning.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, return_loss: bool | None = None, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/modeling_bridgetower.py#L1617)
**Tham số:**
input_ids (`torch.LongTensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của các token trong chuỗi đầu vào theo từ vựng. Mặc định, các token đệm (padding) sẽ bị bỏ qua. Có thể lấy chỉ số bằng cách sử dụng [AutoTokenizer](/docs/transformers/main/vi/model_doc/auto#transformers.AutoTokenizer). Xem [PreTrainedTokenizer.encode()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) và [PreTrainedTokenizer.__call__()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) để biết chi tiết. [ID đầu vào là gì?](../glossary#input-ids)
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Các chỉ số token phân đoạn để chỉ định phần đầu và phần thứ hai của các đầu vào. Các chỉ số được chọn trong `[0, 1]`: - 0 tương ứng với token *câu A*, - 1 tương ứng với token *câu B*. [Các ID loại token là gì?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` có shape `(batch_size, num_channels, image_size, image_size)`, *tùy chọn*) : Các tensor tương ứng với các ảnh đầu vào. Giá trị pixel có thể được lấy bằng cách sử dụng [BridgeTowerImageProcessor](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerImageProcessor). Xem [BridgeTowerImageProcessor.__call__()](/docs/transformers/main/vi/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) để biết chi tiết ([BridgeTowerProcessor](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerProcessor) sử dụng [BridgeTowerImageProcessor](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) để xử lý ảnh).
pixel_mask (`torch.LongTensor` có hình dạng `(batch_size, height, width)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các giá trị pixel đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các pixel thực (tức là **không bị che**), - 0 cho các pixel đệm (tức là **bị che**). [Mặt nạ chú ý là gì?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `input_ids`, bạn có thể chọn cách truyền trực tiếp một biểu diễn nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi các chỉ số `input_ids` thành các vector liên quan so với ma trận tra cứu nhúng nội bộ của mô hình.
image_embeds (`torch.Tensor` có hình dạng `(batch_size, num_patches, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `pixel_values`, bạn có thể chọn truyền trực tiếp một biểu diễn đã nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi `pixel_values` thành các patch embeddings.
return_loss (`bool`, *tùy chọn*) : Có trả về tổn thất tương phản hay không.
**Trả về:** `BridgeTowerContrastiveOutput` hoặc `tuple(torch.Tensor)`
Một `BridgeTowerContrastiveOutput` hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([BridgeTowerConfig](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerConfig)) và đầu vào.
Phương thức forward của [BridgeTowerForContrastiveLearning](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerForContrastiveLearning) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **loss** (`torch.Tensor` có shape `(1,)`, *tuỳ chọn*, được trả về khi `return_loss` là `True`) -- Mất tương phản giữa ảnh và văn bản.
- **logits** (`torch.Tensor` có hình dạng `(batch_size, sequence_length, config.vocab_size)`) -- Điểm dự đoán của đầu mô hình hóa ngôn ngữ (điểm cho mỗi token từ vựng trước SoftMax).
- **text_embeds** (`torch.Tensor)`, *tùy chọn*, được trả về khi mô hình được khởi tạo với `with_projection=True`) -- Các vector nhúng văn bản thu được bằng cách áp dụng lớp chiếu lên pooler_output.
- **image_embeds** (`torch.Tensor)`, *tùy chọn*, được trả về khi model được khởi tạo với `with_projection=True`) -- Các embedding của ảnh thu được bằng cách áp dụng lớp projection lên pooler_output.
- **cross_embeds** (`torch.Tensor)`, *tuỳ chọn*, được trả về khi mô hình được khởi tạo với `with_projection=True`) -- Các embedding đa phương thức chéo giữa văn bản và hình ảnh, thu được bằng cách áp dụng lớp chiếu (projection layer) lên pooler_output.
- **hidden_states** (`tuple[torch.Tensor]`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple các `torch.Tensor` (một cho đầu ra của embeddings, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Ví dụ:
```python
>>> from transformers import BridgeTowerProcessor, BridgeTowerForContrastiveLearning
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> import torch
>>> image_urls = [
... "https://farm4.staticflickr.com/3395/3428278415_81c3e27f15_z.jpg",
... "http://images.cocodataset.org/val2017/000000039769.jpg",
... ]
>>> texts = ["two dogs in a car", "two cats sleeping on a couch"]
>>> with httpx.stream("GET", urls[0]) as response:
... image1 = Image.open(BytesIO(response.read()))
>>> with httpx.stream("GET", urls[1]) as response:
... image2 = Image.open(BytesIO(response.read()))
>>> images = [image1, image2]
>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc")
>>> model = BridgeTowerForContrastiveLearning.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc")
>>> inputs = processor(images, texts, padding=True, return_tensors="pt")
>>> loss = model(**inputs, return_loss=True).loss
>>> inputs = processor(images, texts[::-1], padding=True, return_tensors="pt")
>>> loss_swapped = model(**inputs, return_loss=True).loss
>>> print("Loss", round(loss.item(), 4))
Loss 0.0019
>>> print("Loss with swapped images", round(loss_swapped.item(), 4))
Loss with swapped images 2.126
```
## BridgeTowerForMaskedLM[[transformers.BridgeTowerForMaskedLM]]
#### transformers.BridgeTowerForMaskedLM[[transformers.BridgeTowerForMaskedLM]]
```python
transformers.BridgeTowerForMaskedLM(config: BridgeTowerConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/modeling_bridgetower.py#L1404)
**Tham số:**
config ([BridgeTowerConfig](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số của mô hình.
Mô hình BridgeTower với một đầu mô hình hóa ngôn ngữ ở trên, như đã thực hiện trong quá trình tiền huấn luyện.
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.BridgeTowerForMaskedLM.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/modeling_bridgetower.py#L1422)
**Tham số:**
input_ids (`torch.LongTensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của các token trong chuỗi đầu vào theo từ vựng. Mặc định, các token đệm (padding) sẽ bị bỏ qua. Có thể lấy chỉ số bằng cách sử dụng [AutoTokenizer](/docs/transformers/main/vi/model_doc/auto#transformers.AutoTokenizer). Xem [PreTrainedTokenizer.encode()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) và [PreTrainedTokenizer.__call__()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) để biết chi tiết. [ID đầu vào là gì?](../glossary#input-ids)
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Các chỉ số token phân đoạn để chỉ định phần đầu và phần thứ hai của các đầu vào. Các chỉ số được chọn trong `[0, 1]`: - 0 tương ứng với token *câu A*, - 1 tương ứng với token *câu B*. [Các ID loại token là gì?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` có shape `(batch_size, num_channels, image_size, image_size)`, *tùy chọn*) : Các tensor tương ứng với các ảnh đầu vào. Giá trị pixel có thể được lấy bằng cách sử dụng [BridgeTowerImageProcessor](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerImageProcessor). Xem [BridgeTowerImageProcessor.__call__()](/docs/transformers/main/vi/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) để biết chi tiết ([BridgeTowerProcessor](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerProcessor) sử dụng [BridgeTowerImageProcessor](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) để xử lý ảnh).
pixel_mask (`torch.LongTensor` có hình dạng `(batch_size, height, width)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các giá trị pixel đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các pixel thực (tức là **không bị che**), - 0 cho các pixel đệm (tức là **bị che**). [Mặt nạ chú ý là gì?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `input_ids`, bạn có thể chọn cách truyền trực tiếp một biểu diễn nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi các chỉ số `input_ids` thành các vector liên quan so với ma trận tra cứu nhúng nội bộ của mô hình.
image_embeds (`torch.Tensor` có hình dạng `(batch_size, num_patches, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `pixel_values`, bạn có thể chọn truyền trực tiếp một biểu diễn đã nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi `pixel_values` thành các patch embeddings.
labels (`torch.LongTensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Nhãn để tính toán tổn thất mô hình hóa ngôn ngữ có che (masked language modeling loss). Chỉ số phải nằm trong `[-100, 0, ..., config.vocab_size]` (xem docstring của `input_ids`). Các token có chỉ số được đặt thành `-100` sẽ bị bỏ qua (che), tổn thất chỉ được tính cho các token có nhãn nằm trong `[0, ..., config.vocab_size]`.
**Trả về:** [MaskedLMOutput](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) hoặc `tuple(torch.Tensor)`
Một [MaskedLMOutput](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([BridgeTowerConfig](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerConfig)) và đầu vào.
Phương thức forward của [BridgeTowerForMaskedLM](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerForMaskedLM) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **loss** (`torch.Tensor` có hình dạng `(1,)`, *tùy chọn*, được trả về khi `labels` được cung cấp) -- Tổn thất mô hình hóa ngôn ngữ có mặt nạ (MLM).
- **logits** (`torch.Tensor` có hình dạng `(batch_size, sequence_length, config.vocab_size)`) -- Điểm dự đoán của đầu mô hình hóa ngôn ngữ (điểm cho mỗi token từ vựng trước SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple của `torch.Tensor` (một cho đầu ra của các embedding, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
```python
>>> from transformers import BridgeTowerProcessor, BridgeTowerForMaskedLM
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000360943.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read())).convert("RGB")
>>> text = "a looking out of the window"
>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
>>> model = BridgeTowerForMaskedLM.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
>>> # prepare inputs
>>> encoding = processor(image, text, return_tensors="pt")
>>> # forward pass
>>> outputs = model(**encoding)
>>> results = processor.decode(outputs.logits.argmax(dim=-1).squeeze(0).tolist())
>>> print(results)
.a cat looking out of the window.
```
## BridgeTowerForImageAndTextRetrieval[[transformers.BridgeTowerForImageAndTextRetrieval]]
#### transformers.BridgeTowerForImageAndTextRetrieval[[transformers.BridgeTowerForImageAndTextRetrieval]]
```python
transformers.BridgeTowerForImageAndTextRetrieval(config: BridgeTowerConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/modeling_bridgetower.py#L1501)
**Tham số:**
config ([BridgeTowerConfig](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số của mô hình.
Model transformer BridgeTower với một đầu phân loại phía trên (một lớp tuyến tính phía trên trạng thái ẩn cuối cùng của token [CLS]) để khớp hình ảnh với văn bản.
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.BridgeTowerForImageAndTextRetrieval.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/modeling_bridgetower.py#L1512)
**Tham số:**
input_ids (`torch.LongTensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của các token trong chuỗi đầu vào theo từ vựng. Mặc định, các token đệm (padding) sẽ bị bỏ qua. Có thể lấy chỉ số bằng cách sử dụng [AutoTokenizer](/docs/transformers/main/vi/model_doc/auto#transformers.AutoTokenizer). Xem [PreTrainedTokenizer.encode()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) và [PreTrainedTokenizer.__call__()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) để biết chi tiết. [ID đầu vào là gì?](../glossary#input-ids)
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Các chỉ số token phân đoạn để chỉ định phần đầu và phần thứ hai của các đầu vào. Các chỉ số được chọn trong `[0, 1]`: - 0 tương ứng với token *câu A*, - 1 tương ứng với token *câu B*. [Các ID loại token là gì?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` có shape `(batch_size, num_channels, image_size, image_size)`, *tùy chọn*) : Các tensor tương ứng với các ảnh đầu vào. Giá trị pixel có thể được lấy bằng cách sử dụng [BridgeTowerImageProcessor](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerImageProcessor). Xem [BridgeTowerImageProcessor.__call__()](/docs/transformers/main/vi/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) để biết chi tiết ([BridgeTowerProcessor](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerProcessor) sử dụng [BridgeTowerImageProcessor](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) để xử lý ảnh).
pixel_mask (`torch.LongTensor` có hình dạng `(batch_size, height, width)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các giá trị pixel đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các pixel thực (tức là **không bị che**), - 0 cho các pixel đệm (tức là **bị che**). [Mặt nạ chú ý là gì?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `input_ids`, bạn có thể chọn cách truyền trực tiếp một biểu diễn nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi các chỉ số `input_ids` thành các vector liên quan so với ma trận tra cứu nhúng nội bộ của mô hình.
image_embeds (`torch.Tensor` có hình dạng `(batch_size, num_patches, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `pixel_values`, bạn có thể chọn truyền trực tiếp một biểu diễn đã nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi `pixel_values` thành các patch embeddings.
labels (`torch.LongTensor` có hình dạng `(batch_size, 1)`, *tùy chọn*) : Nhãn để tính toán tổn thất khớp văn bản-hình ảnh. 0 nghĩa là các cặp không khớp và 1 nghĩa là chúng khớp. Các cặp có nhãn 0 sẽ bị bỏ qua trong quá trình tính toán.
**Trả về:** [SequenceClassifierOutput](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) hoặc `tuple(torch.Tensor)`
Một [SequenceClassifierOutput](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([BridgeTowerConfig](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerConfig)) và đầu vào.
Phương thức forward của [BridgeTowerForImageAndTextRetrieval](/docs/transformers/main/vi/model_doc/bridgetower#transformers.BridgeTowerForImageAndTextRetrieval) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **loss** (`torch.Tensor` có shape `(1,)`, *optional*, được trả về khi `labels` được cung cấp) -- Loss phân loại (hoặc hồi quy nếu config.num_labels==1).
- **logits** (`torch.Tensor` có hình dạng `(batch_size, config.num_labels)`) -- Điểm phân loại (hoặc hồi quy nếu config.num_labels==1) (trước SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple của `torch.Tensor` (một cho đầu ra của các embedding, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
```python
>>> from transformers import BridgeTowerProcessor, BridgeTowerForImageAndTextRetrieval
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> texts = ["An image of two cats chilling on a couch", "A football player scoring a goal"]
>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
>>> model = BridgeTowerForImageAndTextRetrieval.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
>>> # forward pass
>>> scores = dict()
>>> for text in texts:
... # prepare inputs
... encoding = processor(image, text, return_tensors="pt")
... outputs = model(**encoding)
... scores[text] = outputs.logits[0, 1].item()
```