# ImageGPT
## Tổng quan
Mô hình ImageGPT được đề xuất trong [Generative Pretraining from Pixels](https://openai.com/blog/image-gpt) bởi Mark Chen, Alec Radford, Rewon Child, Jeffrey Wu, Heewoo Jun, David Luan, Ilya Sutskever. ImageGPT (iGPT) là một mô hình tương tự GPT-2 được huấn luyện để dự đoán giá trị pixel tiếp theo, cho phép tạo hình ảnh cả ở chế độ không điều kiện lẫn có điều kiện.
Tóm tắt từ [bài báo](https://cdn.openai.com/papers/Generative_Pretraining_from_Pixels_V1_ICML.pdf) như sau:
*Được truyền cảm hứng từ những tiến bộ trong học biểu diễn không giám sát cho ngôn ngữ tự nhiên, chúng tôi xem xét liệu các mô hình tương tự có thể học được các biểu diễn hữu ích cho hình ảnh hay không. Chúng tôi huấn luyện một Transformer tuần tự để dự đoán các pixel theo cách tự hồi quy, mà không tích hợp kiến thức về cấu trúc đầu vào 2D. Mặc dù được huấn luyện trên ImageNet độ phân giải thấp mà không có nhãn, chúng tôi nhận thấy rằng một mô hình ở quy mô GPT-2 học được các biểu diễn hình ảnh mạnh mẽ, được đo lường bằng linear probing, fine-tuning và phân loại dữ liệu thấp. Trên CIFAR-10, chúng tôi đạt độ chính xác 96,3% với linear probe, vượt qua Wide ResNet có giám sát, và đạt độ chính xác 99,0% với fine-tuning đầy đủ, ngang bằng với các mô hình pre-trained có giám sát hàng đầu. Chúng tôi cũng cạnh tranh tốt với các benchmark tự giám sát trên ImageNet khi thay thế các pixel bằng mã hóa VQVAE, đạt độ chính xác top-1 là 69,0% trên linear probe của các đặc trưng của chúng tôi.*
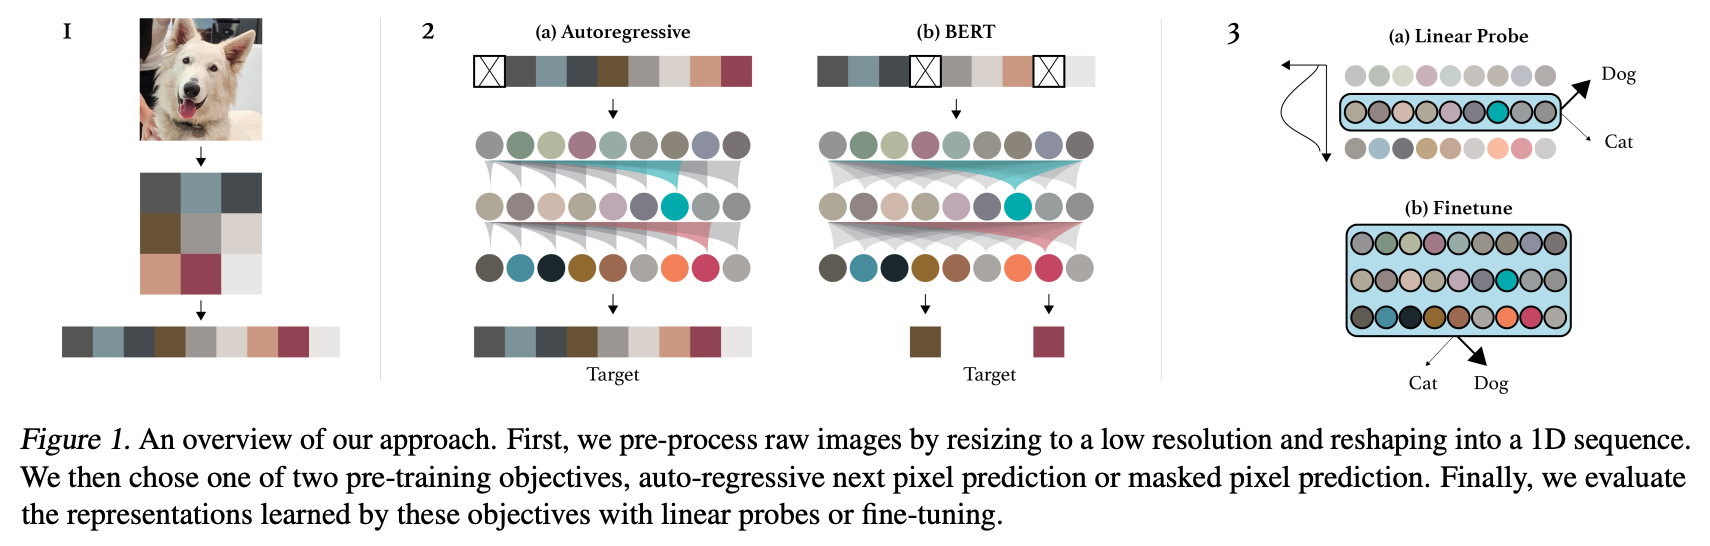 Tóm tắt phương pháp. Trích từ [bài báo gốc](https://cdn.openai.com/papers/Generative_Pretraining_from_Pixels_V2.pdf).
Mô hình này được đóng góp bởi [nielsr](https://huggingface.co/nielsr), dựa trên [vấn đề này](https://github.com/openai/image-gpt/issues/7). Mã gốc có thể được tìm thấy [tại đây](https://github.com/openai/image-gpt).
## Mẹo sử dụng
- ImageGPT gần như giống hệt với [GPT-2](gpt2), ngoại trừ việc sử dụng một hàm kích hoạt khác (cụ thể là "quick gelu"), và các lớp chuẩn hóa lớp không thực hiện việc đưa về trung tâm các đầu vào. ImageGPT cũng không có các embedding đầu vào và đầu ra được liên kết với nhau.
- Vì yêu cầu về thời gian và bộ nhớ của cơ chế chú ý trong Transformers tăng theo bậc hai của độ dài chuỗi, các tác giả đã huấn luyện trước ImageGPT trên các độ phân giải đầu vào nhỏ hơn, chẳng hạn như 32x32 và 64x64. Tuy nhiên, việc đưa một chuỗi gồm 32x32x3=3072 token từ 0..255 vào một Transformer vẫn là quá lớn. Do đó, các tác giả đã áp dụng phân cụm k-means lên các giá trị pixel (R,G,B) với k=512. Bằng cách này, chúng ta chỉ còn một chuỗi dài 32*32 = 1024, nhưng giờ đây là các số nguyên trong khoảng 0..511. Nói cách khác, chúng ta đang thu nhỏ độ dài chuỗi với cái giá là một ma trận nhúng lớn hơn. Nói cách khác, kích thước từ vựng của ImageGPT là 512, + 1 cho một token đặc biệt "start of sentence" (SOS), được sử dụng ở đầu mỗi chuỗi. Bạn có thể sử dụng [ImageGPTImageProcessor](/docs/transformers/main/vi/model_doc/imagegpt#transformers.ImageGPTImageProcessor) để chuẩn bị hình ảnh cho mô hình.
- Mặc dù được huấn luyện trước hoàn toàn không giám sát (tức là không sử dụng bất kỳ nhãn nào), ImageGPT tạo ra các đặc trưng hình ảnh khá hiệu quả, hữu ích cho các tác vụ hạ nguồn như phân loại hình ảnh. Các tác giả đã chỉ ra rằng các đặc trưng ở phần giữa của mạng là hiệu quả nhất và có thể được sử dụng trực tiếp để huấn luyện một mô hình tuyến tính (chẳng hạn như mô hình hồi quy logistic của sklearn). Điều này còn được gọi là "linear probing". Các đặc trưng có thể dễ dàng thu được bằng cách trước tiên đưa hình ảnh qua mô hình, sau đó chỉ định `output_hidden_states=True`, và cuối cùng thực hiện average-pool trên các trạng thái ẩn ở bất kỳ lớp nào bạn muốn.
- Ngoài ra, bạn có thể tinh chỉnh thêm toàn bộ mô hình trên một tập dữ liệu hạ nguồn, tương tự như BERT. Để làm điều này, bạn có thể sử dụng [ImageGPTForImageClassification](/docs/transformers/main/vi/model_doc/imagegpt#transformers.ImageGPTForImageClassification).
- ImageGPT có các kích thước khác nhau: có ImageGPT-small, ImageGPT-medium và ImageGPT-large. Các tác giả cũng đã huấn luyện một biến thể XL, nhưng họ không phát hành nó. Sự khác biệt về kích thước được tóm tắt trong bảng sau:
| **Biến thể mô hình** | **Độ sâu** | **Kích thước ẩn** | **Kích thước ẩn của bộ giải mã** | **Số tham số (M)** | **ImageNet-1k Top 1** |
|---|---|---|---|---|---|
| MiT-b0 | [2, 2, 2, 2] | [32, 64, 160, 256] | 256 | 3.7 | 70.5 |
| MiT-b1 | [2, 2, 2, 2] | [64, 128, 320, 512] | 256 | 14.0 | 78.7 |
| MiT-b2 | [3, 4, 6, 3] | [64, 128, 320, 512] | 768 | 25.4 | 81.6 |
| MiT-b3 | [3, 4, 18, 3] | [64, 128, 320, 512] | 768 | 45.2 | 83.1 |
| MiT-b4 | [3, 8, 27, 3] | [64, 128, 320, 512] | 768 | 62.6 | 83.6 |
| MiT-b5 | [3, 6, 40, 3] | [64, 128, 320, 512] | 768 | 82.0 | 83.8 |
## Tài nguyên
Danh sách các tài nguyên chính thức của Hugging Face và cộng đồng (được đánh dấu bằng 🌎) để giúp bạn bắt đầu với ImageGPT.
- Các notebook demo cho ImageGPT có thể được tìm thấy [tại đây](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/ImageGPT).
- [ImageGPTForImageClassification](/docs/transformers/main/vi/model_doc/imagegpt#transformers.ImageGPTForImageClassification) được hỗ trợ bởi [notebook](https://colab.research.google.com/github/huggingface/notebooks/blob/main/examples/image_classification.ipynb) này.
- Xem thêm: [Hướng dẫn tác vụ phân loại hình ảnh](../tasks/image_classification)
Nếu bạn quan tâm đến việc gửi một tài nguyên để được đưa vào đây, hãy thoải mái mở một Pull Request và chúng tôi sẽ xem xét! Lý tưởng nhất là tài nguyên nên minh họa một điều gì đó mới thay vì sao chép một tài nguyên hiện có.
## ImageGPTConfig[[transformers.ImageGPTConfig]]
#### transformers.ImageGPTConfig[[transformers.ImageGPTConfig]]
```python
transformers.ImageGPTConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 513, n_positions: int = 1024, n_embd: int = 512, n_layer: int = 24, n_head: int = 8, n_inner: int | None = None, activation_function: str = 'quick_gelu', resid_pdrop: float | int = 0.1, embd_pdrop: float | int = 0.1, attn_pdrop: float | int = 0.1, layer_norm_epsilon: float = 1e-05, initializer_range: float = 0.02, scale_attn_weights: bool = True, use_cache: bool = True, tie_word_embeddings: bool = False, scale_attn_by_inverse_layer_idx: bool = False, reorder_and_upcast_attn: bool = False, add_cross_attention: bool = False, pad_token_id: int | None = None, bos_token_id: int | None = None, eos_token_id: int | list[int] | None = None)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/imagegpt/configuration_imagegpt.py#L24)
**Tham số:**
vocab_size (`int`, *tùy chọn*, mặc định là `513`) : Kích thước từ vựng của mô hình. Xác định số lượng token khác nhau có thể được biểu diễn bởi `input_ids`.
n_positions (`int`, *tuỳ chọn*, mặc định là `1024`) : Độ dài chuỗi tối đa mà mô hình này có thể được sử dụng.
n_embd (`int`, *tuỳ chọn*, mặc định là `512`) : Độ chiều của các embedding và trạng thái ẩn.
n_layer (`int`, *tuỳ chọn*, mặc định là `24`) : Số lượng lớp ẩn trong bộ giải mã Transformer.
n_head (`int`, *tuỳ chọn*, mặc định là `8`) : Số lượng đầu chú ý cho mỗi lớp chú ý trong bộ giải mã Transformer.
n_inner (`int`, *tùy chọn*) : Kích thước của các biểu diễn MLP.
activation_function (`str`, *tùy chọn*, mặc định là `quick_gelu`) : Hàm kích hoạt phi tuyến (hàm hoặc chuỗi) trong bộ giải mã. Ví dụ, `"gelu"`, `"relu"`, `"silu"`, v.v.
resid_pdrop (`Union[float, int]`, *tùy chọn*, mặc định là `0.1`) : Xác suất dropout cho tất cả các lớp fully connected trong embeddings, encoder và pooler.
embd_pdrop (`Union[float, int]`, *tùy chọn*, mặc định là `0.1`) : Tỷ lệ dropout cho các embedding.
attn_pdrop (`Union[float, int]`, *tùy chọn*, mặc định là `0.1`) : Tỷ lệ dropout cho các xác suất chú ý.
layer_norm_epsilon (`float`, *tuỳ chọn*, mặc định là `1e-05`) : Epsilon được sử dụng bởi các lớp chuẩn hóa lớp (layer normalization).
initializer_range (`float`, *optional*, mặc định là `0.02`) : Độ lệch chuẩn của truncated_normal_initializer để khởi tạo tất cả các ma trận trọng số.
scale_attn_weights (`bool`, *tùy chọn*, mặc định là `True`) : Có nên chia embeddings cho sqrt(d_model) để chuẩn hóa hay không.
use_cache (`bool`, *tùy chọn*, mặc định là `True`) : Xác định xem mô hình có nên trả về các chú ý key/values cuối cùng hay không (không được sử dụng bởi tất cả các mô hình). Chỉ liên quan nếu `config.is_decoder=True` hoặc khi mô hình là mô hình sinh chỉ có decoder.
tie_word_embeddings (`bool`, *tùy chọn*, mặc định là `False`) : Có nên gắn kết các nhúng trọng số theo ánh xạ `tied_weights_keys` của mô hình hay không.
scale_attn_by_inverse_layer_idx (`bool`, *tùy chọn*, mặc định là `False`) : Có nhân thêm trọng số chú ý với `1 / layer_idx + 1` hay không.
reorder_and_upcast_attn (`bool`, *tùy chọn*, mặc định là `False`) : Có nên nhân các key (K) trước khi tính attention (tích vô hướng) và nâng cấp tích vô hướng/softmax của attention lên float() khi huấn luyện với độ chính xác hỗn hợp hay không.
add_cross_attention (`bool`, *tùy chọn*, mặc định là `False`) : Xác định xem có nên thêm các lớp cross-attention vào mô hình hay không.
pad_token_id (`int`, *tùy chọn*) : Id của token được sử dụng để đệm (padding) trong từ vựng.
bos_token_id (`int`, *tùy chọn*) : Id của token được sử dụng cho đầu luồng trong bảng từ vựng.
eos_token_id (`Union[int, list[int]]`, *tùy chọn*) : Id của token được sử dụng cho end-of-stream trong bảng từ vựng.
Đây là lớp cấu hình để lưu trữ cấu hình của một ImageGPTModel. Nó được sử dụng để khởi tạo một mô hình Imagegpt theo các đối số được chỉ định, xác định kiến trúc của mô hình. Khởi tạo một cấu hình với các giá trị mặc định sẽ tạo ra một cấu hình tương tự như cấu hình của [openai/imagegpt-small](https://huggingface.co/openai/imagegpt-small)
Các đối tượng cấu hình kế thừa từ [PreTrainedConfig](/docs/transformers/main/vi/main_classes/configuration#transformers.PreTrainedConfig) và có thể được sử dụng để kiểm soát đầu ra của mô hình. Đọc tài liệu từ [PreTrainedConfig](/docs/transformers/main/vi/main_classes/configuration#transformers.PreTrainedConfig) để biết thêm thông tin.
Ví dụ:
```python
>>> from transformers import ImageGPTConfig, ImageGPTModel
>>> # Initializing a ImageGPT configuration
>>> configuration = ImageGPTConfig()
>>> # Initializing a model (with random weights) from the configuration
>>> model = ImageGPTModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ImageGPTImageProcessor[[transformers.ImageGPTImageProcessor]]
#### transformers.ImageGPTImageProcessor[[transformers.ImageGPTImageProcessor]]
```python
transformers.ImageGPTImageProcessor(clusters: typing.Union[list, numpy.ndarray, torch.Tensor, NoneType] = None, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/imagegpt/image_processing_imagegpt.py#L82)
**Tham số:**
clusters (`np.ndarray` hoặc `list[list[int]]` hoặc `torch.Tensor`, *tùy chọn*) : Các cụm màu cần sử dụng, có hình dạng `(n_clusters, 3)` khi lượng tử hóa màu. Có thể bị ghi đè bởi `clusters` trong `preprocess`.
do_convert_rgb (`bool`, *kwargs*, *optional*) : Có chuyển đổi hình ảnh sang RGB hay không.
do_resize (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Xác định có thay đổi kích thước ảnh hay không.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, mặc định là `{'height' : 256, 'width': 256}`): Mô tả kích thước đầu vào tối đa cho mô hình.
default_to_square (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Có nên mặc định sử dụng ảnh vuông khi thay đổi kích thước hay không, nếu size là một số nguyên.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước của ảnh đầu ra sau khi áp dụng `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, mặc định là `2`) : Bộ lọc lấy mẫu lại (resampling filter) được sử dụng khi thay đổi kích thước ảnh. Giá trị này có thể là một trong các hằng số liệt kê (enum) của `PILImageResampling`. Chỉ có hiệu lực khi `do_resize` được đặt thành `True`.
do_rescale (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Xác định có nên điều chỉnh lại tỷ lệ ảnh hay không.
rescale_factor (`float`, *kwargs*, *optional*, mặc định là `0.00392156862745098`) : Hệ số để điều chỉnh lại kích thước ảnh nếu `do_rescale` được đặt thành `True`.
do_normalize (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Có chuẩn hóa hình ảnh hay không.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, mặc định là `[0.5, 0.5, 0.5]`) : Giá trị trung bình của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, mặc định là `[0.5, 0.5, 0.5]`) : Độ lệch chuẩn của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
do_pad (`bool`, *kwargs*, *optional*) : Xác định có chèn padding cho ảnh hay không. Padding được thực hiện đến kích thước lớn nhất trong batch hoặc đến một kích thước vuông cố định cho mỗi ảnh. Chiến lược padding cụ thể phụ thuộc vào model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước ở dạng `{"height": int, "width" int}` để đệm (pad) các ảnh. Phải lớn hơn kích thước của bất kỳ ảnh nào được cung cấp cho tiền xử lý. Nếu `pad_size` không được cung cấp, các ảnh sẽ được đệm đến chiều cao và chiều rộng lớn nhất trong batch. Chỉ được áp dụng khi `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Có nên cắt ảnh theo kiểu căn giữa hay không.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *tuỳ chọn*) : Chỉ hỗ trợ `ChannelDimension.FIRST`. Được thêm vào để tương thích với các bộ xử lý chậm.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Định dạng chiều kênh cho ảnh đầu vào. Nếu không được đặt, định dạng chiều kênh sẽ được suy ra từ ảnh đầu vào. Có thể là một trong các giá trị sau: - `"channels_first"` hoặc `ChannelDimension.FIRST`: ảnh ở định dạng (num_channels, height, width). - `"channels_last"` hoặc `ChannelDimension.LAST`: ảnh ở định dạng (height, width, num_channels). - `"none"` hoặc `ChannelDimension.NONE`: ảnh ở định dạng (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Thiết bị để xử lý các video. Nếu không được đặt, thiết bị sẽ được suy ra từ các video đầu vào.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Trả về các tensor đã xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor.
disable_grouping (`bool`, *kwargs*, *optional*) : Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *tuỳ chọn*) : Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý.
clusters (`np.ndarray`, *kwargs* hoặc `list[list[int]]` hoặc `torch.Tensor`, *tuỳ chọn*, mặc định là `self.clusters`) : Các cụm màu cần sử dụng, có hình dạng `(n_clusters, 3)` khi lượng tử hóa màu. Có thể được ghi đè bởi `clusters` trong `preprocess`.
do_color_quantize (`bool`, *kwargs*, *optional*, mặc định là `self.do_color_quantize`) : Kiểm soát việc có áp dụng lượng tử hóa màu để chuyển các giá trị pixel liên tục thành các chỉ số cụm rời rạc hay không. Khi là True, mỗi pixel được gán vào cụm màu gần nhất, cho phép mô hình hóa token rời rạc của ImageGPT.
Tạo một bộ xử lý ảnh ImageGPTImageProcessor.
#### preprocess[[transformers.ImageGPTImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Tham số:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ảnh cần tiền xử lý. Kỳ vọng một ảnh đơn hoặc một lô ảnh có giá trị pixel từ 0 đến 255. Nếu truyền vào các ảnh có giá trị pixel từ 0 đến 1, hãy đặt `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *tùy chọn*) : Cờ dành cho nhà phát triển cho các đầu vào dạng ảnh bổ sung cũng sẽ được tiền xử lý. Chỉ sử dụng cờ này nếu việc truyền các đầu vào dưới dạng kwarg không hoạt động. Ví dụ, `preprocess(images, masks=masks)` là tùy chọn được ưu tiên nhưng có thể gây ra các vấn đề về thứ tự ưu tiên của đối số đối với một số mô hình. Trong những trường hợp đó, có thể sử dụng `preprocess(images, image_like_inputs={"masks": masks})` thay thế.
do_convert_rgb (`bool`, *kwargs*, *optional*) : Có chuyển đổi hình ảnh sang RGB hay không.
do_resize (`bool`, *kwargs*, *optional*) : Xác định có nên thay đổi kích thước ảnh hay không.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*): Mô tả các kích thước đầu vào tối đa của mô hình.
default_to_square (`bool`, *kwargs*, *tuỳ chọn*) : Có mặc định dùng ảnh vuông khi thay đổi kích thước hay không, nếu size là một số nguyên.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước của ảnh đầu ra sau khi áp dụng `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Bộ lọc resampling để sử dụng khi thay đổi kích thước ảnh. Giá trị này có thể là một trong các enum `PILImageResampling`. Chỉ có hiệu lực khi `do_resize` được đặt thành `True`.
do_rescale (`bool`, *kwargs*, *tuỳ chọn*) : Xác định có nên điều chỉnh lại tỷ lệ hình ảnh hay không.
rescale_factor (`float`, *kwargs*, *optional*) : Hệ số để thay đổi tỷ lệ ảnh nếu `do_rescale` được đặt thành `True`.
do_normalize (`bool`, *kwargs*, *tuỳ chọn*) : Xác định có chuẩn hóa hình ảnh hay không.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Giá trị trung bình của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Độ lệch chuẩn của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
do_pad (`bool`, *kwargs*, *optional*) : Xác định có chèn padding cho ảnh hay không. Padding được thực hiện đến kích thước lớn nhất trong batch hoặc đến một kích thước vuông cố định cho mỗi ảnh. Chiến lược padding cụ thể phụ thuộc vào model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước ở dạng `{"height": int, "width" int}` để đệm (pad) các ảnh. Phải lớn hơn kích thước của bất kỳ ảnh nào được cung cấp cho tiền xử lý. Nếu `pad_size` không được cung cấp, các ảnh sẽ được đệm đến chiều cao và chiều rộng lớn nhất trong batch. Chỉ được áp dụng khi `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Có nên cắt ảnh theo kiểu căn giữa hay không.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *tuỳ chọn*) : Chỉ hỗ trợ `ChannelDimension.FIRST`. Được thêm vào để tương thích với các bộ xử lý chậm.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Định dạng chiều kênh cho ảnh đầu vào. Nếu không được đặt, định dạng chiều kênh sẽ được suy ra từ ảnh đầu vào. Có thể là một trong các giá trị sau: - `"channels_first"` hoặc `ChannelDimension.FIRST`: ảnh ở định dạng (num_channels, height, width). - `"channels_last"` hoặc `ChannelDimension.LAST`: ảnh ở định dạng (height, width, num_channels). - `"none"` hoặc `ChannelDimension.NONE`: ảnh ở định dạng (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Thiết bị để xử lý các video. Nếu không được đặt, thiết bị sẽ được suy ra từ các video đầu vào.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Trả về các tensor đã xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor.
disable_grouping (`bool`, *kwargs*, *optional*) : Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *tuỳ chọn*) : Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý.
**Trả về:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Từ điển chứa các danh sách/mảng/tensor được trả về bởi phương thức __call__ ('pixel_values', v.v.).
- **tensor_type** (`Union[None, str, TensorType]`, *tùy chọn*) -- Bạn có thể cung cấp tensor_type tại đây để chuyển đổi các danh sách số nguyên trong Tensor PyTorch/Numpy khi khởi tạo.
Tiền xử lý một hình ảnh hoặc một lô hình ảnh.
## ImageGPTImageProcessorPil[[transformers.ImageGPTImageProcessorPil]]
#### transformers.ImageGPTImageProcessorPil[[transformers.ImageGPTImageProcessorPil]]
```python
transformers.ImageGPTImageProcessorPil(clusters: list | np.ndarray | torch.Tensor | None = None, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/imagegpt/image_processing_pil_imagegpt.py#L69)
**Tham số:**
clusters (`np.ndarray` hoặc `list[list[int]]` hoặc `torch.Tensor`, *tùy chọn*) : Các cụm màu cần sử dụng, có hình dạng `(n_clusters, 3)` khi lượng tử hóa màu. Có thể bị ghi đè bởi `clusters` trong `preprocess`.
do_convert_rgb (`bool`, *kwargs*, *optional*) : Có chuyển đổi hình ảnh sang RGB hay không.
do_resize (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Xác định có thay đổi kích thước ảnh hay không.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, mặc định là `{'height' : 256, 'width': 256}`): Mô tả kích thước đầu vào tối đa cho mô hình.
default_to_square (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Có nên mặc định sử dụng ảnh vuông khi thay đổi kích thước hay không, nếu size là một số nguyên.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước của ảnh đầu ra sau khi áp dụng `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, mặc định là `2`) : Bộ lọc lấy mẫu lại (resampling filter) được sử dụng khi thay đổi kích thước ảnh. Giá trị này có thể là một trong các hằng số liệt kê (enum) của `PILImageResampling`. Chỉ có hiệu lực khi `do_resize` được đặt thành `True`.
do_rescale (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Xác định có nên điều chỉnh lại tỷ lệ ảnh hay không.
rescale_factor (`float`, *kwargs*, *optional*, mặc định là `0.00392156862745098`) : Hệ số để điều chỉnh lại kích thước ảnh nếu `do_rescale` được đặt thành `True`.
do_normalize (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Có chuẩn hóa hình ảnh hay không.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, mặc định là `[0.5, 0.5, 0.5]`) : Giá trị trung bình của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, mặc định là `[0.5, 0.5, 0.5]`) : Độ lệch chuẩn của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
do_pad (`bool`, *kwargs*, *optional*) : Xác định có chèn padding cho ảnh hay không. Padding được thực hiện đến kích thước lớn nhất trong batch hoặc đến một kích thước vuông cố định cho mỗi ảnh. Chiến lược padding cụ thể phụ thuộc vào model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước ở dạng `{"height": int, "width" int}` để đệm (pad) các ảnh. Phải lớn hơn kích thước của bất kỳ ảnh nào được cung cấp cho tiền xử lý. Nếu `pad_size` không được cung cấp, các ảnh sẽ được đệm đến chiều cao và chiều rộng lớn nhất trong batch. Chỉ được áp dụng khi `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Có nên cắt ảnh theo kiểu căn giữa hay không.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *tuỳ chọn*) : Chỉ hỗ trợ `ChannelDimension.FIRST`. Được thêm vào để tương thích với các bộ xử lý chậm.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Định dạng chiều kênh cho ảnh đầu vào. Nếu không được đặt, định dạng chiều kênh sẽ được suy ra từ ảnh đầu vào. Có thể là một trong các giá trị sau: - `"channels_first"` hoặc `ChannelDimension.FIRST`: ảnh ở định dạng (num_channels, height, width). - `"channels_last"` hoặc `ChannelDimension.LAST`: ảnh ở định dạng (height, width, num_channels). - `"none"` hoặc `ChannelDimension.NONE`: ảnh ở định dạng (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Thiết bị để xử lý các video. Nếu không được đặt, thiết bị sẽ được suy ra từ các video đầu vào.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Trả về các tensor đã xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor.
disable_grouping (`bool`, *kwargs*, *optional*) : Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *tuỳ chọn*) : Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý.
clusters (`np.ndarray`, *kwargs* hoặc `list[list[int]]` hoặc `torch.Tensor`, *tuỳ chọn*, mặc định là `self.clusters`) : Các cụm màu cần sử dụng, có hình dạng `(n_clusters, 3)` khi lượng tử hóa màu. Có thể được ghi đè bởi `clusters` trong `preprocess`.
do_color_quantize (`bool`, *kwargs*, *optional*, mặc định là `self.do_color_quantize`) : Kiểm soát việc có áp dụng lượng tử hóa màu để chuyển các giá trị pixel liên tục thành các chỉ số cụm rời rạc hay không. Khi là True, mỗi pixel được gán vào cụm màu gần nhất, cho phép mô hình hóa token rời rạc của ImageGPT.
Tạo một bộ xử lý ảnh ImageGPTImageProcessor.
#### preprocess[[transformers.ImageGPTImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Tham số:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ảnh cần tiền xử lý. Kỳ vọng một ảnh đơn hoặc một lô ảnh có giá trị pixel từ 0 đến 255. Nếu truyền vào các ảnh có giá trị pixel từ 0 đến 1, hãy đặt `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *tùy chọn*) : Cờ dành cho nhà phát triển cho các đầu vào dạng ảnh bổ sung cũng sẽ được tiền xử lý. Chỉ sử dụng cờ này nếu việc truyền các đầu vào dưới dạng kwarg không hoạt động. Ví dụ, `preprocess(images, masks=masks)` là tùy chọn được ưu tiên nhưng có thể gây ra các vấn đề về thứ tự ưu tiên của đối số đối với một số mô hình. Trong những trường hợp đó, có thể sử dụng `preprocess(images, image_like_inputs={"masks": masks})` thay thế.
do_convert_rgb (`bool`, *kwargs*, *optional*) : Có chuyển đổi hình ảnh sang RGB hay không.
do_resize (`bool`, *kwargs*, *optional*) : Xác định có nên thay đổi kích thước ảnh hay không.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*): Mô tả các kích thước đầu vào tối đa của mô hình.
default_to_square (`bool`, *kwargs*, *tuỳ chọn*) : Có mặc định dùng ảnh vuông khi thay đổi kích thước hay không, nếu size là một số nguyên.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước của ảnh đầu ra sau khi áp dụng `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Bộ lọc resampling để sử dụng khi thay đổi kích thước ảnh. Giá trị này có thể là một trong các enum `PILImageResampling`. Chỉ có hiệu lực khi `do_resize` được đặt thành `True`.
do_rescale (`bool`, *kwargs*, *tuỳ chọn*) : Xác định có nên điều chỉnh lại tỷ lệ hình ảnh hay không.
rescale_factor (`float`, *kwargs*, *optional*) : Hệ số để thay đổi tỷ lệ ảnh nếu `do_rescale` được đặt thành `True`.
do_normalize (`bool`, *kwargs*, *tuỳ chọn*) : Xác định có chuẩn hóa hình ảnh hay không.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Giá trị trung bình của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Độ lệch chuẩn của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
do_pad (`bool`, *kwargs*, *optional*) : Xác định có chèn padding cho ảnh hay không. Padding được thực hiện đến kích thước lớn nhất trong batch hoặc đến một kích thước vuông cố định cho mỗi ảnh. Chiến lược padding cụ thể phụ thuộc vào model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước ở dạng `{"height": int, "width" int}` để đệm (pad) các ảnh. Phải lớn hơn kích thước của bất kỳ ảnh nào được cung cấp cho tiền xử lý. Nếu `pad_size` không được cung cấp, các ảnh sẽ được đệm đến chiều cao và chiều rộng lớn nhất trong batch. Chỉ được áp dụng khi `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Có nên cắt ảnh theo kiểu căn giữa hay không.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *tuỳ chọn*) : Chỉ hỗ trợ `ChannelDimension.FIRST`. Được thêm vào để tương thích với các bộ xử lý chậm.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Định dạng chiều kênh cho ảnh đầu vào. Nếu không được đặt, định dạng chiều kênh sẽ được suy ra từ ảnh đầu vào. Có thể là một trong các giá trị sau: - `"channels_first"` hoặc `ChannelDimension.FIRST`: ảnh ở định dạng (num_channels, height, width). - `"channels_last"` hoặc `ChannelDimension.LAST`: ảnh ở định dạng (height, width, num_channels). - `"none"` hoặc `ChannelDimension.NONE`: ảnh ở định dạng (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Thiết bị để xử lý các video. Nếu không được đặt, thiết bị sẽ được suy ra từ các video đầu vào.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Trả về các tensor đã xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor.
disable_grouping (`bool`, *kwargs*, *optional*) : Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *tuỳ chọn*) : Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý.
**Trả về:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Từ điển chứa các danh sách/mảng/tensor được trả về bởi phương thức __call__ ('pixel_values', v.v.).
- **tensor_type** (`Union[None, str, TensorType]`, *tùy chọn*) -- Bạn có thể cung cấp tensor_type tại đây để chuyển đổi các danh sách số nguyên trong Tensor PyTorch/Numpy khi khởi tạo.
Tiền xử lý một hình ảnh hoặc một lô hình ảnh.
## ImageGPTModel[[transformers.ImageGPTModel]]
#### transformers.ImageGPTModel[[transformers.ImageGPTModel]]
```python
transformers.ImageGPTModel(config: ImageGPTConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/imagegpt/modeling_imagegpt.py#L393)
**Tham số:**
config ([ImageGPTConfig](/docs/transformers/main/vi/model_doc/imagegpt#transformers.ImageGPTConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số mô hình.
Mô hình Imagegpt cơ bản, xuất ra các hidden-states thô mà không có bất kỳ head cụ thể nào ở phía trên.
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.ImageGPTModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, encoder_hidden_states: typing.Optional[torch.Tensor] = None, encoder_attention_mask: typing.Optional[torch.Tensor] = None, use_cache: bool | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs: Any)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/imagegpt/modeling_imagegpt.py#L416)
**Tham số:**
input_ids (`torch.LongTensor` có shape `(batch_size, input_ids_length)`) : `input_ids_length` = `sequence_length` nếu `past_key_values` là `None`, ngược lại là `past_key_values.get_seq_length()` (`sequence_length` của các trạng thái past key value đầu vào). Chỉ số của các token trong chuỗi đầu vào theo từ điển. Nếu sử dụng `past_key_values`, chỉ cần truyền các `input_ids` chưa được tính toán phần past vào như `input_ids`. Có thể lấy chỉ số bằng cách sử dụng [AutoImageProcessor](/docs/transformers/main/vi/model_doc/auto#transformers.AutoImageProcessor). Xem [ImageGPTImageProcessor.__call__()](/docs/transformers/main/vi/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) để biết thêm chi tiết.
past_key_values (`~cache_utils.Cache`, *tùy chọn*) : Các hidden-states đã tính trước (key và values trong các khối self-attention và cross-attention) có thể được sử dụng để tăng tốc giải mã tuần tự. Điều này thường bao gồm `past_key_values` do mô hình trả về ở một giai đoạn giải mã trước đó, khi `use_cache=True` hoặc `config.use_cache=True`. Chỉ cho phép [Cache](/docs/transformers/main/vi/internal/generation_utils#transformers.Cache) instance làm đầu vào, xem [hướng dẫn kv cache](https://huggingface.co/docs/transformers/en/kv_cache) của chúng tôi. Nếu không truyền `past_key_values`, [DynamicCache](/docs/transformers/main/vi/internal/generation_utils#transformers.DynamicCache) sẽ được khởi tạo theo mặc định. Mô hình sẽ xuất ra cùng định dạng cache được đưa vào làm đầu vào. Nếu sử dụng `past_key_values`, người dùng được kỳ vọng chỉ nhập các `input_ids` chưa được xử lý (những phần chưa có trạng thái key value quá khứ được cung cấp cho mô hình này) có shape `(batch_size, unprocessed_length)` thay vì tất cả `input_ids` có shape `(batch_size, sequence_length)`.
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số token phân đoạn để chỉ định phần đầu và phần thứ hai của các đầu vào. Các chỉ số được chọn trong `[0, 1]`: - 0 tương ứng với token *câu A*, - 1 tương ứng với token *câu B*. [Các ID loại token là gì?](../glossary#token-type-ids)
position_ids (`torch.Tensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của vị trí các token trong mỗi chuỗi đầu vào trong các position embeddings. Được chọn trong khoảng `[0, config.n_positions - 1]`. [Position IDs là gì?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `input_ids`, bạn có thể chọn cách truyền trực tiếp một biểu diễn nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi các chỉ số `input_ids` thành các vector liên quan so với ma trận tra cứu nhúng nội bộ của mô hình.
encoder_hidden_states (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`, *tùy chọn*) : Chuỗi các hidden-states tại đầu ra của lớp cuối cùng của encoder. Được sử dụng trong cross-attention nếu mô hình được cấu hình như một decoder.
encoder_attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm của đầu vào bộ mã hóa. Mặt nạ này được sử dụng trong chú ý chéo nếu mô hình được cấu hình như một bộ giải mã. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**.
use_cache (`bool`, *tùy chọn*) : Nếu được đặt thành `True`, các trạng thái khóa và giá trị `past_key_values` sẽ được trả về và có thể được sử dụng để tăng tốc quá trình giải mã (xem `past_key_values`).
output_attentions (`bool`, *tùy chọn*) : Có trả về các tensor chú ý của tất cả các lớp chú ý hay không. Xem `attentions` trong phần tensor trả về để biết thêm chi tiết.
output_hidden_states (`bool`, *tuỳ chọn*) : Có trả về trạng thái ẩn của tất cả các lớp hay không. Xem `hidden_states` trong phần tensor trả về để biết thêm chi tiết.
return_dict (`bool`, *tùy chọn*) : Có trả về [ModelOutput](/docs/transformers/main/vi/main_classes/output#transformers.utils.ModelOutput) thay vì một tuple thông thường hay không.
**Trả về:** [BaseModelOutputWithPastAndCrossAttentions](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPastAndCrossAttentions) hoặc `tuple(torch.Tensor)`
Một [BaseModelOutputWithPastAndCrossAttentions](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPastAndCrossAttentions) hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([ImageGPTConfig](/docs/transformers/main/vi/model_doc/imagegpt#transformers.ImageGPTConfig)) và đầu vào.
Phương thức forward của [ImageGPTModel](/docs/transformers/main/vi/model_doc/imagegpt#transformers.ImageGPTModel) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **last_hidden_state** (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`) -- Chuỗi các hidden-state tại đầu ra của lớp cuối cùng của mô hình.
Nếu `past_key_values` được sử dụng, chỉ có hidden-state cuối cùng của các chuỗi có shape `(batch_size, 1, hidden_size)` được xuất ra.
- **past_key_values** (`Cache`, *tùy chọn*, được trả về khi `use_cache=True` được truyền vào hoặc khi `config.use_cache=True`) -- Đây là một instance của [Cache](/docs/transformers/main/vi/internal/generation_utils#transformers.Cache). Để biết thêm chi tiết, hãy xem [hướng dẫn về kv cache](https://huggingface.co/docs/transformers/en/kv_cache) của chúng tôi.
Chứa các hidden-states đã được tính trước (key và values trong các khối self-attention và tùy chọn nếu `config.is_encoder_decoder=True` trong các khối cross-attention) có thể được sử dụng (xem đầu vào `past_key_values`) để tăng tốc độ giải mã tuần tự.
- **hidden_states** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple của `torch.Tensor` (một cho đầu ra của các embedding, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
- **cross_attentions** (`tuple(torch.Tensor)`, *tùy chọn*, được trả về khi `output_attentions=True` và `config.add_cross_attention=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý của lớp cross-attention của bộ giải mã, sau softmax chú ý, được sử dụng để tính trung bình có trọng số trong các đầu chú ý chéo.
Ví dụ:
```python
>>> from transformers import AutoImageProcessor, ImageGPTModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("openai/imagegpt-small")
>>> model = ImageGPTModel.from_pretrained("openai/imagegpt-small")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
```
## ImageGPTForCausalImageModeling[[transformers.ImageGPTForCausalImageModeling]]
#### transformers.ImageGPTForCausalImageModeling[[transformers.ImageGPTForCausalImageModeling]]
```python
transformers.ImageGPTForCausalImageModeling(config: ImageGPTConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/imagegpt/modeling_imagegpt.py#L594)
**Tham số:**
config ([ImageGPTConfig](/docs/transformers/main/vi/model_doc/imagegpt#transformers.ImageGPTConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số mô hình.
Model transformer của ImageGPT với đầu mô hình hóa ngôn ngữ ở trên (tầng tuyến tính có trọng số được liên kết với các nhúng đầu vào).
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.ImageGPTForCausalImageModeling.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, encoder_hidden_states: typing.Optional[torch.Tensor] = None, encoder_attention_mask: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, use_cache: bool | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs: Any)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/imagegpt/modeling_imagegpt.py#L605)
**Tham số:**
input_ids (`torch.LongTensor` có shape `(batch_size, input_ids_length)`) : `input_ids_length` = `sequence_length` nếu `past_key_values` là `None`, ngược lại là `past_key_values.get_seq_length()` (`sequence_length` của các trạng thái past key value đầu vào). Chỉ số của các token trong chuỗi đầu vào theo từ điển. Nếu sử dụng `past_key_values`, chỉ cần truyền các `input_ids` chưa được tính toán phần past vào như `input_ids`. Có thể lấy chỉ số bằng cách sử dụng [AutoImageProcessor](/docs/transformers/main/vi/model_doc/auto#transformers.AutoImageProcessor). Xem [ImageGPTImageProcessor.__call__()](/docs/transformers/main/vi/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) để biết thêm chi tiết.
past_key_values (`~cache_utils.Cache`, *tùy chọn*) : Các hidden-states đã tính trước (key và values trong các khối self-attention và cross-attention) có thể được sử dụng để tăng tốc giải mã tuần tự. Điều này thường bao gồm `past_key_values` do mô hình trả về ở một giai đoạn giải mã trước đó, khi `use_cache=True` hoặc `config.use_cache=True`. Chỉ cho phép [Cache](/docs/transformers/main/vi/internal/generation_utils#transformers.Cache) instance làm đầu vào, xem [hướng dẫn kv cache](https://huggingface.co/docs/transformers/en/kv_cache) của chúng tôi. Nếu không truyền `past_key_values`, [DynamicCache](/docs/transformers/main/vi/internal/generation_utils#transformers.DynamicCache) sẽ được khởi tạo theo mặc định. Mô hình sẽ xuất ra cùng định dạng cache được đưa vào làm đầu vào. Nếu sử dụng `past_key_values`, người dùng được kỳ vọng chỉ nhập các `input_ids` chưa được xử lý (những phần chưa có trạng thái key value quá khứ được cung cấp cho mô hình này) có shape `(batch_size, unprocessed_length)` thay vì tất cả `input_ids` có shape `(batch_size, sequence_length)`.
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số token phân đoạn để chỉ định phần đầu và phần thứ hai của các đầu vào. Các chỉ số được chọn trong `[0, 1]`: - 0 tương ứng với token *câu A*, - 1 tương ứng với token *câu B*. [Các ID loại token là gì?](../glossary#token-type-ids)
position_ids (`torch.Tensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của vị trí các token trong mỗi chuỗi đầu vào trong các position embeddings. Được chọn trong khoảng `[0, config.n_positions - 1]`. [Position IDs là gì?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `input_ids`, bạn có thể chọn cách truyền trực tiếp một biểu diễn nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi các chỉ số `input_ids` thành các vector liên quan so với ma trận tra cứu nhúng nội bộ của mô hình.
encoder_hidden_states (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`, *tùy chọn*) : Chuỗi các hidden-states tại đầu ra của lớp cuối cùng của encoder. Được sử dụng trong cross-attention nếu mô hình được cấu hình như một decoder.
encoder_attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm của đầu vào bộ mã hóa. Mặt nạ này được sử dụng trong chú ý chéo nếu mô hình được cấu hình như một bộ giải mã. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**.
labels (`torch.LongTensor` có hình dạng `(batch_size, input_ids_length)`, *tùy chọn*) : Nhãn cho mô hình hóa ngôn ngữ. Lưu ý rằng các nhãn **được dịch chuyển** bên trong mô hình, tức là bạn có thể đặt `labels = input_ids` Các chỉ số được chọn trong `[-100, 0, ..., config.vocab_size]` Tất cả các nhãn được đặt thành `-100` sẽ bị bỏ qua (che), tổn thất chỉ được tính cho các nhãn trong `[0, ..., config.vocab_size]`
use_cache (`bool`, *tùy chọn*) : Nếu được đặt thành `True`, các trạng thái khóa và giá trị `past_key_values` sẽ được trả về và có thể được sử dụng để tăng tốc quá trình giải mã (xem `past_key_values`).
output_attentions (`bool`, *tùy chọn*) : Có trả về các tensor chú ý của tất cả các lớp chú ý hay không. Xem `attentions` trong phần tensor trả về để biết thêm chi tiết.
output_hidden_states (`bool`, *tuỳ chọn*) : Có trả về trạng thái ẩn của tất cả các lớp hay không. Xem `hidden_states` trong phần tensor trả về để biết thêm chi tiết.
return_dict (`bool`, *tùy chọn*) : Có trả về [ModelOutput](/docs/transformers/main/vi/main_classes/output#transformers.utils.ModelOutput) thay vì một tuple thông thường hay không.
**Trả về:** [CausalLMOutputWithCrossAttentions](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.CausalLMOutputWithCrossAttentions) hoặc `tuple(torch.Tensor)`
Một [CausalLMOutputWithCrossAttentions](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.CausalLMOutputWithCrossAttentions) hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([ImageGPTConfig](/docs/transformers/main/vi/model_doc/imagegpt#transformers.ImageGPTConfig)) và đầu vào.
Phương thức forward của [ImageGPTForCausalImageModeling](/docs/transformers/main/vi/model_doc/imagegpt#transformers.ImageGPTForCausalImageModeling) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **loss** (`torch.Tensor` có shape `(1,)`, *optional*, được trả về khi `labels` được cung cấp) -- Loss của language modeling (cho next-token prediction).
- **logits** (`torch.Tensor` có hình dạng `(batch_size, sequence_length, config.vocab_size)`) -- Điểm dự đoán của đầu mô hình hóa ngôn ngữ (điểm cho mỗi token từ vựng trước SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple của `torch.Tensor` (một cho đầu ra của các embedding, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
- **cross_attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số của cross attention sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu cross-attention.
- **past_key_values** (`Cache`, *tùy chọn*, được trả về khi `use_cache=True` được truyền vào hoặc khi `config.use_cache=True`) -- Đây là một instance của [Cache](/docs/transformers/main/vi/internal/generation_utils#transformers.Cache). Để biết thêm chi tiết, hãy xem [hướng dẫn về kv cache](https://huggingface.co/docs/transformers/en/kv_cache) của chúng tôi.
Chứa các hidden-states đã được tính trước (key và values trong các khối attention) có thể được sử dụng (xem đầu vào `past_key_values`) để tăng tốc độ giải mã tuần tự.
Ví dụ:
```python
>>> from transformers import AutoImageProcessor, ImageGPTForCausalImageModeling
>>> import torch
>>> import matplotlib.pyplot as plt
>>> import numpy as np
>>> image_processor = AutoImageProcessor.from_pretrained("openai/imagegpt-small")
>>> model = ImageGPTForCausalImageModeling.from_pretrained("openai/imagegpt-small")
>>> device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
>>> model.to(device)
>>> # unconditional generation of 8 images
>>> batch_size = 4
>>> context = torch.full((batch_size, 1), model.config.vocab_size - 1) # initialize with SOS token
>>> context = context.to(device)
>>> output = model.generate(
... input_ids=context, max_length=model.config.n_positions + 1, temperature=1.0, do_sample=True, top_k=40
... )
>>> clusters = image_processor.clusters
>>> height = image_processor.size["height"]
>>> width = image_processor.size["width"]
>>> samples = output[:, 1:].detach().cpu().numpy()
>>> samples_img = [
... np.reshape(np.rint(127.5 * (clusters[s] + 1.0)), [height, width, 3]).astype(np.uint8) for s in samples
... ] # convert color cluster tokens back to pixels
>>> f, axes = plt.subplots(1, batch_size, dpi=300)
>>> for img, ax in zip(samples_img, axes):
... ax.axis("off")
... ax.imshow(img)
```
## ImageGPTForImageClassification[[transformers.ImageGPTForImageClassification]]
#### transformers.ImageGPTForImageClassification[[transformers.ImageGPTForImageClassification]]
```python
transformers.ImageGPTForImageClassification(config: ImageGPTConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/imagegpt/modeling_imagegpt.py#L723)
**Tham số:**
config ([ImageGPTConfig](/docs/transformers/main/vi/model_doc/imagegpt#transformers.ImageGPTConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số mô hình.
Model transformer ImageGPT với đầu phân loại hình ảnh phía trên (tầng tuyến tính). [ImageGPTForImageClassification](/docs/transformers/main/vi/model_doc/imagegpt#transformers.ImageGPTForImageClassification) thực hiện average-pooling trên các trạng thái ẩn để tiến hành phân loại.
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.ImageGPTForImageClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, use_cache: bool | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs: Any)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/imagegpt/modeling_imagegpt.py#L733)
**Tham số:**
input_ids (`torch.LongTensor` có shape `(batch_size, input_ids_length)`) : `input_ids_length` = `sequence_length` nếu `past_key_values` là `None`, ngược lại là `past_key_values.get_seq_length()` (`sequence_length` của các trạng thái past key value đầu vào). Chỉ số của các token trong chuỗi đầu vào theo từ điển. Nếu sử dụng `past_key_values`, chỉ cần truyền các `input_ids` chưa được tính toán phần past vào như `input_ids`. Có thể lấy chỉ số bằng cách sử dụng [AutoImageProcessor](/docs/transformers/main/vi/model_doc/auto#transformers.AutoImageProcessor). Xem [ImageGPTImageProcessor.__call__()](/docs/transformers/main/vi/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) để biết thêm chi tiết.
past_key_values (`~cache_utils.Cache`, *tùy chọn*) : Các hidden-states đã tính trước (key và values trong các khối self-attention và cross-attention) có thể được sử dụng để tăng tốc giải mã tuần tự. Điều này thường bao gồm `past_key_values` do mô hình trả về ở một giai đoạn giải mã trước đó, khi `use_cache=True` hoặc `config.use_cache=True`. Chỉ cho phép [Cache](/docs/transformers/main/vi/internal/generation_utils#transformers.Cache) instance làm đầu vào, xem [hướng dẫn kv cache](https://huggingface.co/docs/transformers/en/kv_cache) của chúng tôi. Nếu không truyền `past_key_values`, [DynamicCache](/docs/transformers/main/vi/internal/generation_utils#transformers.DynamicCache) sẽ được khởi tạo theo mặc định. Mô hình sẽ xuất ra cùng định dạng cache được đưa vào làm đầu vào. Nếu sử dụng `past_key_values`, người dùng được kỳ vọng chỉ nhập các `input_ids` chưa được xử lý (những phần chưa có trạng thái key value quá khứ được cung cấp cho mô hình này) có shape `(batch_size, unprocessed_length)` thay vì tất cả `input_ids` có shape `(batch_size, sequence_length)`.
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số token phân đoạn để chỉ định phần đầu và phần thứ hai của các đầu vào. Các chỉ số được chọn trong `[0, 1]`: - 0 tương ứng với token *câu A*, - 1 tương ứng với token *câu B*. [Các ID loại token là gì?](../glossary#token-type-ids)
position_ids (`torch.Tensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của vị trí các token trong mỗi chuỗi đầu vào trong các position embeddings. Được chọn trong khoảng `[0, config.n_positions - 1]`. [Position IDs là gì?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `input_ids`, bạn có thể chọn cách truyền trực tiếp một biểu diễn nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi các chỉ số `input_ids` thành các vector liên quan so với ma trận tra cứu nhúng nội bộ của mô hình.
labels (`torch.LongTensor` có hình dạng `(batch_size,)`, *tùy chọn*) : Nhãn để tính toán tổn thất phân loại/hồi quy chuỗi. Chỉ số phải nằm trong `[0, ..., config.num_labels - 1]`. Nếu `config.num_labels == 1`, tổn thất hồi quy sẽ được tính toán (tổn thất Mean-Square). Nếu `config.num_labels > 1`, tổn thất phân loại sẽ được tính toán (Cross-Entropy).
use_cache (`bool`, *tùy chọn*) : Nếu được đặt thành `True`, các trạng thái khóa và giá trị `past_key_values` sẽ được trả về và có thể được sử dụng để tăng tốc quá trình giải mã (xem `past_key_values`).
output_attentions (`bool`, *tùy chọn*) : Có trả về các tensor chú ý của tất cả các lớp chú ý hay không. Xem `attentions` trong phần tensor trả về để biết thêm chi tiết.
output_hidden_states (`bool`, *tuỳ chọn*) : Có trả về trạng thái ẩn của tất cả các lớp hay không. Xem `hidden_states` trong phần tensor trả về để biết thêm chi tiết.
return_dict (`bool`, *tùy chọn*) : Có trả về [ModelOutput](/docs/transformers/main/vi/main_classes/output#transformers.utils.ModelOutput) thay vì một tuple thông thường hay không.
**Trả về:** `SequenceClassifierOutputWithPast` hoặc `tuple(torch.Tensor)`
Một `SequenceClassifierOutputWithPast` hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([ImageGPTConfig](/docs/transformers/main/vi/model_doc/imagegpt#transformers.ImageGPTConfig)) và đầu vào.
Phương thức forward của [ImageGPTForImageClassification](/docs/transformers/main/vi/model_doc/imagegpt#transformers.ImageGPTForImageClassification) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **loss** (`torch.Tensor` có shape `(1,)`, *optional*, được trả về khi `labels` được cung cấp) -- Loss phân loại (hoặc hồi quy nếu config.num_labels==1).
- **logits** (`torch.Tensor` có hình dạng `(batch_size, config.num_labels)`) -- Điểm phân loại (hoặc hồi quy nếu config.num_labels==1) (trước SoftMax).
- **past_key_values** (`Cache`, *tùy chọn*, được trả về khi `use_cache=True` được truyền vào hoặc khi `config.use_cache=True`) -- Đây là một instance của [Cache](/docs/transformers/main/vi/internal/generation_utils#transformers.Cache). Để biết thêm chi tiết, hãy xem [hướng dẫn về kv cache](https://huggingface.co/docs/transformers/en/kv_cache) của chúng tôi.
Chứa các hidden-states đã được tính trước (key và values trong các khối self-attention) có thể được sử dụng (xem đầu vào `past_key_values`) để tăng tốc độ giải mã tuần tự.
- **hidden_states** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple của `torch.Tensor` (một cho đầu ra của các embedding, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
```python
>>> from transformers import AutoImageProcessor, ImageGPTForImageClassification
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("openai/imagegpt-small")
>>> model = ImageGPTForImageClassification.from_pretrained("openai/imagegpt-small")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> logits = outputs.logits
```