# ViLT
## Tổng quan
Mô hình ViLT được đề xuất trong [ViLT: Vision-and-Language Transformer Without Convolution or Region Supervision](https://huggingface.co/papers/2102.03334) bởi Wonjae Kim, Bokyung Son, Ildoo Kim. ViLT tích hợp các vector nhúng văn bản vào Vision Transformer (ViT), cho phép nó có thiết kế tối giản cho Tiền huấn luyện Thị giác và Ngôn ngữ (VLP).
Tóm tắt từ bài báo như sau:
*Pre-training kết hợp thị giác và ngôn ngữ (VLP) đã cải thiện hiệu suất trên nhiều tác vụ downstream kết hợp thị giác và ngôn ngữ. Các phương pháp hiện tại cho VLP phụ thuộc nhiều vào quy trình trích xuất đặc trưng hình ảnh, phần lớn trong số đó liên quan đến giám sát vùng (ví dụ: phát hiện đối tượng) và kiến trúc tích chập (ví dụ: ResNet). Mặc dù bị bỏ qua trong tài liệu, chúng tôi nhận thấy điều này gây ra vấn đề về cả (1) hiệu suất/tốc độ, khi chỉ riêng việc trích xuất đặc trưng đầu vào đã đòi hỏi nhiều tính toán hơn nhiều so với các bước tương tác đa phương thức; và (2) sức biểu diễn, vì nó bị giới hạn trên bởi sức biểu diễn của bộ nhúng thị giác và từ vựng thị giác được định nghĩa trước của nó. Trong bài báo này, chúng tôi trình bày một mô hình VLP tối giản, Vision-and-Language Transformer (ViLT), mang tính đơn khối theo nghĩa rằng việc xử lý đầu vào thị giác được đơn giản hóa đáng kể thành cùng một cách thức không dùng tích chập mà chúng tôi dùng để xử lý đầu vào văn bản. Chúng tôi cho thấy ViLT nhanh hơn các mô hình VLP trước đó tới hàng chục lần, nhưng vẫn có hiệu suất tác vụ downstream cạnh tranh hoặc tốt hơn.*
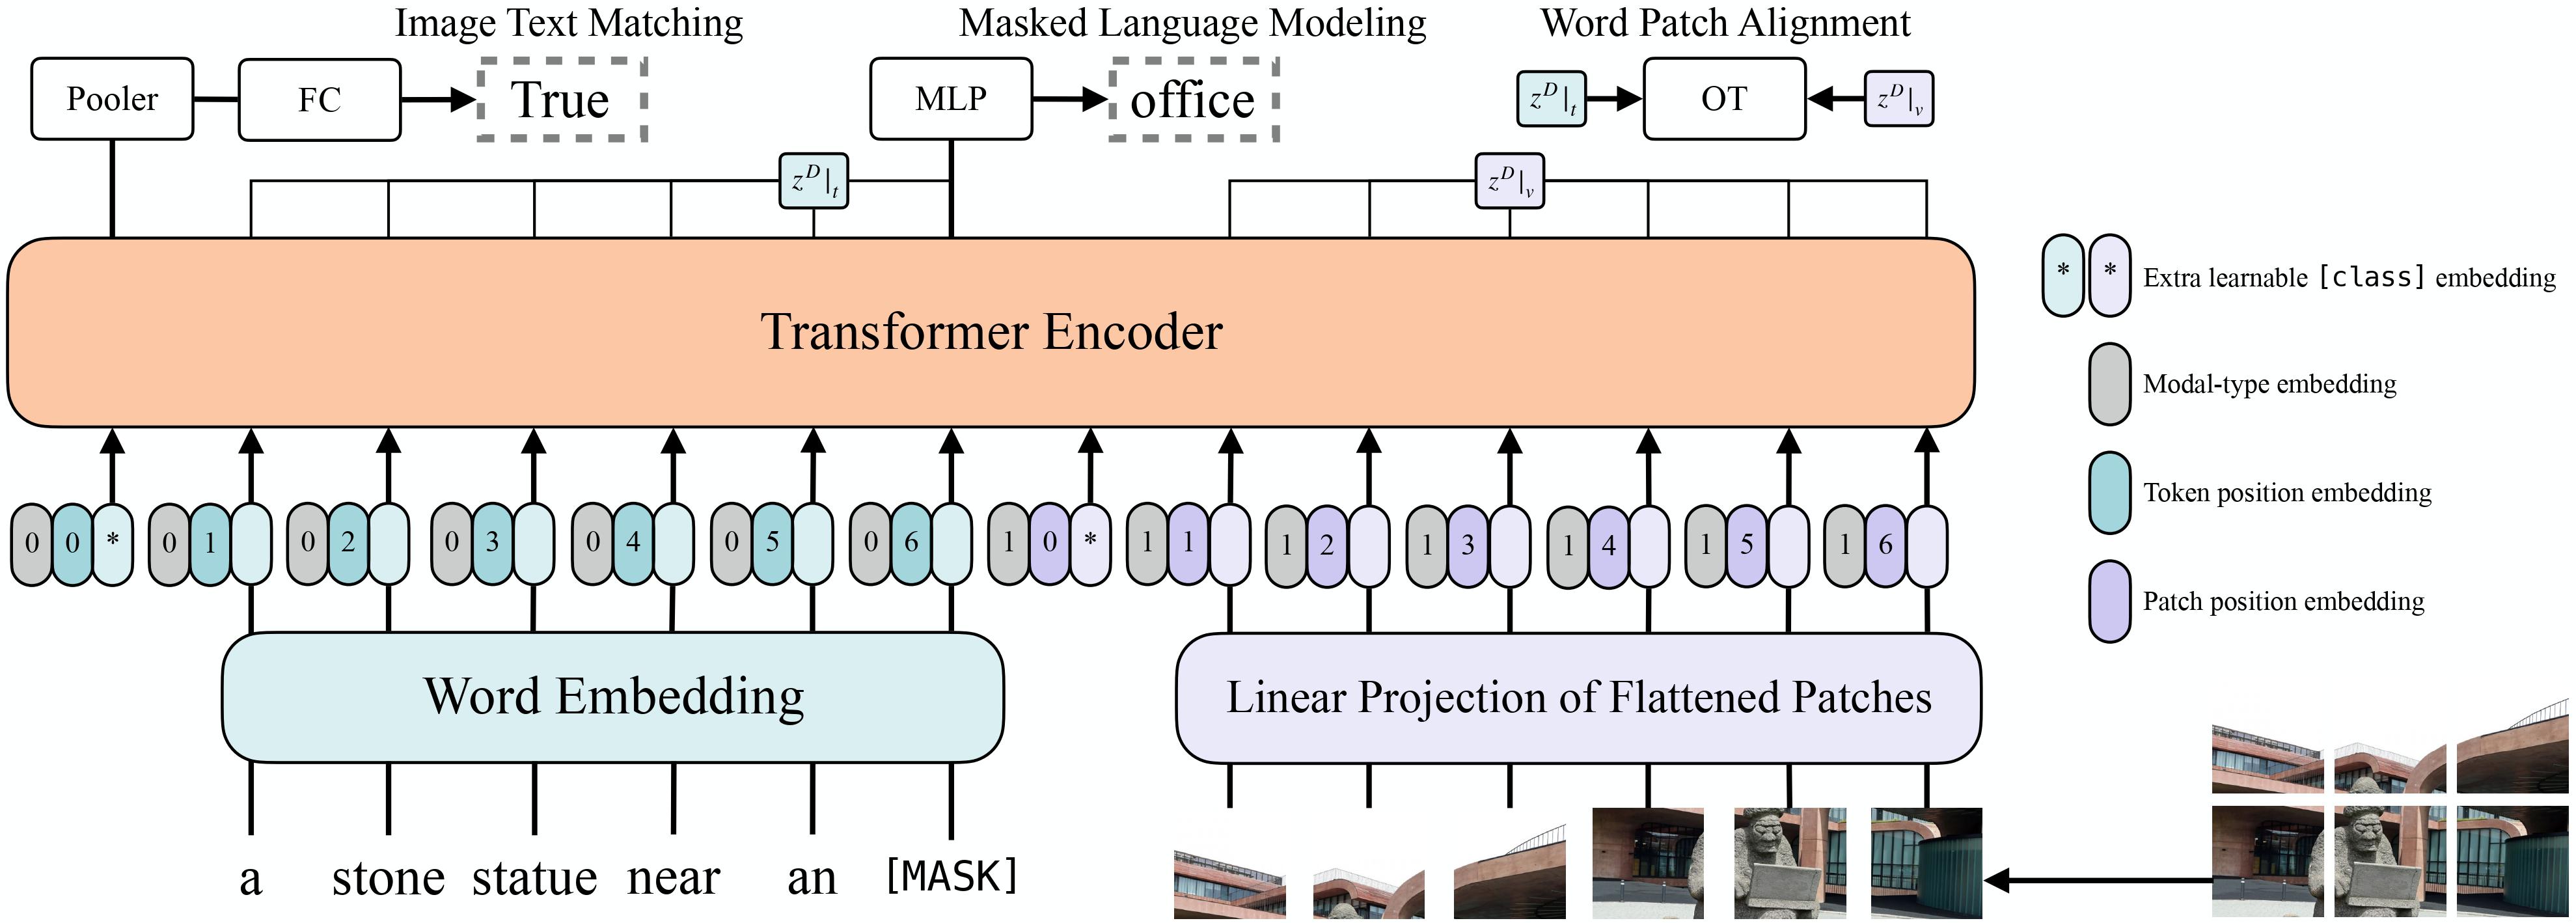 Kiến trúc ViLT. Được trích từ bài báo gốc.
Mô hình này được đóng góp bởi [nielsr](https://huggingface.co/nielsr). Mã gốc có thể được tìm thấy [tại đây](https://github.com/dandelin/ViLT).
## Mẹo sử dụng
- Cách nhanh nhất để bắt đầu với ViLT là xem các [notebook ví dụ](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/ViLT) (trình bày cả suy luận và tinh chỉnh trên dữ liệu tùy chỉnh).
- ViLT là một mô hình nhận cả `pixel_values` và `input_ids` làm đầu vào. Bạn có thể sử dụng [ViltProcessor](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltProcessor) để chuẩn bị dữ liệu cho mô hình. Bộ xử lý này đóng gói một bộ xử lý ảnh (cho phương thức ảnh) và một bộ phân từ (cho phương thức ngôn ngữ) thành một.
- ViILT được huấn luyện với các hình ảnh có kích thước khác nhau: các tác giả điều chỉnh cạnh ngắn của hình ảnh đầu vào thành 384 và giới hạn cạnh dài dưới 640 trong khi giữ nguyên tỷ lệ khung hình. Để cho phép nhóm hóa (batching) các hình ảnh, các tác giả sử dụng `pixel_mask` để chỉ ra giá trị pixel nào là thực và pixel nào là đệm (padding). [ViltProcessor](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltProcessor) tự động tạo điều này cho bạn.
- Thiết kế của ViLT rất giống với Vision Transformer (ViT) tiêu chuẩn. Điểm khác biệt duy nhất là mô hình bao gồm các lớp nhúng bổ sung cho phương thức ngôn ngữ.
## ViltConfig[[transformers.ViltConfig]]
#### transformers.ViltConfig[[transformers.ViltConfig]]
```python
transformers.ViltConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 30522, type_vocab_size: int = 2, modality_type_vocab_size: int = 2, max_position_embeddings: int = 40, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, image_size: int | list[int] | tuple[int, int] = 384, patch_size: int | list[int] | tuple[int, int] = 32, num_channels: int = 3, qkv_bias: bool = True, max_image_length: int = -1, tie_word_embeddings: bool = True, num_images: int = -1, pad_token_id: int | None = None)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/configuration_vilt.py#L24)
**Tham số:**
vocab_size (`int`, *tùy chọn*, mặc định là `30522`) : Kích thước từ vựng của mô hình. Xác định số lượng token khác nhau có thể được biểu diễn bởi `input_ids`.
type_vocab_size (`int`, *tùy chọn*, mặc định là `2`) : Kích thước từ vựng của `token_type_ids`.
modality_type_vocab_size (`int`, *tuỳ chọn*, mặc định là 2) : Kích thước từ vựng của các phương thức (modalities) được truyền khi gọi [ViltModel](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltModel). Giá trị này được sử dụng sau khi nối (concatenate) các embedding của phương thức văn bản và hình ảnh.
max_position_embeddings (`int`, *tuỳ chọn*, mặc định là `40`) : Độ dài chuỗi tối đa mà mô hình này có thể được sử dụng.
hidden_size (`int`, *optional*, mặc định là `768`) : Kích thước của các biểu diễn ẩn.
num_hidden_layers (`int`, *tuỳ chọn*, mặc định là `12`) : Số lượng lớp ẩn trong bộ giải mã Transformer.
num_attention_heads (`int`, *tùy chọn*, mặc định là `12`) : Số lượng đầu chú ý cho mỗi lớp chú ý trong bộ giải mã Transformer.
intermediate_size (`int`, *tuỳ chọn*, mặc định là `3072`) : Kích thước của các biểu diễn MLP.
hidden_act (`str`, *tùy chọn*, mặc định là `gelu`) : Hàm kích hoạt phi tuyến (hàm hoặc chuỗi) trong bộ giải mã. Ví dụ, `"gelu"`, `"relu"`, `"silu"`, v.v.
hidden_dropout_prob (`Union[float, int]`, *tùy chọn*, mặc định là `0.0`) : Xác suất dropout cho tất cả các lớp fully connected trong embeddings, encoder và pooler.
attention_probs_dropout_prob (`Union[float, int]`, *tùy chọn*, mặc định là `0.0`) : Tỷ lệ dropout cho các xác suất chú ý.
initializer_range (`float`, *optional*, mặc định là `0.02`) : Độ lệch chuẩn của truncated_normal_initializer để khởi tạo tất cả các ma trận trọng số.
layer_norm_eps (`float`, *tuỳ chọn*, mặc định là `1e-12`) : Epsilon được sử dụng bởi các lớp chuẩn hóa lớp (layer normalization).
image_size (`Union[int, list[int], tuple[int, int]]`, *tùy chọn*, mặc định là `384`) : Kích thước (độ phân giải) của mỗi hình ảnh.
patch_size (`Union[int, list[int], tuple[int, int]]`, *tùy chọn*, mặc định là `32`) : Kích thước (độ phân giải) của mỗi patch.
num_channels (`int`, *tuỳ chọn*, mặc định là `3`) : Số lượng kênh đầu vào.
qkv_bias (`bool`, *tùy chọn*, mặc định là `True`) : Có thêm bias vào queries, keys và values hay không.
max_image_length (`int`, *optional*, mặc định là -1) : Số lượng tối đa các patch được lấy làm đầu vào cho bộ mã hóa Transformer. Nếu được đặt thành một số nguyên dương, bộ mã hóa sẽ lấy mẫu tối đa `max_image_length` patch. Nếu được đặt thành -1, tham số này sẽ không được tính đến.
tie_word_embeddings (`bool`, *tùy chọn*, mặc định là `True`) : Có nên gắn kết các nhúng trọng số theo ánh xạ `tied_weights_keys` của mô hình hay không.
num_images (`int`, *tuỳ chọn*, mặc định là -1) : Số lượng hình ảnh được sử dụng cho suy luận thị giác bằng ngôn ngữ tự nhiên. Nếu được đặt thành một số nguyên dương, giá trị này sẽ được [ViltForImagesAndTextClassification](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltForImagesAndTextClassification) sử dụng để định nghĩa đầu phân loại.
pad_token_id (`int`, *tùy chọn*) : Id của token được sử dụng để đệm (padding) trong từ vựng.
Đây là lớp cấu hình để lưu trữ cấu hình của một ViltModel. Nó được sử dụng để khởi tạo một mô hình Vilt theo các đối số được chỉ định, xác định kiến trúc của mô hình. Khởi tạo một cấu hình với các giá trị mặc định sẽ tạo ra một cấu hình tương tự như cấu hình của [dandelin/vilt-b32-mlm](https://huggingface.co/dandelin/vilt-b32-mlm)
Các đối tượng cấu hình kế thừa từ [PreTrainedConfig](/docs/transformers/main/vi/main_classes/configuration#transformers.PreTrainedConfig) và có thể được sử dụng để kiểm soát đầu ra của mô hình. Đọc tài liệu từ [PreTrainedConfig](/docs/transformers/main/vi/main_classes/configuration#transformers.PreTrainedConfig) để biết thêm thông tin.
Ví dụ:
```python
>>> from transformers import ViLTModel, ViLTConfig
>>> # Initializing a ViLT dandelin/vilt-b32-mlm style configuration
>>> configuration = ViLTConfig()
>>> # Initializing a model from the dandelin/vilt-b32-mlm style configuration
>>> model = ViLTModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ViltImageProcessor[[transformers.ViltImageProcessor]]
#### transformers.ViltImageProcessor[[transformers.ViltImageProcessor]]
```python
transformers.ViltImageProcessor(**kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/image_processing_vilt.py#L52)
**Tham số:**
do_convert_rgb (`bool`, *kwargs*, *optional*) : Có chuyển đổi hình ảnh sang RGB hay không.
do_resize (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Xác định có thay đổi kích thước ảnh hay không.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, mặc định là `{'shortest_edge' : 384}`): Mô tả kích thước đầu vào tối đa cho mô hình.
default_to_square (`bool`, *kwargs*, *optional*, mặc định là `False`) : Có nên mặc định sử dụng ảnh vuông khi thay đổi kích thước hay không, nếu size là một số nguyên.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước của ảnh đầu ra sau khi áp dụng `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, mặc định là `3`) : Bộ lọc lấy mẫu lại (resampling filter) được sử dụng khi thay đổi kích thước ảnh. Giá trị này có thể là một trong các hằng số liệt kê (enum) của `PILImageResampling`. Chỉ có hiệu lực khi `do_resize` được đặt thành `True`.
do_rescale (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Xác định có nên điều chỉnh lại tỷ lệ ảnh hay không.
rescale_factor (`float`, *kwargs*, *optional*, mặc định là `0.00392156862745098`) : Hệ số để điều chỉnh lại kích thước ảnh nếu `do_rescale` được đặt thành `True`.
do_normalize (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Có chuẩn hóa hình ảnh hay không.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, mặc định là `[0.5, 0.5, 0.5]`) : Giá trị trung bình của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, mặc định là `[0.5, 0.5, 0.5]`) : Độ lệch chuẩn của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
do_pad (`bool`, *kwargs*, *optional*, mặc định là `True`) : Xác định có chèn padding cho ảnh hay không. Padding được thực hiện đến kích thước lớn nhất trong batch hoặc đến kích thước vuông cố định cho từng ảnh. Chiến lược padding cụ thể phụ thuộc vào model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước ở dạng `{"height": int, "width" int}` để đệm (pad) các ảnh. Phải lớn hơn kích thước của bất kỳ ảnh nào được cung cấp cho tiền xử lý. Nếu `pad_size` không được cung cấp, các ảnh sẽ được đệm đến chiều cao và chiều rộng lớn nhất trong batch. Chỉ được áp dụng khi `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Có nên cắt ảnh theo kiểu căn giữa hay không.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *tuỳ chọn*) : Chỉ hỗ trợ `ChannelDimension.FIRST`. Được thêm vào để tương thích với các bộ xử lý chậm.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Định dạng chiều kênh cho ảnh đầu vào. Nếu không được đặt, định dạng chiều kênh sẽ được suy ra từ ảnh đầu vào. Có thể là một trong các giá trị sau: - `"channels_first"` hoặc `ChannelDimension.FIRST`: ảnh ở định dạng (num_channels, height, width). - `"channels_last"` hoặc `ChannelDimension.LAST`: ảnh ở định dạng (height, width, num_channels). - `"none"` hoặc `ChannelDimension.NONE`: ảnh ở định dạng (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Thiết bị để xử lý các video. Nếu không được đặt, thiết bị sẽ được suy ra từ các video đầu vào.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Trả về các tensor đã xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor.
disable_grouping (`bool`, *kwargs*, *optional*) : Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *optional*) : Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý. Trả về các tensor được xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor.
disable_grouping (`bool`, *kwargs*, *optional*) : Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *optional*) : Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý. Trả về các tensor được xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor.
disable_grouping (`bool`, *kwargs*, *optional*) : Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *optional*) : Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý. Trả về các tensor được xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor.
disable_grouping (`bool`, *kwargs*, *optional*) : Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *tuỳ chọn*) : Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý.
Trả về các tensor được xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor. --
Tạo bộ xử lý ảnh ViltImageProcessor.
disable_grouping (`bool`, *kwargs*, *optional*): Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157 image_seq_length (`int`, *kwargs*, *optional*): Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý.
#### preprocess[[transformers.ViltImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Tham số:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ảnh cần tiền xử lý. Kỳ vọng một ảnh đơn hoặc một lô ảnh có giá trị pixel từ 0 đến 255. Nếu truyền vào các ảnh có giá trị pixel từ 0 đến 1, hãy đặt `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *tùy chọn*) : Cờ dành cho nhà phát triển cho các đầu vào dạng ảnh bổ sung cũng sẽ được tiền xử lý. Chỉ sử dụng cờ này nếu việc truyền các đầu vào dưới dạng kwarg không hoạt động. Ví dụ, `preprocess(images, masks=masks)` là tùy chọn được ưu tiên nhưng có thể gây ra các vấn đề về thứ tự ưu tiên của đối số đối với một số mô hình. Trong những trường hợp đó, có thể sử dụng `preprocess(images, image_like_inputs={"masks": masks})` thay thế.
do_convert_rgb (`bool`, *kwargs*, *optional*) : Có chuyển đổi hình ảnh sang RGB hay không.
do_resize (`bool`, *kwargs*, *optional*) : Xác định có nên thay đổi kích thước ảnh hay không.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*): Mô tả các kích thước đầu vào tối đa của mô hình.
default_to_square (`bool`, *kwargs*, *tuỳ chọn*) : Có mặc định dùng ảnh vuông khi thay đổi kích thước hay không, nếu size là một số nguyên.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước của ảnh đầu ra sau khi áp dụng `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Bộ lọc resampling để sử dụng khi thay đổi kích thước ảnh. Giá trị này có thể là một trong các enum `PILImageResampling`. Chỉ có hiệu lực khi `do_resize` được đặt thành `True`.
do_rescale (`bool`, *kwargs*, *tuỳ chọn*) : Xác định có nên điều chỉnh lại tỷ lệ hình ảnh hay không.
rescale_factor (`float`, *kwargs*, *optional*) : Hệ số để thay đổi tỷ lệ ảnh nếu `do_rescale` được đặt thành `True`.
do_normalize (`bool`, *kwargs*, *tuỳ chọn*) : Xác định có chuẩn hóa hình ảnh hay không.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Giá trị trung bình của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Độ lệch chuẩn của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
do_pad (`bool`, *kwargs*, *optional*) : Xác định có chèn padding cho ảnh hay không. Padding được thực hiện đến kích thước lớn nhất trong batch hoặc đến một kích thước vuông cố định cho mỗi ảnh. Chiến lược padding cụ thể phụ thuộc vào model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước ở dạng `{"height": int, "width" int}` để đệm (pad) các ảnh. Phải lớn hơn kích thước của bất kỳ ảnh nào được cung cấp cho tiền xử lý. Nếu `pad_size` không được cung cấp, các ảnh sẽ được đệm đến chiều cao và chiều rộng lớn nhất trong batch. Chỉ được áp dụng khi `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Có nên cắt ảnh theo kiểu căn giữa hay không.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *tuỳ chọn*) : Chỉ hỗ trợ `ChannelDimension.FIRST`. Được thêm vào để tương thích với các bộ xử lý chậm.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Định dạng chiều kênh cho ảnh đầu vào. Nếu không được đặt, định dạng chiều kênh sẽ được suy ra từ ảnh đầu vào. Có thể là một trong các giá trị sau: - `"channels_first"` hoặc `ChannelDimension.FIRST`: ảnh ở định dạng (num_channels, height, width). - `"channels_last"` hoặc `ChannelDimension.LAST`: ảnh ở định dạng (height, width, num_channels). - `"none"` hoặc `ChannelDimension.NONE`: ảnh ở định dạng (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Thiết bị để xử lý các video. Nếu không được đặt, thiết bị sẽ được suy ra từ các video đầu vào.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Trả về các tensor đã xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor.
disable_grouping (`bool`, *kwargs*, *optional*) : Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *tuỳ chọn*) : Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý.
**Trả về:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Từ điển chứa các danh sách/mảng/tensor được trả về bởi phương thức __call__ ('pixel_values', v.v.).
- **tensor_type** (`Union[None, str, TensorType]`, *tùy chọn*) -- Bạn có thể cung cấp tensor_type tại đây để chuyển đổi các danh sách số nguyên trong Tensor PyTorch/Numpy khi khởi tạo.
Tiền xử lý một hình ảnh hoặc một lô hình ảnh.
## ViltImageProcessorPil[[transformers.ViltImageProcessorPil]]
#### transformers.ViltImageProcessorPil[[transformers.ViltImageProcessorPil]]
```python
transformers.ViltImageProcessorPil(**kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/image_processing_pil_vilt.py#L113)
**Tham số:**
do_convert_rgb (`bool`, *kwargs*, *optional*) : Có chuyển đổi hình ảnh sang RGB hay không.
do_resize (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Xác định có thay đổi kích thước ảnh hay không.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, mặc định là `{'shortest_edge' : 384}`): Mô tả kích thước đầu vào tối đa cho mô hình.
default_to_square (`bool`, *kwargs*, *optional*, mặc định là `False`) : Có nên mặc định sử dụng ảnh vuông khi thay đổi kích thước hay không, nếu size là một số nguyên.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước của ảnh đầu ra sau khi áp dụng `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, mặc định là `3`) : Bộ lọc lấy mẫu lại (resampling filter) được sử dụng khi thay đổi kích thước ảnh. Giá trị này có thể là một trong các hằng số liệt kê (enum) của `PILImageResampling`. Chỉ có hiệu lực khi `do_resize` được đặt thành `True`.
do_rescale (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Xác định có nên điều chỉnh lại tỷ lệ ảnh hay không.
rescale_factor (`float`, *kwargs*, *optional*, mặc định là `0.00392156862745098`) : Hệ số để điều chỉnh lại kích thước ảnh nếu `do_rescale` được đặt thành `True`.
do_normalize (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Có chuẩn hóa hình ảnh hay không.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, mặc định là `[0.5, 0.5, 0.5]`) : Giá trị trung bình của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, mặc định là `[0.5, 0.5, 0.5]`) : Độ lệch chuẩn của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
do_pad (`bool`, *kwargs*, *optional*, mặc định là `True`) : Xác định có chèn padding cho ảnh hay không. Padding được thực hiện đến kích thước lớn nhất trong batch hoặc đến kích thước vuông cố định cho từng ảnh. Chiến lược padding cụ thể phụ thuộc vào model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước ở dạng `{"height": int, "width" int}` để đệm (pad) các ảnh. Phải lớn hơn kích thước của bất kỳ ảnh nào được cung cấp cho tiền xử lý. Nếu `pad_size` không được cung cấp, các ảnh sẽ được đệm đến chiều cao và chiều rộng lớn nhất trong batch. Chỉ được áp dụng khi `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Có nên cắt ảnh theo kiểu căn giữa hay không.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *tuỳ chọn*) : Chỉ hỗ trợ `ChannelDimension.FIRST`. Được thêm vào để tương thích với các bộ xử lý chậm.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Định dạng chiều kênh cho ảnh đầu vào. Nếu không được đặt, định dạng chiều kênh sẽ được suy ra từ ảnh đầu vào. Có thể là một trong các giá trị sau: - `"channels_first"` hoặc `ChannelDimension.FIRST`: ảnh ở định dạng (num_channels, height, width). - `"channels_last"` hoặc `ChannelDimension.LAST`: ảnh ở định dạng (height, width, num_channels). - `"none"` hoặc `ChannelDimension.NONE`: ảnh ở định dạng (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Thiết bị để xử lý các video. Nếu không được đặt, thiết bị sẽ được suy ra từ các video đầu vào.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Trả về các tensor đã xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor.
disable_grouping (`bool`, *kwargs*, *optional*) : Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *tuỳ chọn*) : Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý.
Trả về các tensor được xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor. --
Tạo bộ xử lý ảnh ViltImageProcessor.
disable_grouping (`bool`, *kwargs*, *optional*): Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157 image_seq_length (`int`, *kwargs*, *optional*): Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý.
#### preprocess[[transformers.ViltImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Tham số:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ảnh cần tiền xử lý. Kỳ vọng một ảnh đơn hoặc một lô ảnh có giá trị pixel từ 0 đến 255. Nếu truyền vào các ảnh có giá trị pixel từ 0 đến 1, hãy đặt `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *tùy chọn*) : Cờ dành cho nhà phát triển cho các đầu vào dạng ảnh bổ sung cũng sẽ được tiền xử lý. Chỉ sử dụng cờ này nếu việc truyền các đầu vào dưới dạng kwarg không hoạt động. Ví dụ, `preprocess(images, masks=masks)` là tùy chọn được ưu tiên nhưng có thể gây ra các vấn đề về thứ tự ưu tiên của đối số đối với một số mô hình. Trong những trường hợp đó, có thể sử dụng `preprocess(images, image_like_inputs={"masks": masks})` thay thế.
do_convert_rgb (`bool`, *kwargs*, *optional*) : Có chuyển đổi hình ảnh sang RGB hay không.
do_resize (`bool`, *kwargs*, *optional*) : Xác định có nên thay đổi kích thước ảnh hay không.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*): Mô tả các kích thước đầu vào tối đa của mô hình.
default_to_square (`bool`, *kwargs*, *tuỳ chọn*) : Có mặc định dùng ảnh vuông khi thay đổi kích thước hay không, nếu size là một số nguyên.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước của ảnh đầu ra sau khi áp dụng `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Bộ lọc resampling để sử dụng khi thay đổi kích thước ảnh. Giá trị này có thể là một trong các enum `PILImageResampling`. Chỉ có hiệu lực khi `do_resize` được đặt thành `True`.
do_rescale (`bool`, *kwargs*, *tuỳ chọn*) : Xác định có nên điều chỉnh lại tỷ lệ hình ảnh hay không.
rescale_factor (`float`, *kwargs*, *optional*) : Hệ số để thay đổi tỷ lệ ảnh nếu `do_rescale` được đặt thành `True`.
do_normalize (`bool`, *kwargs*, *tuỳ chọn*) : Xác định có chuẩn hóa hình ảnh hay không.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Giá trị trung bình của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Độ lệch chuẩn của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
do_pad (`bool`, *kwargs*, *optional*) : Xác định có chèn padding cho ảnh hay không. Padding được thực hiện đến kích thước lớn nhất trong batch hoặc đến một kích thước vuông cố định cho mỗi ảnh. Chiến lược padding cụ thể phụ thuộc vào model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước ở dạng `{"height": int, "width" int}` để đệm (pad) các ảnh. Phải lớn hơn kích thước của bất kỳ ảnh nào được cung cấp cho tiền xử lý. Nếu `pad_size` không được cung cấp, các ảnh sẽ được đệm đến chiều cao và chiều rộng lớn nhất trong batch. Chỉ được áp dụng khi `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Có nên cắt ảnh theo kiểu căn giữa hay không.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *tuỳ chọn*) : Chỉ hỗ trợ `ChannelDimension.FIRST`. Được thêm vào để tương thích với các bộ xử lý chậm.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Định dạng chiều kênh cho ảnh đầu vào. Nếu không được đặt, định dạng chiều kênh sẽ được suy ra từ ảnh đầu vào. Có thể là một trong các giá trị sau: - `"channels_first"` hoặc `ChannelDimension.FIRST`: ảnh ở định dạng (num_channels, height, width). - `"channels_last"` hoặc `ChannelDimension.LAST`: ảnh ở định dạng (height, width, num_channels). - `"none"` hoặc `ChannelDimension.NONE`: ảnh ở định dạng (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Thiết bị để xử lý các video. Nếu không được đặt, thiết bị sẽ được suy ra từ các video đầu vào.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Trả về các tensor đã xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor.
disable_grouping (`bool`, *kwargs*, *optional*) : Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *tuỳ chọn*) : Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý.
**Trả về:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Từ điển chứa các danh sách/mảng/tensor được trả về bởi phương thức __call__ ('pixel_values', v.v.).
- **tensor_type** (`Union[None, str, TensorType]`, *tùy chọn*) -- Bạn có thể cung cấp tensor_type tại đây để chuyển đổi các danh sách số nguyên trong Tensor PyTorch/Numpy khi khởi tạo.
Tiền xử lý một hình ảnh hoặc một lô hình ảnh.
## ViltProcessor[[transformers.ViltProcessor]]
#### transformers.ViltProcessor[[transformers.ViltProcessor]]
```python
transformers.ViltProcessor(image_processor = None, tokenizer = None, **kwargs)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/processing_vilt.py#L38)
**Tham số:**
image_processor (`ViltImageProcessor`) : Bộ xử lý ảnh là một đầu vào bắt buộc.
tokenizer (`BertTokenizer`) : Tokenizer là một đầu vào bắt buộc.
Tạo một ViltProcessor, đóng gói một bộ xử lý ảnh và một tokenizer thành một bộ xử lý duy nhất.
[ViltProcessor](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltProcessor) cung cấp đầy đủ các chức năng của [ViltImageProcessor](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltImageProcessor) và [BertTokenizer](/docs/transformers/main/vi/model_doc/lxmert#transformers.BertTokenizer). Xem [~ViltImageProcessor](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltImageProcessor) và [~BertTokenizer](/docs/transformers/main/vi/model_doc/lxmert#transformers.BertTokenizer) để biết thêm thông tin.
#### __call__[[transformers.ViltProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L659)
**Tham số:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *tùy chọn*) : Ảnh cần tiền xử lý. Kỳ vọng một ảnh đơn hoặc một lô ảnh với giá trị pixel dao động từ 0 đến 255. Nếu truyền vào các ảnh có giá trị pixel nằm trong khoảng từ 0 đến 1, hãy đặt `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *tùy chọn*) : Chuỗi hoặc lô các chuỗi cần được mã hóa. Mỗi chuỗi có thể là một chuỗi ký tự hoặc một danh sách các chuỗi ký tự (chuỗi đã được tách token trước). Nếu bạn truyền vào đầu vào đã tách token trước, hãy đặt `is_split_into_words=True` để tránh nhầm lẫn với các đầu vào dạng lô.
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`, *optional*) : Video cần tiền xử lý. Kỳ vọng một video đơn hoặc một batch video với giá trị pixel từ 0 đến 255. Nếu truyền vào video có giá trị pixel từ 0 đến 1, hãy đặt `do_rescale=False`.
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`, *optional*) : Âm thanh hoặc lô âm thanh cần được chuẩn bị. Mỗi âm thanh có thể là mảng NumPy hoặc tensor PyTorch. Trong trường hợp là mảng NumPy/tensor PyTorch, mỗi âm thanh nên có hình dạng (C, T), trong đó C là số kênh và T là độ dài mẫu của âm thanh.
return_tensors (`str` hoặc [TensorType](/docs/transformers/main/vi/internal/file_utils#transformers.TensorType), *optional*) : Nếu được đặt, sẽ trả về các tensor của một framework cụ thể. Các giá trị chấp nhận được là: - `'pt'`: Trả về các đối tượng `torch.Tensor` của PyTorch. - `'np'`: Trả về các đối tượng `np.ndarray` của NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/main/vi/main_classes/processors#transformers.ProcessingKwargs), *optional*) : Các tùy chọn xử lý bổ sung cho từng phương thức (text, images, videos, audio). Các tham số cụ thể của model được liệt kê ở trên; xem lớp TypedDict để biết danh sách đầy đủ các đối số được hỗ trợ.
## ViltModel[[transformers.ViltModel]]
#### transformers.ViltModel[[transformers.ViltModel]]
```python
transformers.ViltModel(config: ViltConfig, add_pooling_layer = True)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/modeling_vilt.py#L511)
**Tham số:**
config ([ViltConfig](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số mô hình.
add_pooling_layer (`bool`, *tùy chọn*, mặc định là `True`) : Có thêm một lớp pooling hay không
Mô hình Vilt cơ bản, xuất ra các hidden-state thô mà không có bất kỳ head cụ thể nào ở phía trên.
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.ViltModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, image_token_type_idx: int | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/modeling_vilt.py#L535)
**Tham số:**
input_ids (`torch.LongTensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của các token trong chuỗi đầu vào theo từ vựng. Mặc định, các token đệm (padding) sẽ bị bỏ qua. Có thể lấy chỉ số bằng cách sử dụng [AutoTokenizer](/docs/transformers/main/vi/model_doc/auto#transformers.AutoTokenizer). Xem [PreTrainedTokenizer.encode()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) và [PreTrainedTokenizer.__call__()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) để biết chi tiết. [ID đầu vào là gì?](../glossary#input-ids)
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Các chỉ số token phân đoạn để chỉ định phần đầu và phần thứ hai của các đầu vào. Các chỉ số được chọn trong `[0, 1]`: - 0 tương ứng với token *câu A*, - 1 tương ứng với token *câu B*. [Các ID loại token là gì?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` có shape `(batch_size, num_channels, image_size, image_size)`, *tùy chọn*) : Các tensor tương ứng với các ảnh đầu vào. Giá trị pixel có thể được lấy bằng cách sử dụng [ViltImageProcessor](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltImageProcessor). Xem [ViltImageProcessor.__call__()](/docs/transformers/main/vi/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) để biết chi tiết ([ViltProcessor](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltProcessor) sử dụng [ViltImageProcessor](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltImageProcessor) để xử lý ảnh).
pixel_mask (`torch.LongTensor` có hình dạng `(batch_size, height, width)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các giá trị pixel đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các pixel thực (tức là **không bị che**), - 0 cho các pixel đệm (tức là **bị che**). [Mặt nạ chú ý là gì?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `input_ids`, bạn có thể chọn cách truyền trực tiếp một biểu diễn nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi các chỉ số `input_ids` thành các vector liên quan so với ma trận tra cứu nhúng nội bộ của mô hình.
image_embeds (`torch.Tensor` có hình dạng `(batch_size, num_patches, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `pixel_values`, bạn có thể chọn truyền trực tiếp một biểu diễn đã nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi `pixel_values` thành các patch embeddings.
image_token_type_idx (`int`, *optional*) : - Các id loại token cho hình ảnh.
output_attentions (`bool`, *tùy chọn*) : Có trả về các tensor chú ý của tất cả các lớp chú ý hay không. Xem `attentions` trong phần tensor trả về để biết thêm chi tiết.
output_hidden_states (`bool`, *tuỳ chọn*) : Có trả về trạng thái ẩn của tất cả các lớp hay không. Xem `hidden_states` trong phần tensor trả về để biết thêm chi tiết.
return_dict (`bool`, *tùy chọn*) : Có trả về [ModelOutput](/docs/transformers/main/vi/main_classes/output#transformers.utils.ModelOutput) thay vì một tuple thông thường hay không.
**Trả về:** [BaseModelOutputWithPooling](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) hoặc `tuple(torch.Tensor)`
Một [BaseModelOutputWithPooling](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([ViltConfig](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltConfig)) và đầu vào.
Phương thức forward của [ViltModel](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltModel) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **last_hidden_state** (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`) -- Chuỗi các hidden-state tại đầu ra của lớp cuối cùng của mô hình.
- **pooler_output** (`torch.Tensor` có hình dạng `(batch_size, hidden_size)`) -- Trạng thái ẩn của lớp cuối cùng cho token đầu tiên của chuỗi (token phân loại) sau khi được xử lý thêm thông qua các lớp dùng cho tác vụ tiền huấn luyện bổ trợ. Ví dụ, đối với các mô hình thuộc họ BERT, giá trị này trả về token phân loại sau khi được xử lý qua một lớp tuyến tính và một hàm kích hoạt tanh. Trọng số của lớp tuyến tính được huấn luyện từ mục tiêu dự đoán câu tiếp theo (phân loại) trong quá trình tiền huấn luyện.
- **hidden_states** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple của `torch.Tensor` (một cho đầu ra của các embedding, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
```python
>>> from transformers import ViltProcessor, ViltModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> # prepare image and text
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "hello world"
>>> processor = ViltProcessor.from_pretrained("dandelin/vilt-b32-mlm")
>>> model = ViltModel.from_pretrained("dandelin/vilt-b32-mlm")
>>> inputs = processor(image, text, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
```
## ViltForMaskedLM[[transformers.ViltForMaskedLM]]
#### transformers.ViltForMaskedLM[[transformers.ViltForMaskedLM]]
```python
transformers.ViltForMaskedLM(config: ViltConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/modeling_vilt.py#L671)
**Tham số:**
config ([ViltConfig](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số mô hình.
Mô hình ViLT với một đầu mô hình hóa ngôn ngữ ở trên, như đã thực hiện trong quá trình tiền huấn luyện.
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.ViltForMaskedLM.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/modeling_vilt.py#L692)
**Tham số:**
input_ids (`torch.LongTensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của các token trong chuỗi đầu vào theo từ vựng. Mặc định, các token đệm (padding) sẽ bị bỏ qua. Có thể lấy chỉ số bằng cách sử dụng [AutoTokenizer](/docs/transformers/main/vi/model_doc/auto#transformers.AutoTokenizer). Xem [PreTrainedTokenizer.encode()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) và [PreTrainedTokenizer.__call__()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) để biết chi tiết. [ID đầu vào là gì?](../glossary#input-ids)
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Các chỉ số token phân đoạn để chỉ định phần đầu và phần thứ hai của các đầu vào. Các chỉ số được chọn trong `[0, 1]`: - 0 tương ứng với token *câu A*, - 1 tương ứng với token *câu B*. [Các ID loại token là gì?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` có shape `(batch_size, num_channels, image_size, image_size)`, *tùy chọn*) : Các tensor tương ứng với các ảnh đầu vào. Giá trị pixel có thể được lấy bằng cách sử dụng [ViltImageProcessor](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltImageProcessor). Xem [ViltImageProcessor.__call__()](/docs/transformers/main/vi/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) để biết chi tiết ([ViltProcessor](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltProcessor) sử dụng [ViltImageProcessor](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltImageProcessor) để xử lý ảnh).
pixel_mask (`torch.LongTensor` có hình dạng `(batch_size, height, width)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các giá trị pixel đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các pixel thực (tức là **không bị che**), - 0 cho các pixel đệm (tức là **bị che**). [Mặt nạ chú ý là gì?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `input_ids`, bạn có thể chọn cách truyền trực tiếp một biểu diễn nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi các chỉ số `input_ids` thành các vector liên quan so với ma trận tra cứu nhúng nội bộ của mô hình.
image_embeds (`torch.Tensor` có hình dạng `(batch_size, num_patches, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `pixel_values`, bạn có thể chọn truyền trực tiếp một biểu diễn đã nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi `pixel_values` thành các patch embeddings.
labels (`torch.LongTensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Nhãn để tính toán tổn thất mô hình hóa ngôn ngữ có che (masked language modeling loss). Chỉ số phải nằm trong `[-100, 0, ..., config.vocab_size]` (xem docstring của `input_ids`). Các token có chỉ số được đặt thành `-100` sẽ bị bỏ qua (che), tổn thất chỉ được tính cho các token có nhãn nằm trong `[0, ..., config.vocab_size]`.
output_attentions (`bool`, *tùy chọn*) : Có trả về các tensor chú ý của tất cả các lớp chú ý hay không. Xem `attentions` trong phần tensor trả về để biết thêm chi tiết.
output_hidden_states (`bool`, *tuỳ chọn*) : Có trả về trạng thái ẩn của tất cả các lớp hay không. Xem `hidden_states` trong phần tensor trả về để biết thêm chi tiết.
return_dict (`bool`, *tùy chọn*) : Có trả về [ModelOutput](/docs/transformers/main/vi/main_classes/output#transformers.utils.ModelOutput) thay vì một tuple thông thường hay không.
**Trả về:** [MaskedLMOutput](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) hoặc `tuple(torch.Tensor)`
Một [MaskedLMOutput](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([ViltConfig](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltConfig)) và đầu vào.
Phương thức forward của [ViltForMaskedLM](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltForMaskedLM) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **loss** (`torch.Tensor` có hình dạng `(1,)`, *tùy chọn*, được trả về khi `labels` được cung cấp) -- Tổn thất mô hình hóa ngôn ngữ có mặt nạ (MLM).
- **logits** (`torch.Tensor` có hình dạng `(batch_size, sequence_length, config.vocab_size)`) -- Điểm dự đoán của đầu mô hình hóa ngôn ngữ (điểm cho mỗi token từ vựng trước SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple của `torch.Tensor` (một cho đầu ra của các embedding, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
```python
>>> from transformers import ViltProcessor, ViltForMaskedLM
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> import re
>>> import torch
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "a bunch of [MASK] laying on a [MASK]."
>>> processor = ViltProcessor.from_pretrained("dandelin/vilt-b32-mlm")
>>> model = ViltForMaskedLM.from_pretrained("dandelin/vilt-b32-mlm")
>>> # prepare inputs
>>> encoding = processor(image, text, return_tensors="pt")
>>> # forward pass
>>> outputs = model(**encoding)
>>> tl = len(re.findall("\[MASK\]", text))
>>> inferred_token = [text]
>>> # gradually fill in the MASK tokens, one by one
>>> with torch.no_grad():
... for i in range(tl):
... encoded = processor.tokenizer(inferred_token)
... input_ids = torch.tensor(encoded.input_ids)
... encoded = encoded["input_ids"][0][1:-1]
... outputs = model(input_ids=input_ids, pixel_values=encoding.pixel_values)
... mlm_logits = outputs.logits[0] # shape (seq_len, vocab_size)
... # only take into account text features (minus CLS and SEP token)
... mlm_logits = mlm_logits[1 : input_ids.shape[1] - 1, :]
... mlm_values, mlm_ids = mlm_logits.softmax(dim=-1).max(dim=-1)
... # only take into account text
... mlm_values[torch.tensor(encoded) != 103] = 0
... select = mlm_values.argmax().item()
... encoded[select] = mlm_ids[select].item()
... inferred_token = [processor.decode(encoded)]
>>> selected_token = ""
>>> encoded = processor.tokenizer(inferred_token)
>>> output = processor.decode(encoded.input_ids[0], skip_special_tokens=True)
>>> print(output)
a bunch of cats laying on a couch.
```
## ViltForQuestionAnswering[[transformers.ViltForQuestionAnswering]]
#### transformers.ViltForQuestionAnswering[[transformers.ViltForQuestionAnswering]]
```python
transformers.ViltForQuestionAnswering(config: ViltConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/modeling_vilt.py#L840)
**Tham số:**
config ([ViltConfig](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số mô hình.
Model transformer Vilt với một đầu phân loại phía trên (một lớp tuyến tính phía trên trạng thái ẩn cuối cùng của token [CLS]) cho việc trả lời câu hỏi thị giác, ví dụ cho VQAv2.
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.ViltForQuestionAnswering.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/modeling_vilt.py#L858)
**Tham số:**
input_ids (`torch.LongTensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của các token trong chuỗi đầu vào theo từ vựng. Mặc định, các token đệm (padding) sẽ bị bỏ qua. Có thể lấy chỉ số bằng cách sử dụng [AutoTokenizer](/docs/transformers/main/vi/model_doc/auto#transformers.AutoTokenizer). Xem [PreTrainedTokenizer.encode()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) và [PreTrainedTokenizer.__call__()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) để biết chi tiết. [ID đầu vào là gì?](../glossary#input-ids)
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Các chỉ số token phân đoạn để chỉ định phần đầu và phần thứ hai của các đầu vào. Các chỉ số được chọn trong `[0, 1]`: - 0 tương ứng với token *câu A*, - 1 tương ứng với token *câu B*. [Các ID loại token là gì?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` có shape `(batch_size, num_channels, image_size, image_size)`, *tùy chọn*) : Các tensor tương ứng với các ảnh đầu vào. Giá trị pixel có thể được lấy bằng cách sử dụng [ViltImageProcessor](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltImageProcessor). Xem [ViltImageProcessor.__call__()](/docs/transformers/main/vi/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) để biết chi tiết ([ViltProcessor](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltProcessor) sử dụng [ViltImageProcessor](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltImageProcessor) để xử lý ảnh).
pixel_mask (`torch.LongTensor` có hình dạng `(batch_size, height, width)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các giá trị pixel đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các pixel thực (tức là **không bị che**), - 0 cho các pixel đệm (tức là **bị che**). [Mặt nạ chú ý là gì?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `input_ids`, bạn có thể chọn cách truyền trực tiếp một biểu diễn nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi các chỉ số `input_ids` thành các vector liên quan so với ma trận tra cứu nhúng nội bộ của mô hình.
image_embeds (`torch.Tensor` có hình dạng `(batch_size, num_patches, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `pixel_values`, bạn có thể chọn truyền trực tiếp một biểu diễn đã nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi `pixel_values` thành các patch embeddings.
labels (`torch.Tensor` có shape `(batch_size, num_labels)`, *tùy chọn*) : Nhãn để tính toán visual question answering loss. Tensor này phải là mã hóa one-hot của tất cả các câu trả lời áp dụng cho một ví dụ cụ thể trong batch, hoặc là mã hóa mềm chỉ ra các câu trả lời nào áp dụng, trong đó 1.0 là điểm số cao nhất.
output_attentions (`bool`, *tùy chọn*) : Có trả về các tensor chú ý của tất cả các lớp chú ý hay không. Xem `attentions` trong phần tensor trả về để biết thêm chi tiết.
output_hidden_states (`bool`, *tuỳ chọn*) : Có trả về trạng thái ẩn của tất cả các lớp hay không. Xem `hidden_states` trong phần tensor trả về để biết thêm chi tiết.
return_dict (`bool`, *tùy chọn*) : Có trả về [ModelOutput](/docs/transformers/main/vi/main_classes/output#transformers.utils.ModelOutput) thay vì một tuple thông thường hay không.
**Trả về:** [SequenceClassifierOutput](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) hoặc `tuple(torch.Tensor)`
Một [SequenceClassifierOutput](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([ViltConfig](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltConfig)) và đầu vào.
Phương thức forward của [ViltForQuestionAnswering](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltForQuestionAnswering) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **loss** (`torch.Tensor` có shape `(1,)`, *optional*, được trả về khi `labels` được cung cấp) -- Loss phân loại (hoặc hồi quy nếu config.num_labels==1).
- **logits** (`torch.Tensor` có hình dạng `(batch_size, config.num_labels)`) -- Điểm phân loại (hoặc hồi quy nếu config.num_labels==1) (trước SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple của `torch.Tensor` (một cho đầu ra của các embedding, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
```python
>>> from transformers import ViltProcessor, ViltForQuestionAnswering
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "How many cats are there?"
>>> processor = ViltProcessor.from_pretrained("dandelin/vilt-b32-finetuned-vqa")
>>> model = ViltForQuestionAnswering.from_pretrained("dandelin/vilt-b32-finetuned-vqa")
>>> # prepare inputs
>>> encoding = processor(image, text, return_tensors="pt")
>>> # forward pass
>>> outputs = model(**encoding)
>>> logits = outputs.logits
>>> idx = logits.argmax(-1).item()
>>> print("Predicted answer:", model.config.id2label[idx])
Predicted answer: 2
```
## ViltForImagesAndTextClassification[[transformers.ViltForImagesAndTextClassification]]
#### transformers.ViltForImagesAndTextClassification[[transformers.ViltForImagesAndTextClassification]]
```python
transformers.ViltForImagesAndTextClassification(config: ViltConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/modeling_vilt.py#L1052)
**Tham số:**
config ([ViltConfig](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số mô hình.
Model transformer Vilt với một đầu phân loại phía trên cho suy luận thị giác ngôn ngữ tự nhiên, ví dụ NLVR2.
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.ViltForImagesAndTextClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/modeling_vilt.py#L1071)
**Tham số:**
input_ids (`torch.LongTensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của các token trong chuỗi đầu vào theo từ vựng. Mặc định, các token đệm (padding) sẽ bị bỏ qua. Có thể lấy chỉ số bằng cách sử dụng [AutoTokenizer](/docs/transformers/main/vi/model_doc/auto#transformers.AutoTokenizer). Xem [PreTrainedTokenizer.encode()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) và [PreTrainedTokenizer.__call__()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) để biết chi tiết. [ID đầu vào là gì?](../glossary#input-ids)
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Các chỉ số token phân đoạn để chỉ định phần đầu và phần thứ hai của các đầu vào. Các chỉ số được chọn trong `[0, 1]`: - 0 tương ứng với token *câu A*, - 1 tương ứng với token *câu B*. [Các ID loại token là gì?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` có shape `(batch_size, num_channels, image_size, image_size)`, *tùy chọn*) : Các tensor tương ứng với các ảnh đầu vào. Giá trị pixel có thể được lấy bằng cách sử dụng [ViltImageProcessor](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltImageProcessor). Xem [ViltImageProcessor.__call__()](/docs/transformers/main/vi/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) để biết chi tiết ([ViltProcessor](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltProcessor) sử dụng [ViltImageProcessor](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltImageProcessor) để xử lý ảnh).
pixel_mask (`torch.LongTensor` có hình dạng `(batch_size, height, width)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các giá trị pixel đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các pixel thực (tức là **không bị che**), - 0 cho các pixel đệm (tức là **bị che**). [Mặt nạ chú ý là gì?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `input_ids`, bạn có thể chọn cách truyền trực tiếp một biểu diễn nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi các chỉ số `input_ids` thành các vector liên quan so với ma trận tra cứu nhúng nội bộ của mô hình.
image_embeds (`torch.Tensor` có hình dạng `(batch_size, num_patches, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `pixel_values`, bạn có thể chọn truyền trực tiếp một biểu diễn đã nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi `pixel_values` thành các patch embeddings.
labels (`torch.LongTensor` có hình dạng `(batch_size,)`, *tùy chọn*) : Nhãn phân loại nhị phân.
output_attentions (`bool`, *tùy chọn*) : Có trả về các tensor chú ý của tất cả các lớp chú ý hay không. Xem `attentions` trong phần tensor trả về để biết thêm chi tiết.
output_hidden_states (`bool`, *tuỳ chọn*) : Có trả về trạng thái ẩn của tất cả các lớp hay không. Xem `hidden_states` trong phần tensor trả về để biết thêm chi tiết.
return_dict (`bool`, *tùy chọn*) : Có trả về [ModelOutput](/docs/transformers/main/vi/main_classes/output#transformers.utils.ModelOutput) thay vì một tuple thông thường hay không.
**Trả về:** `ViltForImagesAndTextClassificationOutput` hoặc `tuple(torch.Tensor)`
Một `ViltForImagesAndTextClassificationOutput` hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([ViltConfig](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltConfig)) và đầu vào.
Phương thức forward của [ViltForImagesAndTextClassification](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltForImagesAndTextClassification) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **loss** (`torch.Tensor` có shape `(1,)`, *optional*, được trả về khi `labels` được cung cấp) -- Loss phân loại (hoặc hồi quy nếu config.num_labels==1).
- **logits** (`torch.Tensor` có hình dạng `(batch_size, config.num_labels)`) -- Điểm phân loại (hoặc hồi quy nếu config.num_labels==1) (trước SoftMax).
- **hidden_states** (`list[tuple(torch.Tensor)]`, *tùy chọn*, được trả về khi truyền `output_hidden_states=True` hoặc khi `config.output_hidden_states=True`) -- Danh sách các tuple của `torch.Tensor` (một tuple cho mỗi cặp ảnh-văn bản, mỗi tuple chứa đầu ra của embeddings + một phần cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`. Hidden-states của mô hình tại đầu ra của mỗi lớp cùng với đầu ra của embeddings ban đầu.
- **attentions** (`list[tuple[torch.Tensor]]`, *tùy chọn*, được trả về khi truyền `output_attentions=True` hoặc khi `config.output_attentions=True`) -- Bộ ba `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
```python
>>> from transformers import ViltProcessor, ViltForImagesAndTextClassification
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> url_1 = "https://lil.nlp.cornell.edu/nlvr/exs/ex0_0.jpg"
>>> with httpx.stream("GET", url_1) as response:
... image_1 = Image.open(BytesIO(response.read()))
>>> url_2 = "https://lil.nlp.cornell.edu/nlvr/exs/ex0_1.jpg"
>>> with httpx.stream("GET", url_2) as response:
... image_2 = Image.open(BytesIO(response.read()))
>>> text = "The left image contains twice the number of dogs as the right image."
>>> processor = ViltProcessor.from_pretrained("dandelin/vilt-b32-finetuned-nlvr2")
>>> model = ViltForImagesAndTextClassification.from_pretrained("dandelin/vilt-b32-finetuned-nlvr2")
>>> # prepare inputs
>>> encoding = processor([image_1, image_2], text, return_tensors="pt")
>>> # forward pass
>>> outputs = model(input_ids=encoding.input_ids, pixel_values=encoding.pixel_values.unsqueeze(0))
>>> logits = outputs.logits
>>> idx = logits.argmax(-1).item()
>>> print("Predicted answer:", model.config.id2label[idx])
Predicted answer: True
```
## ViltForImageAndTextRetrieval[[transformers.ViltForImageAndTextRetrieval]]
#### transformers.ViltForImageAndTextRetrieval[[transformers.ViltForImageAndTextRetrieval]]
```python
transformers.ViltForImageAndTextRetrieval(config: ViltConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/modeling_vilt.py#L953)
**Tham số:**
config ([ViltConfig](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số mô hình.
Model transformer Vilt với một đầu phân loại phía trên (một lớp tuyến tính phía trên trạng thái ẩn cuối cùng của token [CLS]) để truy xuất từ ảnh sang văn bản hoặc từ văn bản sang ảnh, ví dụ như MSCOCO và F30K.
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.ViltForImageAndTextRetrieval.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/modeling_vilt.py#L965)
**Tham số:**
input_ids (`torch.LongTensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của các token trong chuỗi đầu vào theo từ vựng. Mặc định, các token đệm (padding) sẽ bị bỏ qua. Có thể lấy chỉ số bằng cách sử dụng [AutoTokenizer](/docs/transformers/main/vi/model_doc/auto#transformers.AutoTokenizer). Xem [PreTrainedTokenizer.encode()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) và [PreTrainedTokenizer.__call__()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) để biết chi tiết. [ID đầu vào là gì?](../glossary#input-ids)
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Các chỉ số token phân đoạn để chỉ định phần đầu và phần thứ hai của các đầu vào. Các chỉ số được chọn trong `[0, 1]`: - 0 tương ứng với token *câu A*, - 1 tương ứng với token *câu B*. [Các ID loại token là gì?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` có shape `(batch_size, num_channels, image_size, image_size)`, *tùy chọn*) : Các tensor tương ứng với các ảnh đầu vào. Giá trị pixel có thể được lấy bằng cách sử dụng [ViltImageProcessor](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltImageProcessor). Xem [ViltImageProcessor.__call__()](/docs/transformers/main/vi/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) để biết chi tiết ([ViltProcessor](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltProcessor) sử dụng [ViltImageProcessor](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltImageProcessor) để xử lý ảnh).
pixel_mask (`torch.LongTensor` có hình dạng `(batch_size, height, width)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các giá trị pixel đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các pixel thực (tức là **không bị che**), - 0 cho các pixel đệm (tức là **bị che**). [Mặt nạ chú ý là gì?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `input_ids`, bạn có thể chọn cách truyền trực tiếp một biểu diễn nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi các chỉ số `input_ids` thành các vector liên quan so với ma trận tra cứu nhúng nội bộ của mô hình.
image_embeds (`torch.Tensor` có hình dạng `(batch_size, num_patches, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `pixel_values`, bạn có thể chọn truyền trực tiếp một biểu diễn đã nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi `pixel_values` thành các patch embeddings.
labels (`torch.LongTensor` có hình dạng `(batch_size,)`, *tùy chọn*) : Nhãn hiện chưa được hỗ trợ.
output_attentions (`bool`, *tùy chọn*) : Có trả về các tensor chú ý của tất cả các lớp chú ý hay không. Xem `attentions` trong phần tensor trả về để biết thêm chi tiết.
output_hidden_states (`bool`, *tuỳ chọn*) : Có trả về trạng thái ẩn của tất cả các lớp hay không. Xem `hidden_states` trong phần tensor trả về để biết thêm chi tiết.
return_dict (`bool`, *tùy chọn*) : Có trả về [ModelOutput](/docs/transformers/main/vi/main_classes/output#transformers.utils.ModelOutput) thay vì một tuple thông thường hay không.
**Trả về:** [SequenceClassifierOutput](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) hoặc `tuple(torch.Tensor)`
Một [SequenceClassifierOutput](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([ViltConfig](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltConfig)) và đầu vào.
Phương thức forward của [ViltForImageAndTextRetrieval](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltForImageAndTextRetrieval) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **loss** (`torch.Tensor` có shape `(1,)`, *optional*, được trả về khi `labels` được cung cấp) -- Loss phân loại (hoặc hồi quy nếu config.num_labels==1).
- **logits** (`torch.Tensor` có hình dạng `(batch_size, config.num_labels)`) -- Điểm phân loại (hoặc hồi quy nếu config.num_labels==1) (trước SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple của `torch.Tensor` (một cho đầu ra của các embedding, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
```python
>>> from transformers import ViltProcessor, ViltForImageAndTextRetrieval
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> texts = ["An image of two cats chilling on a couch", "A football player scoring a goal"]
>>> processor = ViltProcessor.from_pretrained("dandelin/vilt-b32-finetuned-coco")
>>> model = ViltForImageAndTextRetrieval.from_pretrained("dandelin/vilt-b32-finetuned-coco")
>>> # forward pass
>>> scores = dict()
>>> for text in texts:
... # prepare inputs
... encoding = processor(image, text, return_tensors="pt")
... outputs = model(**encoding)
... scores[text] = outputs.logits[0, :].item()
```
## ViltForTokenClassification[[transformers.ViltForTokenClassification]]
#### transformers.ViltForTokenClassification[[transformers.ViltForTokenClassification]]
```python
transformers.ViltForTokenClassification(config: ViltConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/modeling_vilt.py#L1194)
**Tham số:**
config ([ViltConfig](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số mô hình.
Transformer Vilt với đầu phân loại token phía trên (một lớp tuyến tính phía trên đầu ra của hidden-states), ví dụ cho các tác vụ Nhận thực thể có tên (NER).
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.ViltForTokenClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vilt/modeling_vilt.py#L1207)
**Tham số:**
input_ids (`torch.LongTensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Chỉ số của các token trong chuỗi đầu vào theo từ vựng. Mặc định, các token đệm (padding) sẽ bị bỏ qua. Có thể lấy chỉ số bằng cách sử dụng [AutoTokenizer](/docs/transformers/main/vi/model_doc/auto#transformers.AutoTokenizer). Xem [PreTrainedTokenizer.encode()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) và [PreTrainedTokenizer.__call__()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) để biết chi tiết. [ID đầu vào là gì?](../glossary#input-ids)
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` có shape `(batch_size, sequence_length)`, *tùy chọn*) : Các chỉ số token phân đoạn để chỉ định phần đầu và phần thứ hai của các đầu vào. Các chỉ số được chọn trong `[0, 1]`: - 0 tương ứng với token *câu A*, - 1 tương ứng với token *câu B*. [Các ID loại token là gì?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` có shape `(batch_size, num_channels, image_size, image_size)`, *tùy chọn*) : Các tensor tương ứng với các ảnh đầu vào. Giá trị pixel có thể được lấy bằng cách sử dụng [ViltImageProcessor](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltImageProcessor). Xem [ViltImageProcessor.__call__()](/docs/transformers/main/vi/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) để biết chi tiết ([ViltProcessor](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltProcessor) sử dụng [ViltImageProcessor](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltImageProcessor) để xử lý ảnh).
pixel_mask (`torch.LongTensor` có hình dạng `(batch_size, height, width)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các giá trị pixel đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các pixel thực (tức là **không bị che**), - 0 cho các pixel đệm (tức là **bị che**). [Mặt nạ chú ý là gì?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `input_ids`, bạn có thể chọn cách truyền trực tiếp một biểu diễn nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi các chỉ số `input_ids` thành các vector liên quan so với ma trận tra cứu nhúng nội bộ của mô hình.
image_embeds (`torch.Tensor` có hình dạng `(batch_size, num_patches, hidden_size)`, *tùy chọn*) : Tùy chọn, thay vì truyền `pixel_values`, bạn có thể chọn truyền trực tiếp một biểu diễn đã nhúng. Điều này hữu ích nếu bạn muốn kiểm soát nhiều hơn cách chuyển đổi `pixel_values` thành các patch embeddings.
labels (`torch.LongTensor` có hình dạng `(batch_size, text_sequence_length)`, *tùy chọn*) : Nhãn để tính toán tổn thất phân loại token. Chỉ số phải nằm trong `[0, ..., config.num_labels - 1]`.
output_attentions (`bool`, *tùy chọn*) : Có trả về các tensor chú ý của tất cả các lớp chú ý hay không. Xem `attentions` trong phần tensor trả về để biết thêm chi tiết.
output_hidden_states (`bool`, *tuỳ chọn*) : Có trả về trạng thái ẩn của tất cả các lớp hay không. Xem `hidden_states` trong phần tensor trả về để biết thêm chi tiết.
return_dict (`bool`, *tùy chọn*) : Có trả về [ModelOutput](/docs/transformers/main/vi/main_classes/output#transformers.utils.ModelOutput) thay vì một tuple thông thường hay không.
**Trả về:** [TokenClassifierOutput](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.TokenClassifierOutput) hoặc `tuple(torch.Tensor)`
Một [TokenClassifierOutput](/docs/transformers/main/vi/main_classes/output#transformers.modeling_outputs.TokenClassifierOutput) hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([ViltConfig](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltConfig)) và đầu vào.
Phương thức forward của [ViltForTokenClassification](/docs/transformers/main/vi/model_doc/vilt#transformers.ViltForTokenClassification) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **loss** (`torch.Tensor` có hình dạng `(1,)`, *tùy chọn*, được trả về khi `labels` được cung cấp) -- Tổn phân loại.
- **logits** (`torch.Tensor` có hình dạng `(batch_size, sequence_length, config.num_labels)`) -- Điểm phân loại (trước SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple của `torch.Tensor` (một cho đầu ra của các embedding, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
```python
>>> from transformers import AutoTokenizer, ViltForTokenClassification
>>> import torch
>>> tokenizer = AutoTokenizer.from_pretrained("dandelin/vilt-b32-mlm")
>>> model = ViltForTokenClassification.from_pretrained("dandelin/vilt-b32-mlm")
>>> inputs = tokenizer(
... "HuggingFace is a company based in Paris and New York", add_special_tokens=False, return_tensors="pt"
... )
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> predicted_token_class_ids = logits.argmax(-1)
>>> # Note that tokens are classified rather then input words which means that
>>> # there might be more predicted token classes than words.
>>> # Multiple token classes might account for the same word
>>> predicted_tokens_classes = [model.config.id2label[t.item()] for t in predicted_token_class_ids[0]]
>>> predicted_tokens_classes
...
>>> labels = predicted_token_class_ids
>>> loss = model(**inputs, labels=labels).loss
>>> round(loss.item(), 2)
...
```