# TVP
## Обзор
Фреймворк текстово-визуального промптинга (TVP) был предложен в статье [Text-Visual Prompting for Efficient 2D Temporal Video Grounding](https://huggingface.co/papers/2303.04995) авторами Yimeng Zhang, Xin Chen, Jinghan Jia, Sijia Liu, Ke Ding.
Аннотация из статьи следующая:
*В данной статье мы рассматриваем задачу временного привязывания видео (TVG), цель которой — предсказать начальные и конечные временные точки моментов, описанных текстовым предложением, в длинном необрезанном видео. Благодаря детализированным 3D-визуальным признакам, методы TVG достигли значительного прогресса в последние годы. Однако высокая сложность 3D-сверточных нейронных сетей (CNN) делает извлечение плотных 3D-визуальных признаков трудоемким процессом, требующим значительных вычислительных и ресурсных затрат. В целях эффективного TVG мы предлагаем новый фреймворк текстово-визуального промптинга (TVP), который внедряет оптимизированные паттерны возмущений (которые мы называем «промптами») как в визуальные входные данные, так и в текстовые признаки модели TVG. В резком контрасте с 3D CNN мы показываем, что TVP позволяет эффективно совместно обучать визуальный и языковой энкодеры в 2D-модели TVG и улучшает качество кросс-модального слияния признаков, используя лишь низкокомплексные разреженные 2D-визуальные признаки. Кроме того, мы предлагаем функцию потерь Temporal-Distance IoU (TDIoU) для эффективного обучения TVG. Эксперименты на двух эталонных наборах данных, Charades-STA и ActivityNet Captions, эмпирически демонстрируют, что предложенный TVP значительно повышает производительность 2D TVG (например, улучшение на 9,79% на Charades-STA и на 30,77% на ActivityNet Captions) и обеспечивает ускорение инференса в 5 раз по сравнению с TVG, использующим 3D-визуальные признаки.*
Это исследование посвящено временному привязыванию видео (TVG) — процессу точного определения начального и конечного времени конкретных событий в длинном видео, описанных текстовым предложением. Для улучшения TVG предлагается метод текстово-визуального промптинга (TVP). TVP предполагает интеграцию специально разработанных паттернов, известных как «промпты», в визуальные (на основе изображений) и текстовые (на основе слов) входные компоненты модели TVG. Эти промпты обеспечивают дополнительный пространственно-временной контекст, улучшая способность модели точно определять время событий в видео. Подход использует 2D-визуальные входные данные вместо 3D. Хотя 3D-входные данные предоставляют более подробный пространственно-временной контекст, их обработка требует больше времени. Использование 2D-входных данных в сочетании с методом промптинга направлено на обеспечение сопоставимого уровня контекста и точности более эффективным способом.
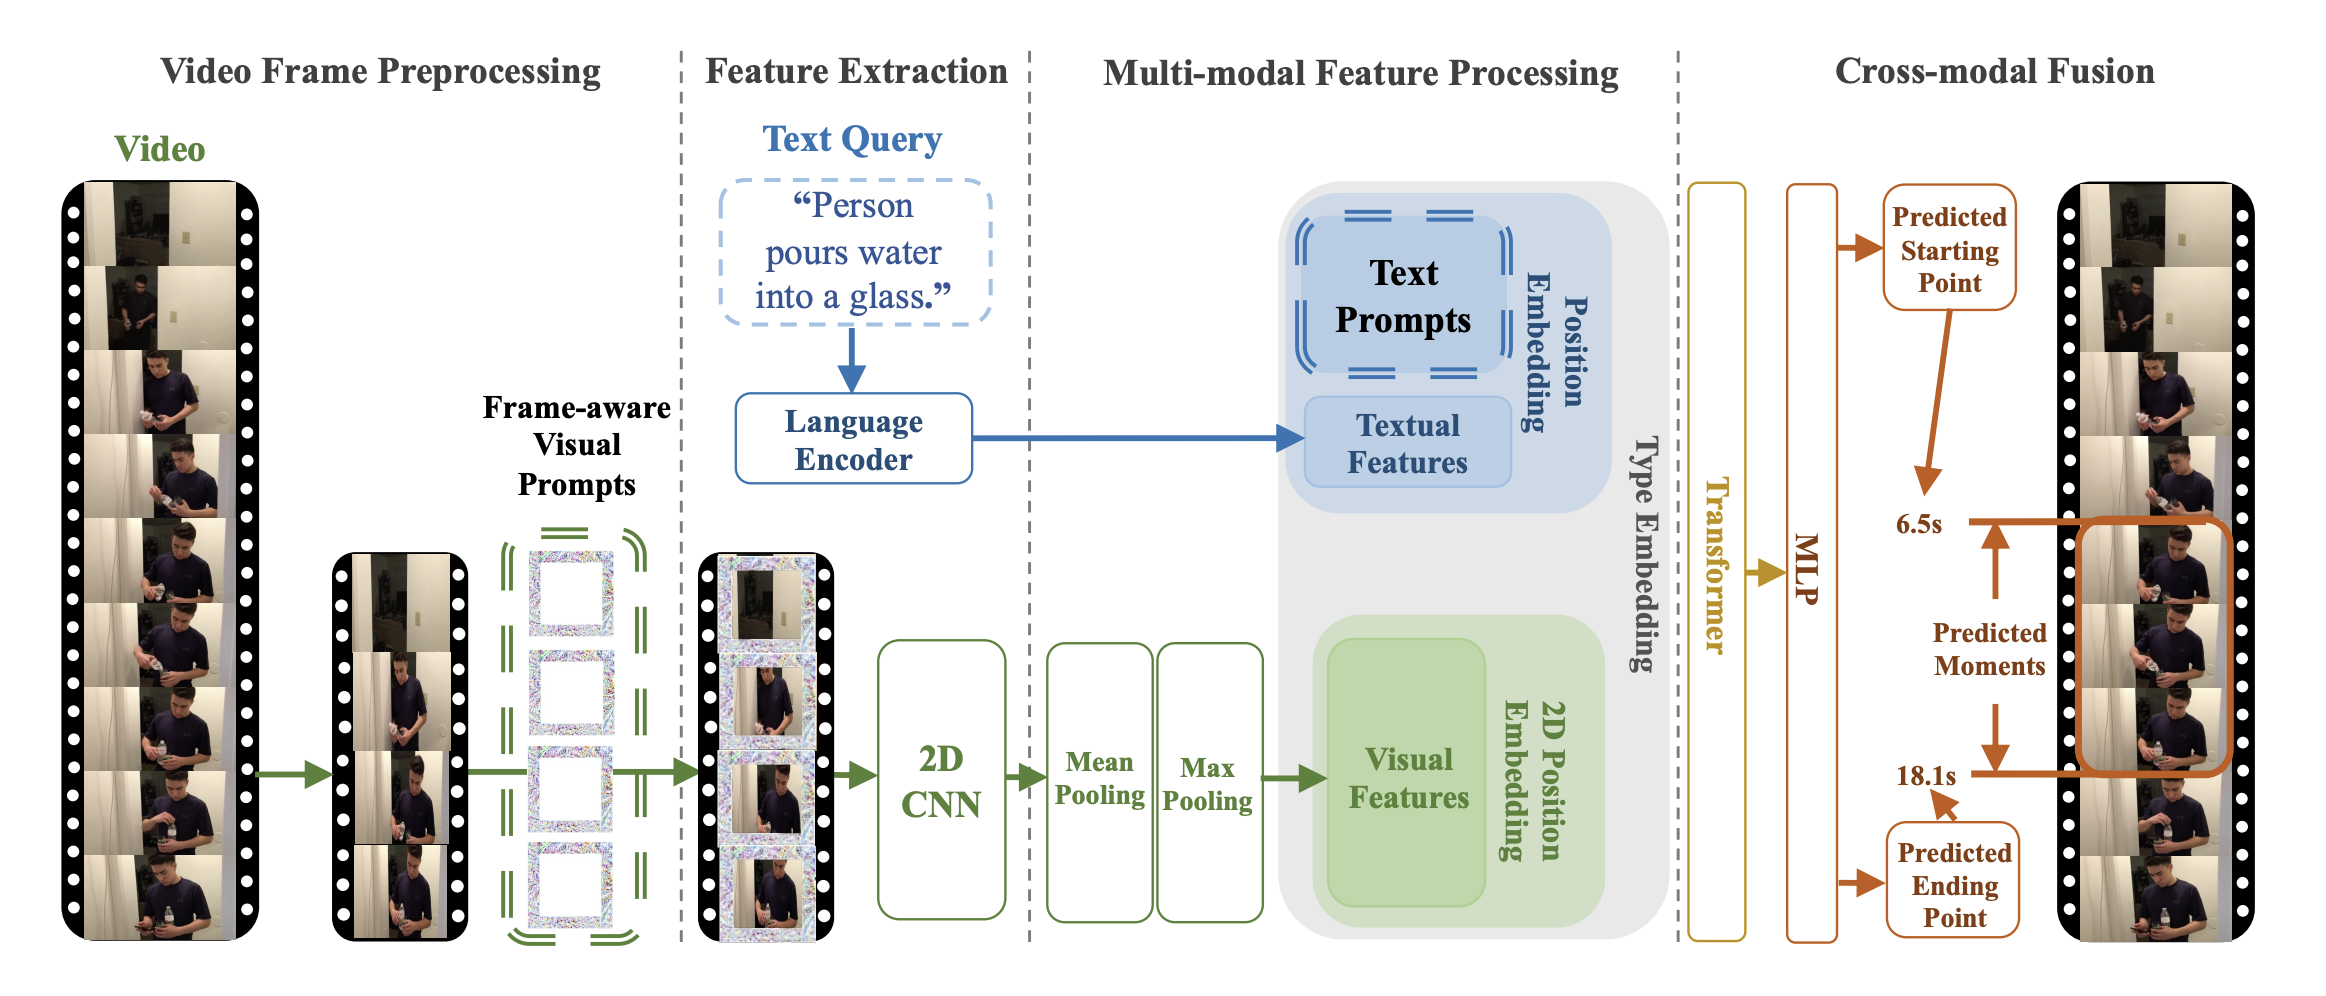 Архитектура TVP. Взято из оригинальной статьи.
Эта модель была предоставлена [Jiqing Feng](https://huggingface.co/Jiqing). Исходный код можно найти [здесь](https://github.com/intel/TVP).
## Советы по использованию и примеры
Промпты представляют собой оптимизированные паттерны возмущений, которые добавляются к кадрам входного видео или текстовым признакам. Универсальный набор означает использование одного и того же набора промптов для любого входа, то есть эти промпты последовательно добавляются ко всем кадрам видео и текстовым признакам независимо от содержимого входа.
TVP состоит из визуального энкодера и кросс-модального энкодера. Универсальный набор визуальных промптов и текстовых промптов, которые интегрируются в выборочные кадры видео и текстовые признаки соответственно. В частности, набор различных визуальных промптов последовательно применяется к равномерно выбранным кадрам одного необрезанного видео.
Целью этой модели является интеграция обучаемых промптов как в визуальные входные данные, так и в текстовые признаки для задач временного привязывания видео (TVG). В принципе, в предложенной архитектуре можно использовать любой визуальный или кросс-модальный энкодер.
Класс [TvpProcessor](/docs/transformers/v5.23.0/ru/model_doc/tvp#transformers.TvpProcessor) объединяет [BertTokenizer](/docs/transformers/v5.23.0/ru/model_doc/lxmert#transformers.BertTokenizer) и [TvpImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/tvp#transformers.TvpImageProcessor) в единый экземпляр, чтобы кодировать текст и готовить изображения соответственно.
В следующем примере показано, как выполнять временнóе локализацию видео с помощью [TvpProcessor](/docs/transformers/v5.23.0/ru/model_doc/tvp#transformers.TvpProcessor) и [TvpForVideoGrounding](/docs/transformers/v5.23.0/ru/model_doc/tvp#transformers.TvpForVideoGrounding).
```python
import av
import cv2
import numpy as np
from huggingface_hub import hf_hub_download
from transformers import AutoProcessor, TvpForVideoGrounding
def pyav_decode(container, sampling_rate, num_frames, clip_idx, num_clips, target_fps):
'''
Convert the video from its original fps to the target_fps and decode the video with PyAV decoder.
Args:
container (container): pyav container.
sampling_rate (int): frame sampling rate (interval between two sampled frames).
num_frames (int): number of frames to sample.
clip_idx (int): if clip_idx is -1, perform random temporal sampling.
If clip_idx is larger than -1, uniformly split the video to num_clips
clips, and select the clip_idx-th video clip.
num_clips (int): overall number of clips to uniformly sample from the given video.
target_fps (int): the input video may have different fps, convert it to
the target video fps before frame sampling.
Returns:
frames (tensor): decoded frames from the video. Return None if the no
video stream was found.
fps (float): the number of frames per second of the video.
'''
video = container.streams.video[0]
fps = float(video.average_rate)
clip_size = sampling_rate * num_frames / target_fps * fps
delta = max(num_frames - clip_size, 0)
start_idx = delta * clip_idx / num_clips
end_idx = start_idx + clip_size - 1
timebase = video.duration / num_frames
video_start_pts = int(start_idx * timebase)
video_end_pts = int(end_idx * timebase)
seek_offset = max(video_start_pts - 1024, 0)
container.seek(seek_offset, any_frame=False, backward=True, stream=video)
frames = {}
for frame in container.decode(video=0):
if frame.pts < video_start_pts:
continue
frames[frame.pts] = frame
if frame.pts > video_end_pts:
break
frames = [frames[pts] for pts in sorted(frames)]
return frames, fps
def decode(container, sampling_rate, num_frames, clip_idx, num_clips, target_fps):
'''
Decode the video and perform temporal sampling.
Args:
container (container): pyav container.
sampling_rate (int): frame sampling rate (interval between two sampled frames).
num_frames (int): number of frames to sample.
clip_idx (int): if clip_idx is -1, perform random temporal sampling.
If clip_idx is larger than -1, uniformly split the video to num_clips
clips, and select the clip_idx-th video clip.
num_clips (int): overall number of clips to uniformly sample from the given video.
target_fps (int): the input video may have different fps, convert it to
the target video fps before frame sampling.
Returns:
frames (tensor): decoded frames from the video.
'''
assert clip_idx >= -2, f"Not a valid clip_idx {clip_idx}"
frames, fps = pyav_decode(container, sampling_rate, num_frames, clip_idx, num_clips, target_fps)
clip_size = sampling_rate * num_frames / target_fps * fps
index = np.linspace(0, clip_size - 1, num_frames)
index = np.clip(index, 0, len(frames) - 1).astype(np.int64)
frames = np.array([frames[idx].to_rgb().to_ndarray() for idx in index])
frames = frames.transpose(0, 3, 1, 2)
return frames
file = hf_hub_download(repo_id="Intel/tvp_demo", filename="AK2KG.mp4", repo_type="dataset")
model = TvpForVideoGrounding.from_pretrained("Intel/tvp-base", device_map="auto")
decoder_kwargs = dict(
container=av.open(file, metadata_errors="ignore"),
sampling_rate=1,
num_frames=model.config.num_frames,
clip_idx=0,
num_clips=1,
target_fps=3,
)
raw_sampled_frms = decode(**decoder_kwargs)
text = "a person is sitting on a bed."
processor = AutoProcessor.from_pretrained("Intel/tvp-base")
model_inputs = processor(
text=[text], videos=list(raw_sampled_frms), return_tensors="pt", max_text_length=100#, size=size
)
model_inputs["pixel_values"] = model_inputs["pixel_values"].to(model.dtype)
output = model(**model_inputs)
def get_video_duration(filename):
cap = cv2.VideoCapture(filename)
if cap.isOpened():
rate = cap.get(5)
frame_num = cap.get(7)
duration = frame_num/rate
return duration
return -1
duration = get_video_duration(file)
start, end = processor.post_process_video_grounding(output.logits, duration)
print(f"The time slot of the video corresponding to the text \"{text}\" is from {start}s to {end}s")
```
Советы:
- Эта реализация TVP использует [BertTokenizer](/docs/transformers/v5.23.0/ru/model_doc/lxmert#transformers.BertTokenizer) для генерации текстовых эмбеддингов и модель Resnet-50 для вычисления визуальных эмбеддингов.
- Чекпоинты для предобученной модели [tvp-base](https://huggingface.co/Intel/tvp-base) опубликованы.
- См. [Таблицу 2](https://huggingface.co/papers/2303.04995) для оценки производительности TVP на задаче Temporal Video Grounding.
## TvpConfig[[transformers.TvpConfig]]
#### transformers.TvpConfig[[transformers.TvpConfig]]
```python
transformers.TvpConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, backbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, distance_loss_weight: float = 1.0, duration_loss_weight: float = 0.1, visual_prompter_type: str = 'framepad', visual_prompter_apply: str = 'replace', visual_prompt_size: int = 96, max_img_size: int = 448, num_frames: int = 48, vocab_size: int = 30522, type_vocab_size: int = 2, hidden_size: int = 768, intermediate_size: int = 3072, num_hidden_layers: int = 12, num_attention_heads: int = 12, max_position_embeddings: int = 512, max_grid_col_position_embeddings: int = 100, max_grid_row_position_embeddings: int = 100, hidden_dropout_prob: float | int = 0.1, hidden_act: str = 'gelu', layer_norm_eps: float = 1e-12, initializer_range: float = 0.02, attention_probs_dropout_prob: float | int = 0.1, pad_token_id: int | None = None)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/configuration_tvp.py#L25)
**Параметры:**
backbone_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *необязательный*) : Конфигурация базовой модели.
distance_loss_weight (`float`, *необязательный*, по умолчанию 1.0) : Вес потери расстояния.
duration_loss_weight (`float`, *необязательный*, по умолчанию 0.1) : Вес функции потерь длительности.
visual_prompter_type (`str`, *необязательный*, по умолчанию `"framepad"`) : Тип визуального промпта. Тип отступов. Framepad означает отступы для каждого кадра. Должно быть одним из "framepad" или "framedownpad"
visual_prompter_apply (`str`, *необязательный*, по умолчанию `"replace"`) : Способ применения визуального промпта. Вариант replace означает, что значение промпта используется для изменения исходного значения во визуальных входных данных. Допустимые значения: "replace", "add", "remove".
visual_prompt_size (`int`, *необязательный*, по умолчанию 96) : Размер визуального промпта.
max_img_size (`int`, *optional*, по умолчанию 448) : Максимальный размер кадра.
num_frames (`int`, *optional*, по умолчанию 48) : Количество кадров, извлекаемых из видео.
vocab_size (`int`, *необязательный*, по умолчанию `30522`) : Размер словаря модели. Определяет количество различных токенов, которые могут быть представлены в `input_ids`.
type_vocab_size (`int`, *необязательный*, по умолчанию `2`) : Размер словаря для `token_type_ids`.
hidden_size (`int`, *optional*, по умолчанию `768`) : Размерность скрытых представлений.
intermediate_size (`int`, *optional*, по умолчанию `3072`) : Размерность представлений MLP.
num_hidden_layers (`int`, *необязательный*, по умолчанию `12`) : Количество скрытых слоев в декодере Transformer.
num_attention_heads (`int`, *необязательный*, по умолчанию `12`) : Количество головок внимания для каждого слоя внимания в декодере Transformer.
max_position_embeddings (`int`, *optional*, по умолчанию 512) : Максимальная длина последовательности, с которой эта модель может использоваться. Как правило, стоит задать достаточно большое значение на всякий случай (например, 512, 1024 или 2048).
max_grid_col_position_embeddings (`int`, *optional*, по умолчанию 100) : Максимальное количество горизонтальных фрагментов из кадра видео.
max_grid_row_position_embeddings (`int`, *optional*, по умолчанию 100) : Максимальное количество вертикальных патчей из кадра видео.
hidden_dropout_prob (`Union[float, int]`, *необязательный*, по умолчанию `0.1`) : Вероятность dropout для всех полносвязных слоев в эмбеддингах, энкодере и пулере.
hidden_act (`str`, *необязательный*, по умолчанию `gelu`) : Нелинейная функция активации (функция или строка) в декодере. Например, `"gelu"`, `"relu"`, `"silu"` и т. д.
layer_norm_eps (`float`, *необязательный*, по умолчанию `1e-12`) : Значение epsilon, используемое слоями нормализации.
initializer_range (`float`, *необязательный*, по умолчанию `0.02`) : Стандартное отклонение truncated_normal_initializer для инициализации всех матриц весов.
attention_probs_dropout_prob (`Union[float, int]`, *необязательный*, по умолчанию `0.1`) : Доля dropout для вероятностей внимания.
pad_token_id (`int`, *необязательный*) : Идентификатор токена, используемый для выравнивания в словаре.
Это класс конфигурации для хранения настроек модели TvpModel. Он используется для создания модели Tvp в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации [Intel/tvp-base](https://huggingface.co/Intel/tvp-base)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig).
## TvpImageProcessor[[transformers.TvpImageProcessor]]
#### transformers.TvpImageProcessor[[transformers.TvpImageProcessor]]
```python
transformers.TvpImageProcessor(**kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/image_processing_tvp.py#L50)
**Параметры:**
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли изменять размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'longest_edge' : 448}`): Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *optional*, по умолчанию `False`) : Использовать ли квадратное изображение по умолчанию при изменении размера, если size является int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'height' : 448, 'width': 448}`): Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, по умолчанию `2`) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только если `do_resize` установлено в `True`.
do_rescale (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*, по умолчанию `0.00392156862745098`) : Коэффициент масштабирования для изменения масштаба изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.5, 0.5, 0.5]`) : Средние значения изображения для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.5, 0.5, 0.5]`) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли дополнять изображение. Дополнение выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия дополнения зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'height' : 448, 'width': 448}`): размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли выполнять центрированный кроп изображения.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
do_flip_channel_order (`bool`, *kwargs*, *optional*, по умолчанию `self.do_flip_channel_order`) : Нужно ли изменить порядок каналов изображения с RGB на BGR.
constant_values (`float`, *kwargs* или `List[float]`, *optional*, по умолчанию `self.constant_values`) : Значение, используемое для заполнения области отступов, когда `pad_mode` равно `'constant'`.
pad_mode (`str`, *kwargs*, *optional*, по умолчанию `self.pad_mode`) : Режим дополнения — `'constant'`, `'edge'`, `'reflect'` или `'symmetric'`.
Создаёт процессор изображений TvpImageProcessor.
#### preprocess[[transformers.TvpImageProcessor.preprocess]]
```python
preprocess(videos: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], list[typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]], list[list[typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]]]], **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/image_processing_tvp.py#L72)
**Параметры:**
videos (`ImageInput` или `list[ImageInput]` или `list[list[ImageInput]]`) : Кадры для предварительной обработки.
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли изменить размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *необязательный*) : Указывает, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задан как int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только при установке `do_resize` в `True`.
do_rescale (`bool`, *kwargs*, *необязательный*) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*) : Коэффициент масштабирования для изменения размера изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *необязательный*) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Среднее значение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
do_flip_channel_order (`bool`, *kwargs*, *optional*, по умолчанию `self.do_flip_channel_order`) : Нужно ли изменить порядок каналов изображения с RGB на BGR.
constant_values (`float`, *kwargs* или `List[float]`, *optional*, по умолчанию `self.constant_values`) : Значение, используемое для заполнения области отступов, когда `pad_mode` равно `'constant'`.
pad_mode (`str`, *kwargs*, *optional*, по умолчанию `self.pad_mode`) : Режим дополнения — `'constant'`, `'edge'`, `'reflect'` или `'symmetric'`.
**Возвращает:** `~image_processing_base.BatchFeature`
- **data** (`dict`) — Словарь списков/массивов/тензоров, возвращаемый методом __call__ ('pixel_values' и т. д.).
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
## TvpImageProcessorPil[[transformers.TvpImageProcessorPil]]
#### transformers.TvpImageProcessorPil[[transformers.TvpImageProcessorPil]]
```python
transformers.TvpImageProcessorPil(**kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/image_processing_pil_tvp.py#L72)
**Параметры:**
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли изменять размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'longest_edge' : 448}`): Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *optional*, по умолчанию `False`) : Использовать ли квадратное изображение по умолчанию при изменении размера, если size является int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'height' : 448, 'width': 448}`): Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, по умолчанию `2`) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только если `do_resize` установлено в `True`.
do_rescale (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*, по умолчанию `0.00392156862745098`) : Коэффициент масштабирования для изменения масштаба изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.5, 0.5, 0.5]`) : Средние значения изображения для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.5, 0.5, 0.5]`) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли дополнять изображение. Дополнение выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия дополнения зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'height' : 448, 'width': 448}`): размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли выполнять центрированный кроп изображения.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
do_flip_channel_order (`bool`, *kwargs*, *optional*, по умолчанию `self.do_flip_channel_order`) : Нужно ли изменить порядок каналов изображения с RGB на BGR.
constant_values (`float`, *kwargs* или `List[float]`, *optional*, по умолчанию `self.constant_values`) : Значение, используемое для заполнения области отступов, когда `pad_mode` равно `'constant'`.
pad_mode (`str`, *kwargs*, *optional*, по умолчанию `self.pad_mode`) : Режим дополнения — `'constant'`, `'edge'`, `'reflect'` или `'symmetric'`.
Создаёт процессор изображений TvpImageProcessor.
#### preprocess[[transformers.TvpImageProcessorPil.preprocess]]
```python
preprocess(videos: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], list[typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]], list[list[typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]]]], **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/image_processing_pil_tvp.py#L94)
**Параметры:**
videos (`ImageInput` или `list[ImageInput]` или `list[list[ImageInput]]`) : Кадры для предварительной обработки.
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли изменить размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *необязательный*) : Указывает, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задан как int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только при установке `do_resize` в `True`.
do_rescale (`bool`, *kwargs*, *необязательный*) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*) : Коэффициент масштабирования для изменения размера изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *необязательный*) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Среднее значение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
do_flip_channel_order (`bool`, *kwargs*, *optional*, по умолчанию `self.do_flip_channel_order`) : Нужно ли изменить порядок каналов изображения с RGB на BGR.
constant_values (`float`, *kwargs* или `List[float]`, *optional*, по умолчанию `self.constant_values`) : Значение, используемое для заполнения области отступов, когда `pad_mode` равно `'constant'`.
pad_mode (`str`, *kwargs*, *optional*, по умолчанию `self.pad_mode`) : Режим дополнения — `'constant'`, `'edge'`, `'reflect'` или `'symmetric'`.
**Возвращает:** `~image_processing_base.BatchFeature`
- **data** (`dict`) — Словарь списков/массивов/тензоров, возвращаемый методом __call__ ('pixel_values' и т. д.).
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
## TvpProcessor[[transformers.TvpProcessor]]
#### transformers.TvpProcessor[[transformers.TvpProcessor]]
```python
transformers.TvpProcessor(image_processor = None, tokenizer = None, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/processing_tvp.py#L24)
**Параметры:**
image_processor (`TvpImageProcessor`) : процессор изображений является обязательным входным параметром.
tokenizer (`BertTokenizer`) : Токенизатор является обязательным входным параметром.
Создаёт TvpProcessor, который объединяет image processor и tokenizer в единый процессор.
[TvpProcessor](/docs/transformers/v5.23.0/ru/model_doc/tvp#transformers.TvpProcessor) предоставляет все возможности [TvpImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/tvp#transformers.TvpImageProcessor) и [BertTokenizer](/docs/transformers/v5.23.0/ru/model_doc/lxmert#transformers.BertTokenizer). Подробнее см. в документации [~TvpImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/tvp#transformers.TvpImageProcessor) и [~BertTokenizer](/docs/transformers/v5.23.0/ru/model_doc/lxmert#transformers.BertTokenizer).
#### __call__[[transformers.TvpProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L670)
**Параметры:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *необязательный*) : Изображение для предварительной обработки. Ожидается одно изображение или пакет изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установите `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *необязательный*) : Последовательность или батч последовательностей для кодирования. Каждая последовательность может быть строкой или списком строк (предтокенизированная строка). Если вы передаёте предтокенизированный вход, установите `is_split_into_words=True`, чтобы избежать неоднозначности с батчированными входами.
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`, *optional*) : Видео для предобработки. Ожидается одно видео или батч видео со значениями пикселей в диапазоне от 0 до 255. Если передаются видео со значениями пикселей от 0 до 1, установите `do_rescale=False`.
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`, *необязательный*) : Аудио или пакет аудио для подготовки. Каждое аудио может быть массивом NumPy или тензором PyTorch. В случае массива NumPy/тензора PyTorch каждое аудио должно иметь форму (C, T), где C — количество каналов, а T — длина выборки аудио.
return_mm_token_type_ids (`bool`, *kwargs*) : Нужно ли возвращать идентификаторы типов мультимодальных токенов, указывающие на позиции мультимодальных плейсхолдер-токенов.
return_text_replacement_offsets (`bool`, *kwargs*) : Нужно ли возвращать смещения символов для каждого мультимодального плейсхолдера и его замены.
return_tensors (`str` или [TensorType](/docs/transformers/v5.23.0/ru/internal/file_utils#transformers.TensorType), *optional*) : Если задано, возвращает тензоры конкретного фреймворка. Допустимые значения: - `'pt'`: возвращает объекты `torch.Tensor` PyTorch. - `'np'`: возвращает объекты `np.ndarray` NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/v5.23.0/ru/main_classes/processors#transformers.ProcessingKwargs), *optional*) : Дополнительные параметры обработки для каждой модальности (текст, изображения, видео, аудио). Специфичные для модели параметры перечислены выше; полный список поддерживаемых аргументов см. в классе TypedDict.
## TvpModel[[transformers.TvpModel]]
#### transformers.TvpModel[[transformers.TvpModel]]
```python
transformers.TvpModel(config: TvpConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/modeling_tvp.py#L684)
**Параметры:**
config ([TvpConfig](/docs/transformers/v5.23.0/ru/model_doc/tvp#transformers.TvpConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Базовый трансформер Tvp Model, выводящий объект BaseModelOutputWithPooling без какого-либо специализированного слоя (head) сверху.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.TvpModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, interpolate_pos_encoding: bool = False, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/modeling_tvp.py#L707)
**Параметры:**
input_ids (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательно*) : Индексы токенов входной последовательности в словаре. По умолчанию заполнение (padding) игнорируется. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/v5.23.0/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные идентификаторы?](../glossary#input-ids)
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [TvpImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/tvp#transformers.TvpImageProcessor). Подробности см. в [TvpImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([TvpProcessor](/docs/transformers/v5.23.0/ru/model_doc/tvp#transformers.TvpProcessor) использует [TvpImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/tvp#transformers.TvpImageProcessor) для обработки изображений).
attention_mask (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
output_attentions (`bool`, *необязательный*) : Нужно ли возвращать тензоры внимания всех слоев внимания. Подробнее см. `attentions` в разделе возвращаемых тензоров.
output_hidden_states (`bool`, *необязательный*) : Нужно ли возвращать скрытые состояния всех слоёв. Подробнее о `hidden_states` в разделе возвращаемых тензоров.
return_dict (`bool`, *необязательный*) : Нужно ли возвращать [ModelOutput](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.utils.ModelOutput) вместо обычного кортежа.
interpolate_pos_encoding (`bool`, *необязательный*, по умолчанию `False`) : Интерполировать ли предобученные позиционные кодирования.
**Возвращает:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или `tuple(torch.Tensor)`
Объект [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([TvpConfig](/docs/transformers/v5.23.0/ru/model_doc/tvp#transformers.TvpConfig)) и входных данных.
Метод forward класса [TvpModel](/docs/transformers/v5.23.0/ru/model_doc/tvp#transformers.TvpModel) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`) -- Последовательность скрытых состояний на выходе последнего слоя модели.
- **pooler_output** (`torch.Tensor` формы `(batch_size, hidden_size)`) -- Скрытое состояние последнего слоя для первого токена последовательности (токен классификации) после дополнительной обработки слоями, используемыми для вспомогательной задачи предварительного обучения. Например, для моделей семейства BERT это возвращает токен классификации после обработки линейным слоем и функцией активации tanh. Веса линейного слоя обучаются по задаче предсказания следующего предложения (классификации) во время предварительного обучения.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
```python
>>> import torch
>>> from transformers import AutoConfig, AutoTokenizer, TvpModel
>>> model = TvpModel.from_pretrained("Jiqing/tiny-random-tvp")
>>> tokenizer = AutoTokenizer.from_pretrained("Jiqing/tiny-random-tvp")
>>> pixel_values = torch.rand(1, 1, 3, 448, 448)
>>> text_inputs = tokenizer("This is an example input", return_tensors="pt")
>>> output = model(text_inputs.input_ids, pixel_values, text_inputs.attention_mask)
```
## TvpForVideoGrounding[[transformers.TvpForVideoGrounding]]
#### transformers.TvpForVideoGrounding[[transformers.TvpForVideoGrounding]]
```python
transformers.TvpForVideoGrounding(config: TvpConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/modeling_tvp.py#L801)
**Параметры:**
config ([TvpConfig](/docs/transformers/v5.23.0/ru/model_doc/tvp#transformers.TvpConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель Tvp с головкой для привязки к видео, вычисляющей потери IoU, расстояния и длительности.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.TvpForVideoGrounding.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, labels: tuple[torch.Tensor] | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, interpolate_pos_encoding: bool = False, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/modeling_tvp.py#L810)
**Параметры:**
input_ids (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательно*) : Индексы токенов входной последовательности в словаре. По умолчанию заполнение (padding) игнорируется. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/v5.23.0/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные идентификаторы?](../glossary#input-ids)
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [TvpImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/tvp#transformers.TvpImageProcessor). Подробности см. в [TvpImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([TvpProcessor](/docs/transformers/v5.23.0/ru/model_doc/tvp#transformers.TvpProcessor) использует [TvpImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/tvp#transformers.TvpImageProcessor) для обработки изображений).
attention_mask (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
labels (`torch.Tensor` формы `(batch_size, 3)`, *необязательный*) : Метки содержат длительность, время начала и время окончания видео, соответствующего тексту.
output_attentions (`bool`, *необязательный*) : Нужно ли возвращать тензоры внимания всех слоев внимания. Подробнее см. `attentions` в разделе возвращаемых тензоров.
output_hidden_states (`bool`, *необязательный*) : Нужно ли возвращать скрытые состояния всех слоёв. Подробнее о `hidden_states` в разделе возвращаемых тензоров.
return_dict (`bool`, *необязательный*) : Нужно ли возвращать [ModelOutput](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.utils.ModelOutput) вместо обычного кортежа.
interpolate_pos_encoding (`bool`, *необязательный*, по умолчанию `False`) : Интерполировать ли предобученные позиционные кодирования.
**Возвращает:** `TvpVideoGroundingOutput` или `tuple(torch.Tensor)`
Объект `TvpVideoGroundingOutput` или кортеж из `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([TvpConfig](/docs/transformers/v5.23.0/ru/model_doc/tvp#transformers.TvpConfig)) и входных данных.
Метод [TvpForVideoGrounding](/docs/transformers/v5.23.0/ru/model_doc/tvp#transformers.TvpForVideoGrounding) forward переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если `return_loss` равно `True`) -- Потеря Temporal-Distance IoU для локализации видео.
- **logits** (`torch.Tensor` формы `(batch_size, 2)`) -- Содержит start_time/duration и end_time/duration. Это временные интервалы видео, соответствующие входным текстам.
- **hidden_states** (`tuple[torch.Tensor, ...]`, *необязательный*, возвращается, если передано `output_hidden_states=True` или если `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Примеры:
```python
>>> import torch
>>> from transformers import AutoConfig, AutoTokenizer, TvpForVideoGrounding
>>> model = TvpForVideoGrounding.from_pretrained("Jiqing/tiny-random-tvp")
>>> tokenizer = AutoTokenizer.from_pretrained("Jiqing/tiny-random-tvp")
>>> pixel_values = torch.rand(1, 1, 3, 448, 448)
>>> text_inputs = tokenizer("This is an example input", return_tensors="pt")
>>> output = model(text_inputs.input_ids, pixel_values, text_inputs.attention_mask)
```