# SAM
## Aperçu
SAM (Segment Anything Model) a été proposé dans [Segment Anything](https://huggingface.co/papers/2304.02643) par Alexander Kirillov, Eric Mintun, Nikhila Ravi, Hanzi Mao, Chloe Rolland, Laura Gustafson, Tete Xiao, Spencer Whitehead, Alex Berg, Wan-Yen Lo, Piotr Dollar, Ross Girshick.
Le modèle peut être utilisé pour prédire les masques de segmentation de tout objet d'intérêt à partir d'une image en entrée.
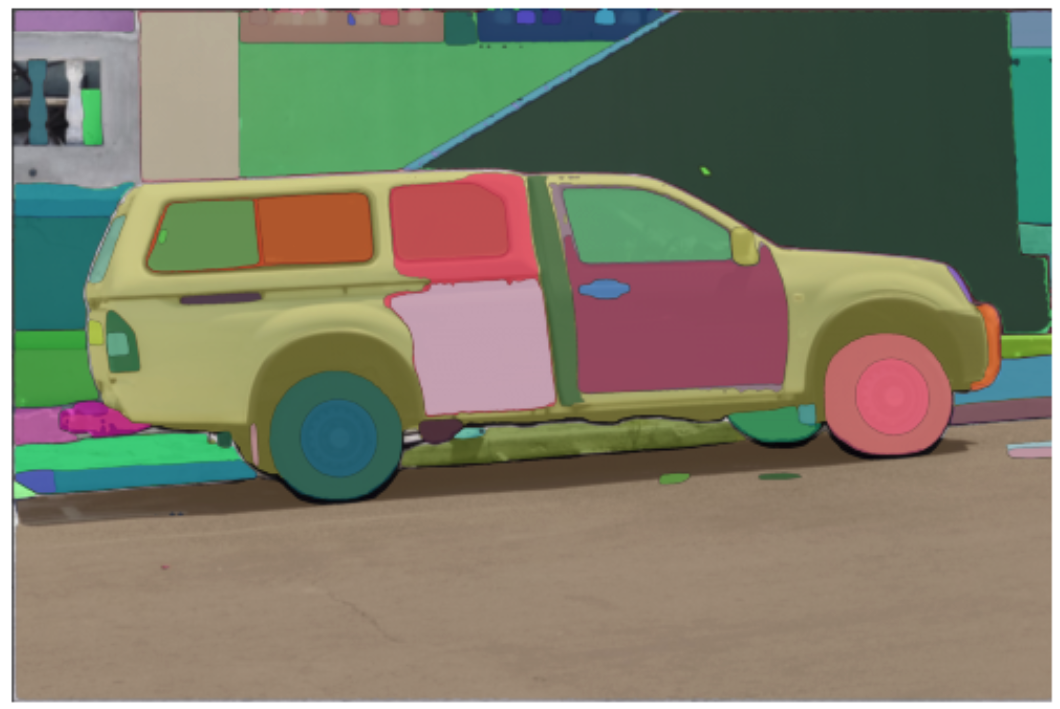
L'abstract de l'article est le suivant :
*Nous présentons le projet Segment Anything (SA) : une nouvelle tâche, un nouveau modèle et un nouveau jeu de données pour la segmentation d’images. En utilisant notre modèle efficace dans une boucle de collecte de données, nous avons constitué le plus grand jeu de données de segmentation à ce jour (de loin), avec plus d’un milliard de masques sur 11 millions d’images sous licence et respectant la vie privée. Le modèle est conçu et entraîné pour être pilotable par des prompts, ce qui lui permet de se transférer en zéro-shot à de nouvelles distributions d’images et à de nouvelles tâches. Nous évaluons ses capacités sur de nombreuses tâches et constatons que ses performances en zéro-shot sont impressionnantes — souvent compétitives, voire supérieures, aux résultats entièrement supervisés antérieurs. Nous publions le modèle Segment Anything (SAM) et le jeu de données correspondant (SA-1B), composé d’un milliard de masques et de 11 millions d’images, sur [https://segment-anything.com](https://segment-anything.com) afin de favoriser la recherche sur les modèles de fondation pour la vision par ordinateur.*
Astuces :
- Le modèle prédit des masques binaires qui indiquent la présence ou l'absence de l'objet d'intérêt à partir d'une image.
- Le modèle prédit des résultats bien meilleurs si des points 2D en entrée et/ou des boîtes englobantes en entrée sont fournis
- Vous pouvez indiquer plusieurs points pour la même image et prédire un seul masque.
- Le fine-tuning du modèle n'est pas encore pris en charge
- Selon l’article, l’entrée textuelle devrait également être prise en charge. Toutefois, à ce jour, cela ne semble pas être le cas, d’après [le dépôt officiel](https://github.com/facebookresearch/segment-anything/issues/4#issuecomment-1497626844).
Ce modèle a été contribué par [ybelkada](https://huggingface.co/ybelkada) et [ArthurZ](https://huggingface.co/ArthurZ). Le code d'origine est disponible [ici](https://github.com/facebookresearch/segment-anything).
Voici un exemple montrant comment exécuter la génération de masques à partir d'une image et d'un point 2D :
```python
import requests
import torch
from PIL import Image
from transformers import SamModel, SamProcessor
model = SamModel.from_pretrained("facebook/sam-vit-huge", device_map="auto")
processor = SamProcessor.from_pretrained("facebook/sam-vit-huge")
img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
input_points = [[[450, 600]]] # 2D location of a window in the image
inputs = processor(raw_image, input_points=input_points, return_tensors="pt").to(model.device)
with torch.no_grad():
outputs = model(**inputs)
masks = processor.image_processor.post_process_masks(
outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
```
Vous pouvez également traiter vos propres masques en parallèle des images d’entrée dans le processeur, afin qu’ils soient transmis au modèle.
```python
import requests
import torch
from PIL import Image
from transformers import SamModel, SamProcessor
model = SamModel.from_pretrained("facebook/sam-vit-huge", device_map="auto")
processor = SamProcessor.from_pretrained("facebook/sam-vit-huge")
img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
mask_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
segmentation_map = Image.open(requests.get(mask_url, stream=True).raw).convert("1")
input_points = [[[450, 600]]] # 2D location of a window in the image
inputs = processor(raw_image, input_points=input_points, segmentation_maps=segmentation_map, return_tensors="pt").to(model.device)
with torch.no_grad():
outputs = model(**inputs)
masks = processor.image_processor.post_process_masks(
outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
```
## Ressources
Une liste de ressources officielles Hugging Face et de la communauté (indiquées par 🌎) pour vous aider à démarrer avec SAM.
- [Cahier d'exemples](https://github.com/huggingface/notebooks/blob/main/examples/segment_anything.ipynb) pour l'utilisation du modèle.
- [Cahier de démonstration](https://github.com/huggingface/notebooks/blob/main/examples/automatic_mask_generation.ipynb) pour l'utilisation du pipeline de génération automatique de masques.
- [Cahier de démonstration](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/SAM/Run_inference_with_MedSAM_using_HuggingFace_Transformers.ipynb) pour l'inférence avec MedSAM, une version affinée de SAM sur le domaine médical. 🌎
- [Cahier de démonstration](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/SAM/Fine_tune_SAM_(segment_anything)_on_a_custom_dataset.ipynb) pour l'ajustement fin du modèle sur des données personnalisées. 🌎
## SlimSAM
SlimSAM, une version élaguée de SAM, a été proposée dans [0.1% Data Makes Segment Anything Slim](https://huggingface.co/papers/2312.05284) par Zigeng Chen et al. SlimSAM réduit considérablement la taille des modèles SAM tout en maintenant les mêmes performances.
Les points de contrôle sont disponibles sur le [hub](https://huggingface.co/models?other=slimsam) et peuvent être utilisés comme substitut direct de SAM.
## Grounded SAM
Il est possible de combiner [Grounding DINO](grounding-dino) avec SAM pour la génération de masques basée sur le texte, comme présenté dans [Grounded SAM: Assembling Open-World Models for Diverse Visual Tasks](https://huggingface.co/papers/2401.14159). Vous pouvez consulter ce [carnet de démonstration](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/Grounding%20DINO/GroundingDINO_with_Segment_Anything.ipynb) 🌍 pour plus de détails.
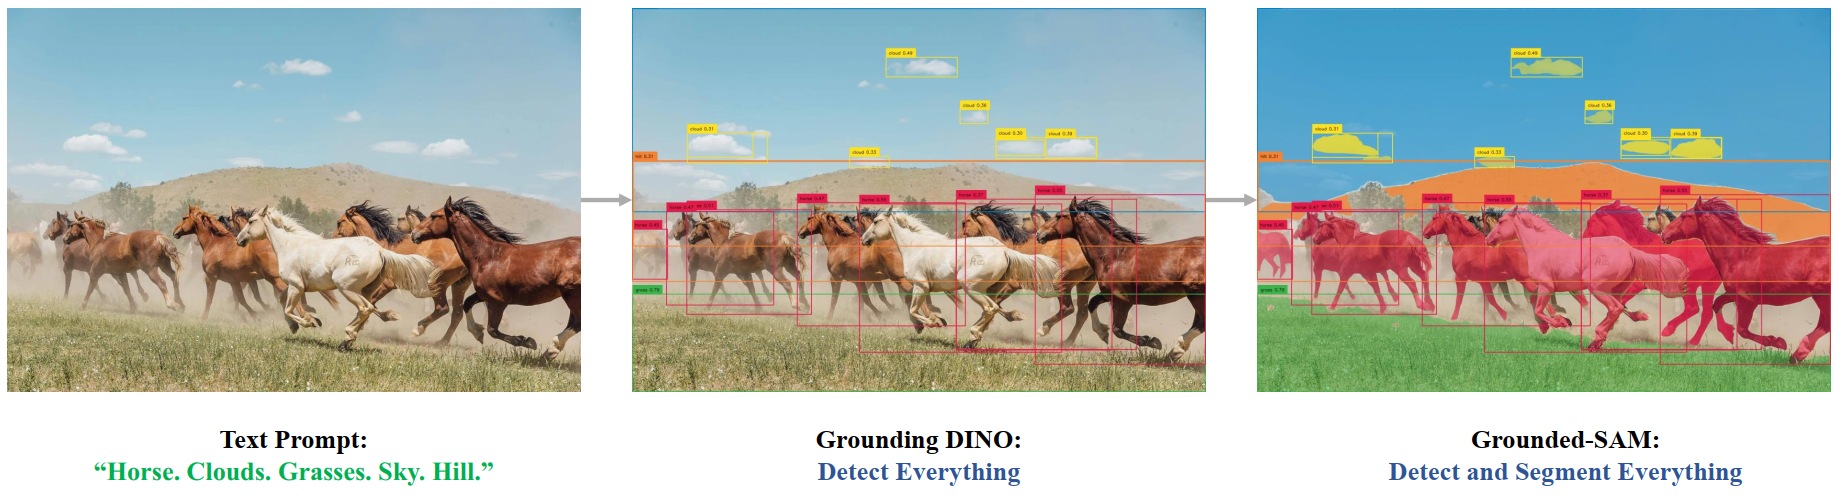 Aperçu de Grounded SAM. Extrait du dépôt d'origine.
## SamConfig[[transformers.SamConfig]]
#### transformers.SamConfig[[transformers.SamConfig]]
```python
transformers.SamConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, prompt_encoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, mask_decoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, initializer_range: float = 0.02, tie_word_embeddings: bool = True)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/configuration_sam.py#L146)
**Paramètres :**
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *facultatif*) : L'objet de configuration ou le dictionnaire du backbone visuel.
prompt_encoder_config (Union[`dict`, `SamPromptEncoderConfig`], *facultatif*) : Dictionnaire des options de configuration utilisées pour initialiser [SamPromptEncoderConfig](/docs/transformers/v5.23.0/fr/model_doc/sam#transformers.SamPromptEncoderConfig).
mask_decoder_config (Union[`dict`, `SamMaskDecoderConfig`], *facultatif*) : Dictionnaire des options de configuration utilisées pour initialiser [SamMaskDecoderConfig](/docs/transformers/v5.23.0/fr/model_doc/sam#transformers.SamMaskDecoderConfig).
initializer_range (`float`, *facultatif*, valeur par défaut `0.02`) : L'écart-type de la truncated_normal_initializer utilisé pour l'initialisation de toutes les matrices de poids.
tie_word_embeddings (`bool`, *facultatif*, valeur par défaut `True`) : Indique s'il faut lier les embeddings de poids selon la correspondance `tied_weights_keys` du modèle.
Ceci est la classe de configuration destinée à stocker la configuration d'un SamModel. Elle est utilisée pour instancier un modèle Sam en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [facebook/sam-vit-huge](https://huggingface.co/facebook/sam-vit-huge)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/v5.23.0/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/v5.23.0/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
Exemple :
```python
>>> from transformers import (
... SamVisionConfig,
... SamPromptEncoderConfig,
... SamMaskDecoderConfig,
... SamModel,
... )
>>> # Initializing a SamConfig with `"facebook/sam-vit-huge"` style configuration
>>> configuration = SamConfig()
>>> # Initializing a SamModel (with random weights) from the `"facebook/sam-vit-huge"` style configuration
>>> model = SamModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
>>> # We can also initialize a SamConfig from a SamVisionConfig, SamPromptEncoderConfig, and SamMaskDecoderConfig
>>> # Initializing SAM vision, SAM Q-Former and language model configurations
>>> vision_config = SamVisionConfig()
>>> prompt_encoder_config = SamPromptEncoderConfig()
>>> mask_decoder_config = SamMaskDecoderConfig()
>>> config = SamConfig(vision_config, prompt_encoder_config, mask_decoder_config)
```
## SamVisionConfig[[transformers.SamVisionConfig]]
#### transformers.SamVisionConfig[[transformers.SamVisionConfig]]
```python
transformers.SamVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, output_channels: int = 256, num_hidden_layers: int = 12, num_attention_heads: int = 12, num_channels: int = 3, image_size: int | list[int] | tuple[int, int] = 1024, patch_size: int | list[int] | tuple[int, int] = 16, hidden_act: str = 'gelu', layer_norm_eps: float = 1e-06, attention_dropout: float | int = 0.0, initializer_range: float = 1e-10, qkv_bias: bool = True, mlp_ratio: float = 4.0, use_abs_pos: bool = True, use_rel_pos: bool = True, window_size: int = 14, global_attn_indexes: list[int] | tuple[int, ...] = (2, 5, 8, 11), num_pos_feats: int = 128, mlp_dim: int | None = None)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/configuration_sam.py#L81)
**Paramètres :**
hidden_size (`int`, *facultatif*, par défaut `768`) : Dimension des représentations cachées.
output_channels (`int`, *facultatif*, valeur par défaut : 256) : Dimensionnalité des canaux de sortie dans le Patch Encoder.
num_hidden_layers (`int`, *facultatif*, par défaut `12`) : Nombre de couches cachées dans le décodeur Transformer.
num_attention_heads (`int`, *facultatif*, valeur par défaut `12`) : Nombre de têtes d'attention pour chaque couche d'attention du décodeur Transformer.
num_channels (`int`, *facultatif*, par défaut `3`) : Le nombre de canaux d'entrée.
image_size (`Union[int, list[int], tuple[int, int]]`, *facultatif*, valeur par défaut `1024`) : La taille (résolution) de chaque image.
patch_size (`Union[int, list[int], tuple[int, int]]`, *facultatif*, valeur par défaut `16`) : La taille (résolution) de chaque patch.
hidden_act (`str`, *facultatif*, par défaut `gelu`) : La fonction d'activation non linéaire (fonction ou chaîne de caractères) dans le décodeur. Par exemple, `"gelu"`, `"relu"`, `"silu"`, etc.
layer_norm_eps (`float`, *facultatif*, par défaut `1e-06`) : L'épsilon utilisé par les couches de normalisation par couche.
attention_dropout (`Union[float, int]`, *facultatif*, valeur par défaut `0.0`) : Le taux de dropout appliqué aux probabilités d'attention.
initializer_range (`float`, *facultatif*, valeur par défaut `1e-10`) : L'écart-type de truncated_normal_initializer pour l'initialisation de toutes les matrices de poids.
qkv_bias (`bool`, *facultatif*, par défaut `True`) : Indique s'il faut ajouter un biais aux requêtes, clés et valeurs.
mlp_ratio (`float`, *facultatif*, par défaut `4.0`) : Ratio de la dimension cachée du MLP par rapport à la dimension d'embedding.
use_abs_pos (`bool`, *facultatif*, valeur par défaut `True`) : Indique s'il faut utiliser des embeddings de position absolue.
use_rel_pos (`bool`, *facultatif*, par défaut `True`) : Indique s'il faut utiliser l'encodage de position relative.
window_size (`int`, *facultatif*, valeur par défaut 14) : Taille de la fenêtre pour la position relative.
global_attn_indexes (`list[int]`, *facultatif*, par défaut `[2, 5, 8, 11]`) : Les index des couches d'attention globale.
num_pos_feats (`int`, *facultatif*, valeur par défaut 128) : La dimension de l'incorporation de position.
mlp_dim (`int`, *facultatif*) : La dimensionnalité de la couche MLP dans l'encodeur Transformer. Si `None`, la valeur par défaut est `mlp_ratio * hidden_size`.
Ceci est la classe de configuration destinée à stocker la configuration d'un SamModel. Elle est utilisée pour instancier un modèle Sam en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [facebook/sam-vit-huge](https://huggingface.co/facebook/sam-vit-huge)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/v5.23.0/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/v5.23.0/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
Exemple :
```python
>>> from transformers import (
... SamVisionConfig,
... SamVisionModel,
... )
>>> # Initializing a SamVisionConfig with `"facebook/sam-vit-huge"` style configuration
>>> configuration = SamVisionConfig()
>>> # Initializing a SamVisionModel (with random weights) from the `"facebook/sam-vit-huge"` style configuration
>>> model = SamVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## SamMaskDecoderConfig[[transformers.SamMaskDecoderConfig]]
#### transformers.SamMaskDecoderConfig[[transformers.SamMaskDecoderConfig]]
```python
transformers.SamMaskDecoderConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 256, hidden_act: str = 'relu', mlp_dim: int = 2048, num_hidden_layers: int = 2, num_attention_heads: int = 8, attention_downsample_rate: int = 2, num_multimask_outputs: int = 3, iou_head_depth: int = 3, iou_head_hidden_dim: int = 256, layer_norm_eps: float = 1e-06)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/configuration_sam.py#L50)
**Paramètres :**
hidden_size (`int`, *facultatif*, par défaut `256`) : Dimension des représentations cachées.
hidden_act (`str`, *facultatif*, par défaut `relu`) : Fonction d'activation non linéaire (fonction ou chaîne de caractères) du décodeur. Par exemple, `"gelu"`, `"relu"`, `"silu"`, etc.
mlp_dim (`int`, *facultatif*, valeur par défaut 2048) : Dimension de la couche « intermédiaire » (c.-à-d. feed-forward) dans l'encodeur Transformer.
num_hidden_layers (`int`, *facultatif*, valeur par défaut `2`) : Nombre de couches cachées dans le décodeur Transformer.
num_attention_heads (`int`, *facultatif*, valeur par défaut `8`) : Nombre de têtes d'attention pour chaque couche d'attention du décodeur Transformer.
attention_downsample_rate (`int`, *facultatif*, valeur par défaut : 2) : Le taux de sous-échantillonnage de la couche d'attention.
num_multimask_outputs (`int`, *facultatif*, valeur par défaut : 3) : Le nombre de sorties du module `SamMaskDecoder`. Dans l'article Segment Anything, cette valeur est fixée à 3.
iou_head_depth (`int`, *facultatif*, valeur par défaut : 3) : Le nombre de couches dans le module de tête IoU.
iou_head_hidden_dim (`int`, *facultatif*, par défaut 256) : La dimension des états cachés dans le module de tête IoU.
layer_norm_eps (`float`, *facultatif*, par défaut `1e-06`) : L'épsilon utilisé par les couches de normalisation par couche.
Ceci est la classe de configuration destinée à stocker la configuration d'un SamModel. Elle est utilisée pour instancier un modèle Sam en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [facebook/sam-vit-huge](https://huggingface.co/facebook/sam-vit-huge)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/v5.23.0/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/v5.23.0/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
## SamPromptEncoderConfig[[transformers.SamPromptEncoderConfig]]
#### transformers.SamPromptEncoderConfig[[transformers.SamPromptEncoderConfig]]
```python
transformers.SamPromptEncoderConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 256, image_size: int | list[int] | tuple[int, int] = 1024, patch_size: int | list[int] | tuple[int, int] = 16, mask_input_channels: int = 16, num_point_embeddings: int = 4, hidden_act: str = 'gelu', layer_norm_eps: float = 1e-06)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/configuration_sam.py#L24)
**Paramètres :**
hidden_size (`int`, *facultatif*, par défaut `256`) : Dimension des représentations cachées.
image_size (`Union[int, list[int], tuple[int, int]]`, *facultatif*, valeur par défaut `1024`) : La taille (résolution) de chaque image.
patch_size (`Union[int, list[int], tuple[int, int]]`, *facultatif*, valeur par défaut `16`) : La taille (résolution) de chaque patch.
mask_input_channels (`int`, *facultatif*, valeur par défaut 16) : Le nombre de canaux à transmettre au module `MaskDecoder`.
num_point_embeddings (`int`, *facultatif*, valeur par défaut : 4) : Le nombre d'embeddings de points à utiliser.
hidden_act (`str`, *facultatif*, par défaut `gelu`) : La fonction d'activation non linéaire (fonction ou chaîne de caractères) dans le décodeur. Par exemple, `"gelu"`, `"relu"`, `"silu"`, etc.
layer_norm_eps (`float`, *facultatif*, par défaut `1e-06`) : L'épsilon utilisé par les couches de normalisation par couche.
Ceci est la classe de configuration destinée à stocker la configuration d'un SamModel. Elle est utilisée pour instancier un modèle Sam en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [facebook/sam-vit-huge](https://huggingface.co/facebook/sam-vit-huge)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/v5.23.0/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/v5.23.0/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
## SamProcessor[[transformers.SamProcessor]]
#### transformers.SamProcessor[[transformers.SamProcessor]]
```python
transformers.SamProcessor(image_processor)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/processing_sam.py#L93)
**Paramètres :**
image_processor (`SamImageProcessor`) : le processeur d'images est une entrée obligatoire.
Construit un SamProcessor qui encapsule un processeur d'image dans un processeur unique.
[SamProcessor](/docs/transformers/v5.23.0/fr/model_doc/sam#transformers.SamProcessor) propose toutes les fonctionnalités de [SamImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/sam#transformers.SamImageProcessor). Consultez [~SamImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/sam#transformers.SamImageProcessor) pour plus d'informations.
#### __appel__[[transformers.SamProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, input_points: NestedList | torch.Tensor | None = None, input_labels: NestedList | int | torch.Tensor | None = None, input_boxes: NestedList | torch.Tensor | None = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/processing_sam.py#L102)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *facultatif*) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *facultatif*) : La séquence ou le lot de séquences à encoder. Chaque séquence peut être une chaîne de caractères ou une liste de chaînes (chaîne pré-tokenisée). Si vous transmettez une entrée pré-tokenisée, définissez `is_split_into_words=True` pour éviter toute ambiguïté avec les entrées en lot.
segmentation_maps (`ImageInput`, *facultatif*) : Cartes de segmentation de référence à traiter avec les images d'entrée. Ces cartes sont utilisées à des fins d'entraînement ou d'évaluation et sont redimensionnées et normalisées pour correspondre aux dimensions des images traitées.
input_points (`NestedList`, *facultatif*) : Points d'entrée pour la segmentation basée sur des prompts. Doit être une liste imbriquée avec la structure `[image_level, object_level, point_level, [x, y]]` où chaque point est spécifié par des coordonnées `[x, y]` dans l'espace de l'image d'origine. Les points sont normalisés à la taille de l'image cible avant d'être transmis au modèle.
input_labels (`NestedList`, *facultatif*) : Étiquettes pour les points d'entrée, indiquant si chaque point est un point au premier plan (1) ou en arrière-plan (0). Doit être une liste imbriquée avec la structure `[image_level, object_level, point_level]`. Doit avoir la même structure que `input_points` (à l'exception de la dimension des coordonnées).
input_boxes (`NestedList`, *facultatif*) : Boîtes englobantes pour la segmentation basée sur des prompts. Doit être une liste imbriquée avec la structure `[image_level, box_level, [x1, y1, x2, y2]]` où chaque boîte est spécifiée par les coordonnées `[x1, y1, x2, y2]` dans l'espace de l'image d'origine. Les boîtes sont normalisées à la taille de l'image cible avant d'être transmises au modèle.
segmentation_maps (`ImageInput`, *kwargs*, *facultatif*) : Obsolète, passez directement en tant que `segmentation_maps` à [SamProcessor.__call__()](/docs/transformers/v5.23.0/fr/model_doc/sam#transformers.SamProcessor.__call__) à la place. Cartes de segmentation de référence à traiter avec les images d'entrée. Ces cartes sont utilisées à des fins d'entraînement ou d'évaluation et sont redimensionnées et normalisées pour correspondre aux dimensions de l'image traitée.
input_points (`NestedList`, *kwargs*, *facultatif*) : Déprécié, passez directement en tant que `input_points` à [SamProcessor.__call__()](/docs/transformers/v5.23.0/fr/model_doc/sam#transformers.SamProcessor.__call__) à la place. Points d'entrée pour la segmentation basée sur des prompts. Doit être une liste imbriquée avec la structure `[image_level, object_level, point_level, [x, y]]` où chaque point est spécifié par des coordonnées `[x, y]` dans l'espace de l'image d'origine. Les points sont normalisés à la taille de l'image cible avant d'être transmis au modèle.
input_labels (`NestedList`, *kwargs*, *facultatif*) : Obsolète, passez directement en tant que `input_labels` à [SamProcessor.__call__()](/docs/transformers/v5.23.0/fr/model_doc/sam#transformers.SamProcessor.__call__) à la place. Étiquettes pour les points d'entrée, indiquant si chaque point est un point au premier plan (1) ou en arrière-plan (0). Doit être une liste imbriquée avec la structure `[image_level, object_level, point_level]`. Doit avoir la même structure que `input_points` (à l'exception de la dimension des coordonnées).
input_boxes (`NestedList`, *kwargs*, *optionnel*) : Obsolète, passez directement en tant que `input_boxes` à [SamProcessor.__call__()](/docs/transformers/v5.23.0/fr/model_doc/sam#transformers.SamProcessor.__call__) à la place. Boîtes englobantes pour la segmentation basée sur des prompts. Doit être une liste imbriquée avec la structure `[image_level, box_level, [x1, y1, x2, y2]]` où chaque boîte est spécifiée par les coordonnées `[x1, y1, x2, y2]` dans l'espace de l'image d'origine. Les boîtes sont normalisées à la taille de l'image cible avant d'être transmises au modèle.
point_pad_value (`int`, *kwargs*, *facultatif*) : Obsolète, utilisez `SamProcessorKwargs.point_pad_value` à la place. La valeur utilisée pour rembourdir les points d'entrée lors du groupement de séquences de longueurs différentes. Cette valeur marque les positions rembourdies et est conservée lors de la normalisation des coordonnées afin de distinguer les points réels du rembourdissage.
mask_size (`dict[str, *kwargs*, int]`, *facultatif*) : Dictionnaire spécifiant la taille de la cible du masque, avec les clés `"height"` et `"width"`. Cela détermine la résolution des masques de segmentation de sortie générés par le modèle.
mask_pad_size (`dict[str, *kwargs*, int]`, *facultatif*) : Dictionnaire spécifiant la taille de bourrage pour les masques, avec les clés `"height"` et `"width"`. Il est utilisé lors du regroupement de masques de tailles différentes afin de garantir des dimensions cohérentes.
return_mm_token_type_ids (`bool`, *kwargs*) : Indique s'il faut retourner les identifiants de type de jeton multimodal indiquant les positions des jetons de substitution multimodaux.
return_text_replacement_offsets (`bool`, *kwargs*) : Indique s'il faut retourner les décalages de caractères pour chaque emplacement multimodal et son remplacement.
point_pad_value (`int`, *kwargs*, *facultatif*, valeur par défaut `-10`) : La valeur utilisée pour rembour les points d'entrée lors du groupement de séquences de longueurs différentes. Cette valeur marque les positions rembourdies et est conservée lors de la normalisation des coordonnées afin de distinguer les points réels du rembourrage.
return_tensors (`str` ou [TensorType](/docs/transformers/v5.23.0/fr/internal/file_utils#transformers.TensorType), *facultatif*) : Si défini, renverra des tenseurs d'un framework particulier. Les valeurs acceptables sont : - `'pt'` : Renvoie des objets `torch.Tensor` de PyTorch. - `'np'` : Renvoie des objets `np.ndarray` de NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/v5.23.0/fr/main_classes/processors#transformers.ProcessingKwargs), *facultatif*) : Options de traitement supplémentaires pour chaque modalité (texte, images, vidéos, audio). Les paramètres spécifiques au modèle sont répertoriés ci-dessus ; consultez la classe TypedDict pour la liste complète des arguments pris en charge.
**Retourne :** `~tokenization_utils_base.BatchEncoding`
- **data** (`dict`, *facultatif*) -- Dictionnaire de listes/tableaux/tenseurs renvoyé par les méthodes `__call__`/`encode_plus`/`batch_encode_plus` ('input_ids', 'attention_mask', etc.).
- **encodage** (`tokenizers.Encoding` ou `Sequence[tokenizers.Encoding]`, *facultatif*) -- Si le tokenizer est un fast tokenizer qui fournit des informations supplémentaires, telles que la correspondance entre l'espace des mots/caractères et l'espace des jetons, l'instance `tokenizers.Encoding` ou la liste d'instances (pour les lots) contient ces informations.
- **tensor_type** (`Union[None, str, TensorType]`, *facultatif*) -- Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
- **prepend_batch_axis** (`bool`, *facultatif*, par défaut `False`) -- Indique s'il faut ajouter un axe de lot lors de la conversion en tenseurs (voir `tensor_type` ci-dessus). Notez que ce paramètre n'a un effet que si le paramètre `tensor_type` est défini, *sinon il n'a aucun effet*.
- **n_sequences** (`int`, *facultatif*) -- Le nombre de séquences d'entrée représentées par chaque encodage (`None` pour inconnu, `1` pour une séquence unique et `2` pour une paire de séquences).
## SamImageProcessor[[transformers.SamImageProcessor]]
#### transformers.SamImageProcessor[[transformers.SamImageProcessor]]
```python
transformers.SamImageProcessor(**kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/image_processing_sam.py#L61)
**Paramètres :**
do_convert_rgb (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'longest_edge' : 1024}`) : Décris les dimensions d'entrée maximales pour le modèle.
default_to_square (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut par défaut redimensionner l'image en un carré si la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, par défaut `2`) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*, valeur par défaut `0.00392156862745098`) : Facteur de remise à l'échelle appliqué à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.485, 0.456, 0.406]`) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.229, 0.224, 0.225]`) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'height' : 1024, 'width': 1024}`) : la taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
mask_size (`dict[str, *kwargs*, int]`, *facultatif*) : La taille `{"longest_edge": int}` à laquelle redimensionner les cartes de segmentation.
mask_pad_size (`dict[str, *kwargs*, int]`, *facultatif*) : La taille `{"height": int, "width": int}` à laquelle rembourrer les cartes de segmentation. Elle doit être supérieure à la taille de toute carte de segmentation fournie pour le prétraitement.
Construit un processeur d’images SamImageProcessor.
#### prétraiter[[transformers.SamImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/image_processing_sam.py#L79)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
segmentation_maps (`ImageInput`, *facultatif*) : Les cartes de segmentation à prétraiter.
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*) : Indique s'il faut par défaut redimensionner l'image en un carré lorsque la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*) : Facteur de redimensionnement à appliquer à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
mask_size (`dict[str, *kwargs*, int]`, *facultatif*) : La taille `{"longest_edge": int}` à laquelle redimensionner les cartes de segmentation.
mask_pad_size (`dict[str, *kwargs*, int]`, *facultatif*) : La taille `{"height": int, "width": int}` à laquelle rembourrer les cartes de segmentation. Elle doit être supérieure à la taille de toute carte de segmentation fournie pour le prétraitement.
**Retourne :** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode __call__ (« pixel_values », etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *facultatif*) -- Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
## SamImageProcessorPil[[transformers.SamImageProcessorPil]]
#### transformers.SamImageProcessorPil[[transformers.SamImageProcessorPil]]
```python
transformers.SamImageProcessorPil(**kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/image_processing_pil_sam.py#L82)
**Paramètres :**
do_convert_rgb (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'longest_edge' : 1024}`) : Décris les dimensions d'entrée maximales pour le modèle.
default_to_square (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut par défaut redimensionner l'image en un carré si la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, par défaut `2`) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*, valeur par défaut `0.00392156862745098`) : Facteur de remise à l'échelle appliqué à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.485, 0.456, 0.406]`) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.229, 0.224, 0.225]`) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'height' : 1024, 'width': 1024}`) : la taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
mask_size (`dict[str, *kwargs*, int]`, *facultatif*) : La taille `{"longest_edge": int}` à laquelle redimensionner les cartes de segmentation.
mask_pad_size (`dict[str, *kwargs*, int]`, *facultatif*) : La taille `{"height": int, "width": int}` à laquelle rembourrer les cartes de segmentation. Elle doit être supérieure à la taille de toute carte de segmentation fournie pour le prétraitement.
Construit un processeur d’images SamImageProcessor.
#### prétraiter[[transformers.SamImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/image_processing_pil_sam.py#L100)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
segmentation_maps (`ImageInput`, *facultatif*) : Les cartes de segmentation à prétraiter.
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*) : Indique s'il faut par défaut redimensionner l'image en un carré lorsque la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*) : Facteur de redimensionnement à appliquer à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
mask_size (`dict[str, *kwargs*, int]`, *facultatif*) : La taille `{"longest_edge": int}` à laquelle redimensionner les cartes de segmentation.
mask_pad_size (`dict[str, *kwargs*, int]`, *facultatif*) : La taille `{"height": int, "width": int}` à laquelle rembourrer les cartes de segmentation. Elle doit être supérieure à la taille de toute carte de segmentation fournie pour le prétraitement.
**Retourne :** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode __call__ (« pixel_values », etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *facultatif*) -- Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
## SamVisionModel[[transformers.SamVisionModel]]
#### transformers.SamVisionModel[[transformers.SamVisionModel]]
```python
transformers.SamVisionModel(config: SamVisionConfig)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/modeling_sam.py#L1081)
**Paramètres :**
config ([SamVisionConfig](/docs/transformers/v5.23.0/fr/model_doc/sam#transformers.SamVisionConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L’initialisation à partir d’un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/v5.23.0/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Le modèle de vision de Sam, sans aucune tête ni projection au sommet.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/v5.23.0/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.SamVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/modeling_sam.py#L1093)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d’entrée. Les valeurs de pixels peuvent être obtenues à l’aide de [SamImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/sam#transformers.SamImageProcessor). Voir [SamImageProcessor.__call__()](/docs/transformers/v5.23.0/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails ([SamProcessor](/docs/transformers/v5.23.0/fr/model_doc/sam#transformers.SamProcessor) utilise [SamImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/sam#transformers.SamImageProcessor) pour le traitement des images).
**Retourne :** `SamVisionEncoderOutput` ou `tuple(torch.Tensor)`
Un `SamVisionEncoderOutput` ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([SamConfig](/docs/transformers/v5.23.0/fr/model_doc/sam#transformers.SamConfig)) et les entrées.
La méthode forward de [SamVisionModel](/docs/transformers/v5.23.0/fr/model_doc/sam#transformers.SamVisionModel) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **image_embeds** (`torch.Tensor` de forme `(batch_size, output_dim)` *facultatif* renvoyé lorsque le modèle est initialisé avec `with_projection=True`) -- Les embeddings d'image obtenus en appliquant la couche de projection au pooler_output.
- **last_hidden_state** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`, *facultatif*) -- Séquence d'états cachés à la sortie de la dernière couche du modèle.
- **hidden_states** (`tuple[torch.Tensor, ...]`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d'embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple[torch.Tensor, ...]`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
## SamModel[[transformers.SamModel]]
#### transformers.SamModel[[transformers.SamModel]]
```python
transformers.SamModel(config: SamConfig)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/modeling_sam.py#L1108)
**Paramètres :**
config ([SamConfig](/docs/transformers/v5.23.0/fr/model_doc/sam#transformers.SamConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/v5.23.0/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Segment Anything Model (SAM) pour générer des masques de segmentation, à partir d'une image d'entrée et de points et d'étiquettes, de boîtes ou de masques en entrée.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/v5.23.0/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.SamModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, input_points: typing.Optional[torch.Tensor] = None, input_labels: typing.Optional[torch.LongTensor] = None, input_boxes: typing.Optional[torch.Tensor] = None, input_masks: typing.Optional[torch.LongTensor] = None, image_embeddings: typing.Optional[torch.Tensor] = None, multimask_output: bool = True, attention_similarity: typing.Optional[torch.Tensor] = None, target_embedding: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/sam/modeling_sam.py#L1191)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d’entrée. Les valeurs de pixels peuvent être obtenues à l’aide de [SamImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/sam#transformers.SamImageProcessor). Voir [SamImageProcessor.__call__()](/docs/transformers/v5.23.0/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails ([SamProcessor](/docs/transformers/v5.23.0/fr/model_doc/sam#transformers.SamProcessor) utilise [SamImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/sam#transformers.SamImageProcessor) pour le traitement des images).
input_points (`torch.Tensor` de forme `(batch_size, num_points, 2)`) : Points spatiaux 2D en entrée, utilisés par l'encodeur de prompt pour encoder le prompt. Produit généralement des résultats nettement meilleurs. Les points peuvent être obtenus en transmettant une liste de listes de listes au processeur, qui créera les tenseurs `torch` correspondants de dimension 4. La première dimension correspond à la taille du lot d'images, la deuxième à la taille du lot de points (c'est-à-dire le nombre de masques de segmentation que le modèle doit prédire par point d'entrée), la troisième au nombre de points par masque de segmentation (il est possible de transmettre plusieurs points pour un seul masque), et la dernière aux coordonnées x (verticale) et y (horizontale) du point. Si un nombre différent de points est transmis pour chaque image ou pour chaque masque, le processeur créera des points « PAD » correspondant à la coordonnée (0, 0), et le calcul de l'embedding sera ignoré pour ces points à l'aide des étiquettes.
input_labels (`torch.LongTensor` de forme `(batch_size, point_batch_size, num_points)`) : Étiquettes d'entrée pour les points, utilisées par l'encodeur de prompt pour encoder le prompt. Selon l'implémentation officielle, il existe 3 types d'étiquettes : `1` : le point contient l'objet d'intérêt ; `0` : le point ne contient pas l'objet d'intérêt ; `-1` : le point correspond à l'arrière-plan. Nous avons ajouté l'étiquette : `-10` : le point est un point de bourrage (padding) et doit donc être ignoré par l'encodeur de prompt. Les étiquettes de bourrage doivent être gérées automatiquement par le processeur.
input_boxes (`torch.Tensor` de forme `(batch_size, num_boxes, 4)`) : Boîtes d'entrée pour les points, utilisées par l'encodeur de prompt pour encoder le prompt. Produit généralement des masques générés nettement meilleurs. Les boîtes peuvent être obtenues en transmettant une liste de listes de listes au processeur, qui générera un tenseur `torch`, chaque dimension correspondant respectivement à la taille du lot d'images, au nombre de boîtes par image et aux coordonnées du point en haut à gauche et du point en bas à droite de la boîte. Dans l'ordre (`x1`, `y1`, `x2`, `y2`) : - `x1` : la coordonnée x du point en haut à gauche de la boîte d'entrée - `y1` : la coordonnée y du point en haut à gauche de la boîte d'entrée - `x2` : la coordonnée x du point en bas à droite de la boîte d'entrée - `y2` : la coordonnée y du point en bas à droite de la boîte d'entrée
input_masks (`torch.Tensor` de forme `(batch_size, image_size, image_size)`) : le modèle SAM accepte également des masques de segmentation en entrée. Le masque sera intégré par l’encodeur de prompt pour générer un embedding correspondant, qui sera ensuite transmis au décodeur de masque. Ces masques doivent être fournis manuellement par l’utilisateur et doivent être de forme (`batch_size`, `image_size`, `image_size`).
image_embeddings (`torch.Tensor` de forme `(batch_size, output_channels, window_size, window_size)`) : embeddings d’image, utilisés par le décodeur de masque pour générer les masques et les scores iou. Pour un calcul plus efficace en mémoire, les utilisateurs peuvent d’abord récupérer les embeddings d’image à l’aide de la méthode `get_image_embeddings`, puis les transmettre à la méthode `forward` au lieu de transmettre les `pixel_values`.
multimask_output (`bool`, *facultatif*) : Dans l’implémentation et l’article originaux, le modèle produit toujours 3 masques par image (ou par point / par boîte englobante le cas échéant). Il est toutefois possible de n’en produire qu’un seul, correspondant au masque « optimal », en spécifiant `multimask_output=False`.
attention_similarity (`torch.Tensor`, *facultatif*) : Tenseur de similarité d'attention, à fournir au décodeur de masque pour une attention guidée par la cible lorsque le modèle est utilisé pour la personnalisation, comme introduit dans [PerSAM](https://huggingface.co/papers/2305.03048).
target_embedding (`torch.Tensor`, *facultatif*) : Embedding du concept cible, à fournir au décodeur de masque pour le prompting sémantique de la cible dans le cas où le modèle est utilisé pour la personnalisation, comme introduit dans [PerSAM](https://huggingface.co/papers/2305.03048).
**Retourne :** `SamImageSegmentationOutput` ou `tuple(torch.Tensor)`
Un `SamImageSegmentationOutput` ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([SamConfig](/docs/transformers/v5.23.0/fr/model_doc/sam#transformers.SamConfig)) et les entrées.
La méthode forward de [SamModel](/docs/transformers/v5.23.0/fr/model_doc/sam#transformers.SamModel) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **iou_scores** (`torch.Tensor` de forme `(batch_size, num_masks)`) -- Les scores iou des masques prédits.
- **pred_masks** (`torch.Tensor` de forme `(batch_size, num_masks, height, width)`) -- Les masques de basse résolution prédits. Doivent être post-traités par le processeur
- **vision_hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d'embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle de vision à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **vision_attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
- **mask_decoder_attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemple :
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoModel, AutoProcessor
>>> model = AutoModel.from_pretrained("facebook/sam-vit-base")
>>> processor = AutoProcessor.from_pretrained("facebook/sam-vit-base")
>>> url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/transformers/model_doc/sam-car.png"
>>> with httpx.stream("GET", url) as response:
... raw_image = Image.open(BytesIO(response.read())).convert("RGB")
>>> input_points = [[[400, 650]]] # 2D location of a window on the car
>>> inputs = processor(images=raw_image, input_points=input_points, return_tensors="pt")
>>> # Get segmentation mask
>>> outputs = model(**inputs)
>>> # Postprocess masks
>>> masks = processor.post_process_masks(
... outputs.pred_masks, inputs["original_sizes"], inputs["reshaped_input_sizes"]
... )
```