# Grounding DINO
## 개요
Grounding DINO 모델은 Shilong Liu, Zhaoyang Zeng, Tianhe Ren, Feng Li, Hao Zhang, Jie Yang, Chunyuan Li, Jianwei Yang, Hang Su, Jun Zhu, Lei Zhang가 [Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection](https://huggingface.co/papers/2303.05499)에서 제안했습니다. Grounding DINO는 텍스트 인코더를 추가하여 폐쇄 집합 객체 탐지 모델을 확장함으로써 오픈 세트 객체 탐지를 가능하게 합니다. 이 모델은 COCO zero-shot에서 52.5 AP와 같은 뛰어난 결과를 달성합니다.
해당 논문의 초록은 다음과 같습니다:
*본 논문에서는 Transformer 기반의 객체 탐지 모델인 DINO에 지향적 사전 학습(grounded pre-training)을 결합하여, 카테고리 이름이나 지칭 표현과 같은 인간의 입력으로 임의의 객체를 탐지할 수 있는 오픈셋 객체 탐지 모델인 Grounding DINO를 제안합니다. 오픈셋 객체 탐지의 핵심 해결책은 오픈셋 개념 일반화를 위해 클로즈드셋 탐지기에 언어를 도입하는 것입니다. 언어와 비전 모달리티를 효과적으로 융합하기 위해, 클로즈드셋 탐지기를 개념적으로 세 단계로 나누고, 특징 강화기(feature enhancer), 언어 기반 쿼리 선택(language-guided query selection), 그리고 크로스 모달리티 융합을 위한 크로스 모달리티 디코더(cross-modality decoder)를 포함하는 긴밀한 융합(tight fusion) 솔루션을 제안합니다. 이전 연구들이 주로 새로운 카테고리에서 오픈셋 객체 탐지를 평가한 반면, 우리는 속성으로 지정된 객체에 대한 지칭 표현 이해(refering expression comprehension)에 대해서도 평가를 수행할 것을 제안합니다. Grounding DINO는 COCO, LVIS, ODinW, RefCOCO/+/g 벤치마크를 포함한 세 가지 설정 모두에서 뛰어난 성능을 보입니다. Grounding DINO는 COCO 탐지 제로샷 전이(transfer) 벤치마크에서 52.5 AP를 달성했으며, 이는 COCO의 학습 데이터를 전혀 사용하지 않은 상태입니다. 또한 ODinW 제로샷 벤치마크에서 평균 26.1 AP로 새로운 기록을 세웠습니다.*
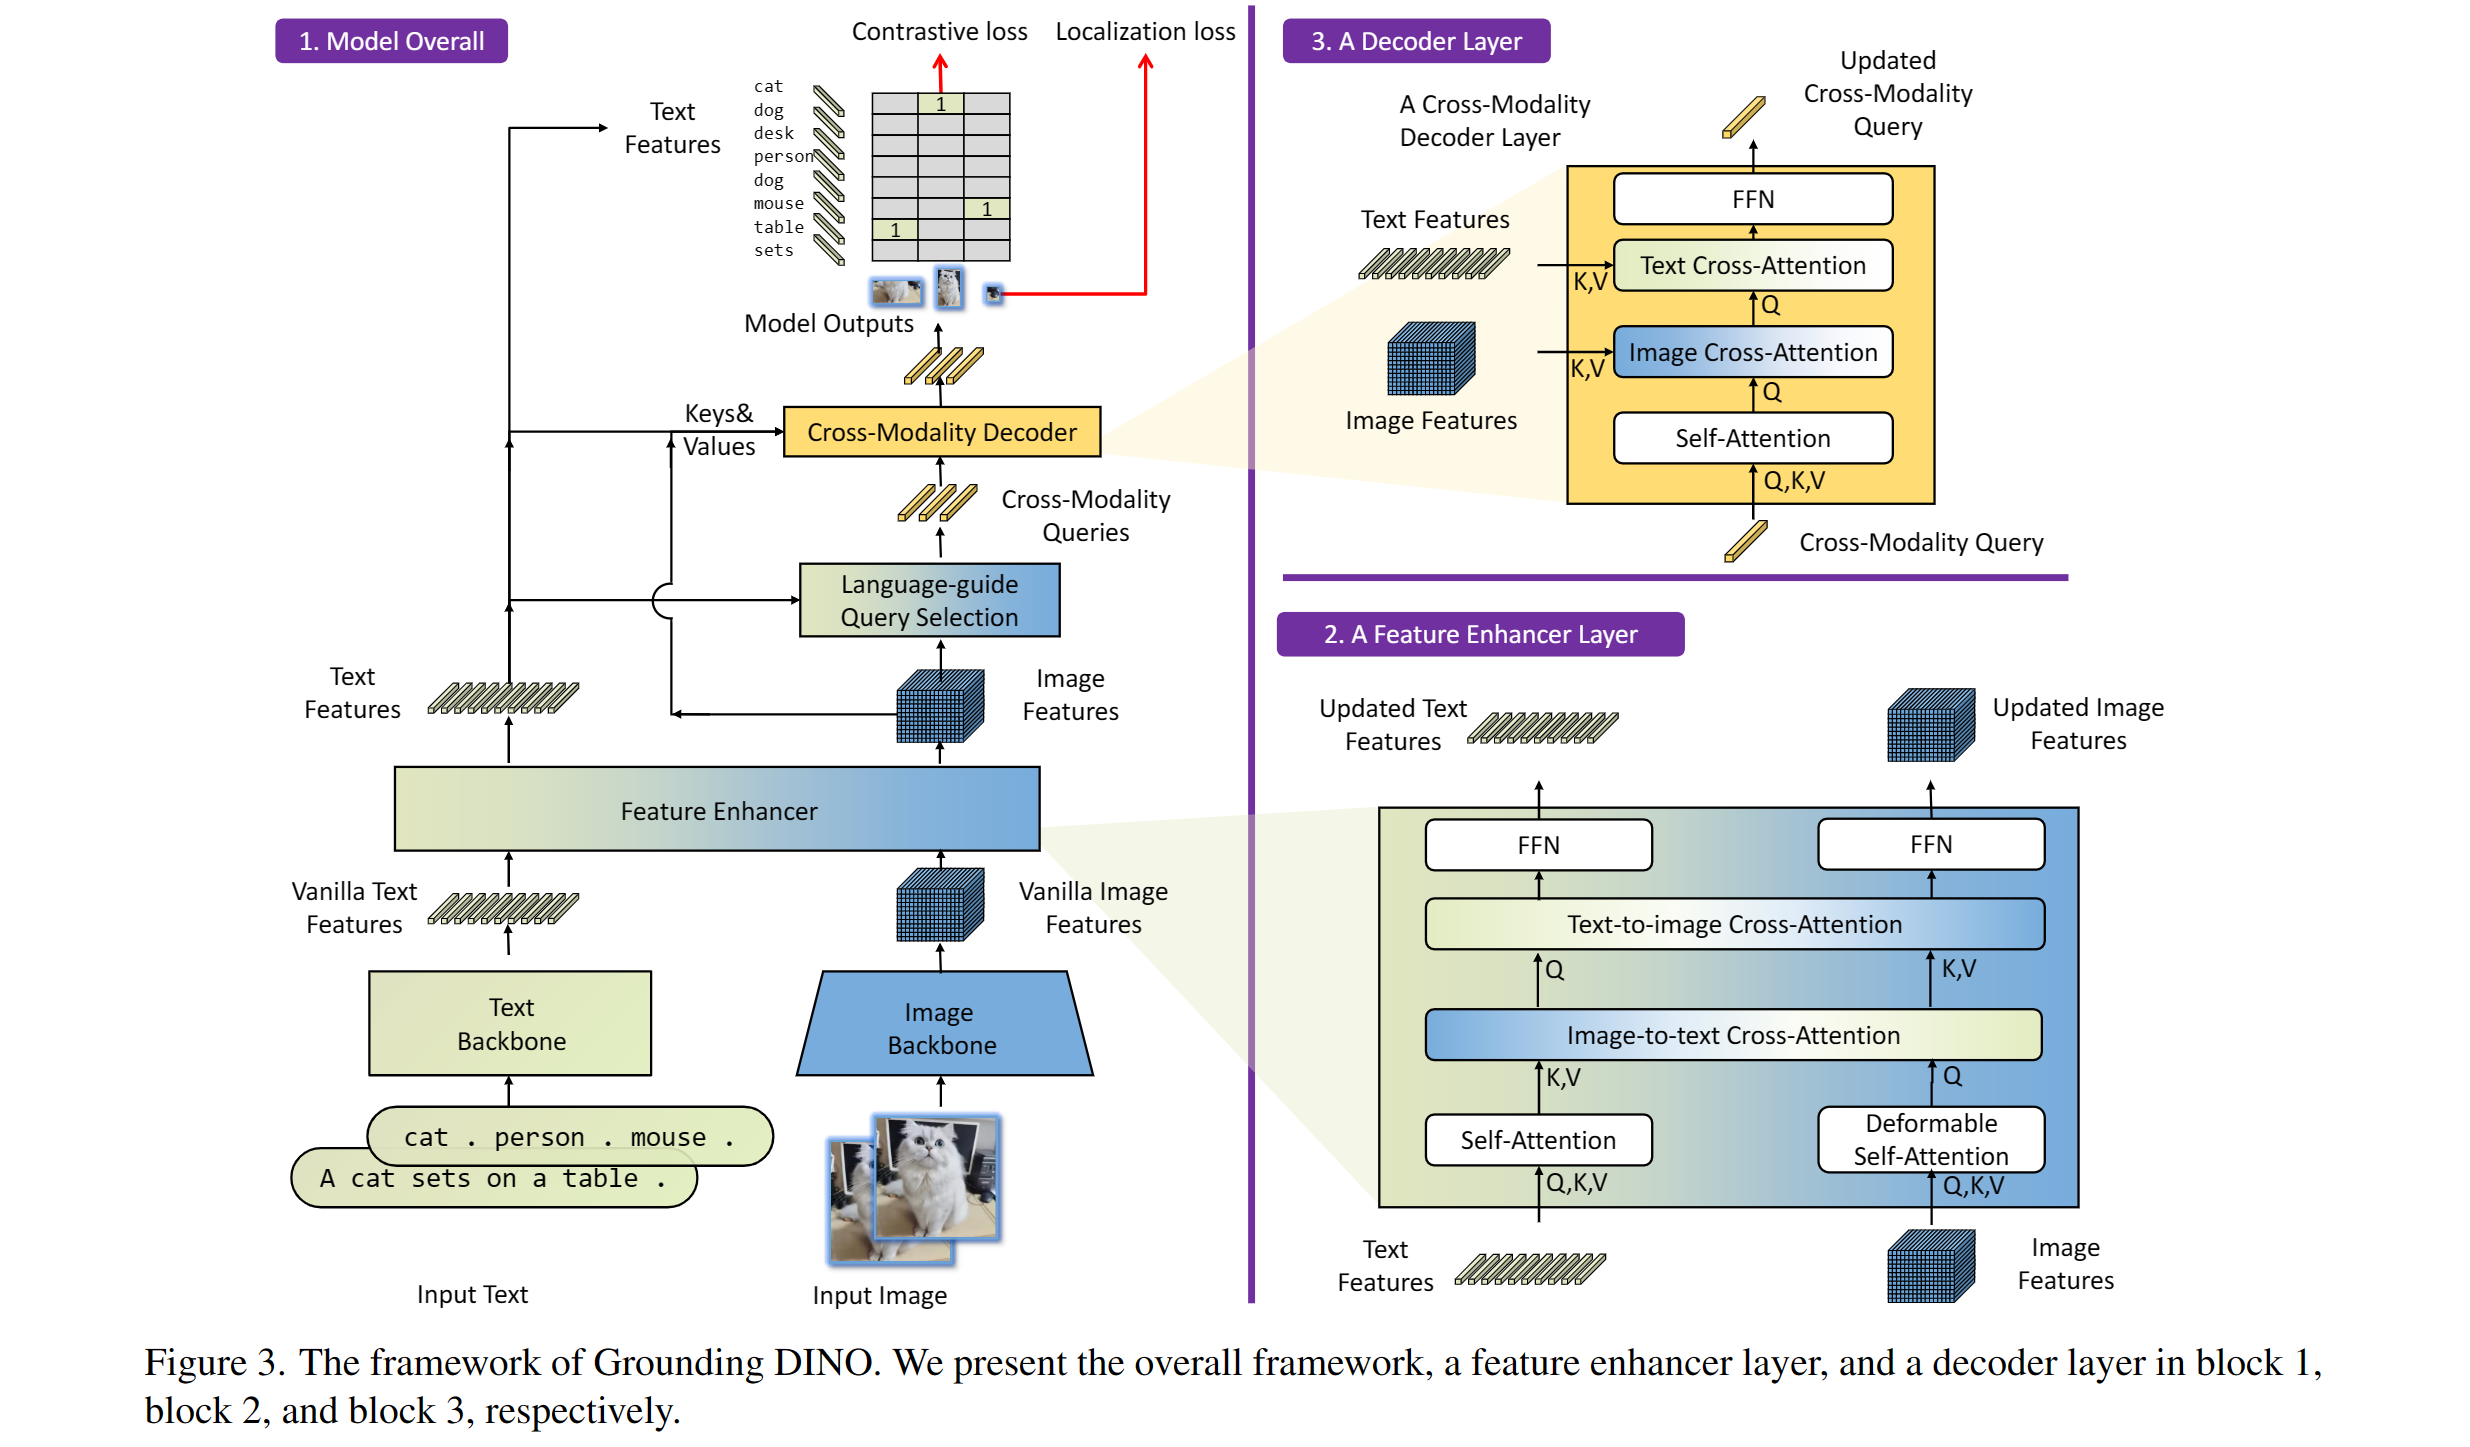 Grounding DINO 개요. 원 논문에서 가져왔습니다.
이 모델은 [EduardoPacheco](https://huggingface.co/EduardoPacheco)와 [nielsr](https://huggingface.co/nielsr)가 기여했습니다. 원본 코드는 [여기](https://github.com/IDEA-Research/GroundingDINO)에서 찾을 수 있습니다.
## 사용 팁
- [GroundingDinoProcessor](/docs/transformers/v5.23.0/ko/model_doc/grounding-dino#transformers.GroundingDinoProcessor)를 사용하여 모델에 사용할 이미지-텍스트 쌍을 준비할 수 있습니다.
- 텍스트에서 클래스를 구분하려면 마침표를 사용하세요. 예: "a cat. a dog."
- 여러 클래스를 사용하는 경우(예: `"a cat. a dog."`), [GroundingDinoProcessor](/docs/transformers/v5.23.0/ko/model_doc/grounding-dino#transformers.GroundingDinoProcessor)의 `post_process_grounded_object_detection`를 사용하여 출력을 후처리하세요. `post_process_object_detection`에서 반환되는 라벨은 prob > threshold인 모델 차원의 인덱스를 나타내기 때문입니다.
…
```python
import requests
import torch
from PIL import Image
from transformers import AutoProcessor, AutoModelForZeroShotObjectDetection
model_id = "IDEA-Research/grounding-dino-tiny"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForZeroShotObjectDetection.from_pretrained(model_id, device_map="auto")
image_url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(image_url, stream=True).raw)
# Check for cats and remote controls
text_labels = [["a cat", "a remote control"]]
inputs = processor(images=image, text=text_labels, return_tensors="pt").to(model.device)
with torch.no_grad():
outputs = model(**inputs)
results = processor.post_process_grounded_object_detection(
outputs,
inputs.input_ids,
threshold=0.4,
text_threshold=0.3,
target_sizes=[image.size[::-1]]
)
# Retrieve the first image result
result = results[0]
for box, score, labels in zip(result["boxes"], result["scores"], result["labels"]):
box = [round(x, 2) for x in box.tolist()]
print(f"Detected {labels} with confidence {round(score.item(), 3)} at location {box}")
Detected a cat with confidence 0.468 at location [344.78, 22.9, 637.3, 373.62]
Detected a cat with confidence 0.426 at location [11.74, 51.55, 316.51, 473.22]
```
## Grounded SAM
Grounding DINO를 [Segment Anything](sam) 모델과 결합하여 [Grounded SAM: Assembling Open-World Models for Diverse Visual Tasks](https://huggingface.co/papers/2401.14159)에서 소개된 텍스트 기반 마스크 생성을 수행할 수 있습니다. 자세한 내용은 이 [데모 노트북](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/Grounding%20DINO/GroundingDINO_with_Segment_Anything.ipynb) 🌍을 참고하세요.
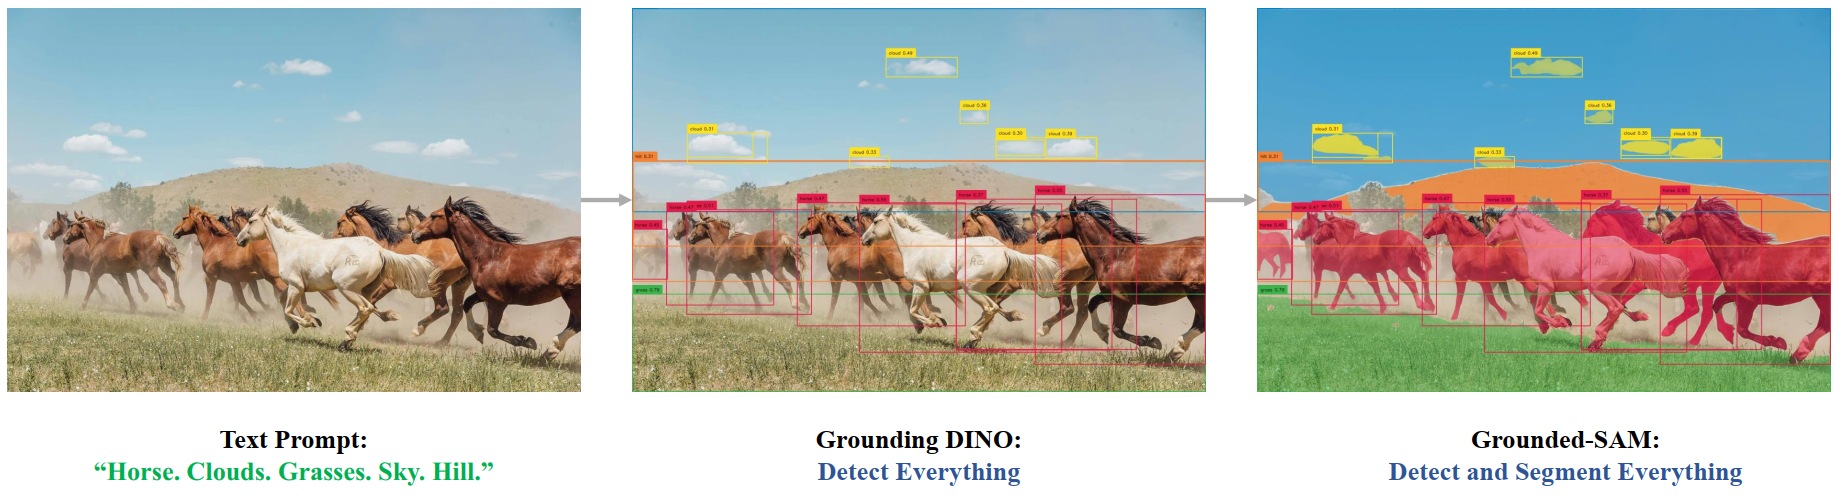 Grounded SAM 개요. 원본 저장소에서 가져왔습니다.
## 리소스
Grounding DINO를 시작하는 데 도움이 되는 공식 Hugging Face 및 커뮤니티(🌎로 표시) 리소스 목록입니다. 여기에 포함할 리소스를 제출하고 싶으시면 Pull Request를 열어 주시면 검토하겠습니다! 리소스는 기존 리소스와 중복되는 것 대신에 새로운 것을 시연하는 것이 이상적입니다.
- Grounding DINO를 활용한 추론 및 [SAM](sam)과의 결합에 대한 데모 노트북은 [여기](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Grounding%20DINO)에서 확인할 수 있습니다. 🌎
## GroundingDinoImageProcessor[[transformers.GroundingDinoImageProcessor]]
#### transformers.GroundingDinoImageProcessor[[transformers.GroundingDinoImageProcessor]]
```python
transformers.GroundingDinoImageProcessor(**kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/grounding_dino/image_processing_grounding_dino.py#L308)
**매개변수:**
do_convert_rgb (`bool`, *kwargs*, *선택*) : 이미지를 RGB로 변환할지 여부.
do_resize (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 리사이즈할지 여부.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, 기본값 `{'shortest_edge' : 800, 'longest_edge': 1333}`): 모델에 입력되는 최대 차원을 설명합니다.
default_to_square (`bool`, *kwargs*, *선택 사항*, 기본값 `False`) : size가 int인 경우 리사이즈 시 정사각형 이미지로 설정할지 여부.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop`를 적용한 후의 출력 이미지 크기.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, 기본값 `2`) : 이미지를 리사이즈할 때 사용할 리샘플링 필터입니다. 이는 `PILImageResampling` enum 중 하나일 수 있습니다. `do_resize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_rescale (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 다시 스케일링할지 여부.
rescale_factor (`float`, *kwargs*, *선택 사항*, 기본값 `0.00392156862745098`) : `do_rescale`이 `True`로 설정된 경우 이미지를 재조정하는 데 사용되는 재조정 계수입니다.
do_normalize (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 정규화할지 여부.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택 사항*, 기본값은 `[0.485, 0.456, 0.406]`) : 정규화에 사용할 이미지 평균입니다. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택 사항*, 기본값은 `[0.229, 0.224, 0.225]`) : 정규화에 사용할 이미지 표준 편차입니다. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_pad (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 패딩할지 여부입니다. 패딩은 배치 내 가장 큰 크기로 수행하거나 이미지마다 고정된 정사각형 크기로 수행합니다. 정확한 패딩 전략은 모델에 따라 달라집니다.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 이미지를 패딩할 `{"height": int, "width" int}` 크기를 지정합니다. 전처리용으로 제공된 모든 이미지 크기보다 커야 합니다. `pad_size`가 제공되지 않으면, 이미지는 배치 내 가장 큰 높이와 너비로 패딩됩니다. `do_pad=True.`일 때만 적용됩니다.
do_center_crop (`bool`, *kwargs*, *선택*) : 이미지를 중앙 크롭할지 여부.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : `ChannelDimension.FIRST`만 지원됩니다. 느린 프로세서와의 호환성을 위해 추가되었습니다.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : 입력 이미지의 채널 차원 형식입니다. 설정하지 않으면 입력 이미지에서 채널 차원 형식을 추론합니다. 다음 중 하나일 수 있습니다: - `"channels_first"` 또는 `ChannelDimension.FIRST`: (num_channels, height, width) 형식의 이미지. - `"channels_last"` 또는 `ChannelDimension.LAST`: (height, width, num_channels) 형식의 이미지. - `"none"` 또는 `ChannelDimension.NONE`: (height, width) 형식의 이미지.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 비디오를 처리할 장치입니다. 설정되지 않은 경우, 입력 비디오에서 장치를 추론합니다.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`로 설정된 경우 스택된 텐서를 반환하고, 그렇지 않으면 텐서 목록을 반환합니다.
disable_grouping (`bool`, *kwargs*, *선택*) : 이미지의 크기에 따른 그룹화를 비활성화하여 이미지를 배치 대신 개별적으로 처리할지 여부입니다. None인 경우, 이미지가 CPU에 있으면 True, 그렇지 않으면 False로 설정됩니다. 이 선택은 https://github.com/huggingface/transformers/pull/38157에 자세히 설명된 경험적 관찰에 기반합니다.
image_seq_length (`int`, *kwargs*, *선택*) : 입력의 각 이미지에 사용할 이미지 토큰의 수입니다. 하위 호환성을 위해 추가되었지만, 향후 모델에서는 프로세서 속성으로 설정해야 합니다.
format (`str`, *kwargs*, *선택 사항*, 기본값은 `AnnotationFormat.COCO_DETECTION`) : 어노테이션의 데이터 형식. "coco_detection" 또는 "coco_panoptic" 중 하나입니다.
do_convert_annotations (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : GROUNDING_DINO 모델이 기대하는 형식으로 어노테이션을 변환할지 여부를 제어합니다. 바운딩 박스를 `(center_x, center_y, width, height)` 형식으로 변환하고 범위를 `[0, 1]`로 설정합니다. `preprocess` 메서드의 `do_convert_annotations` 매개변수로 재정의할 수 있습니다.
GroundingDinoImageProcessor 이미지 프로세서를 생성합니다.
#### preprocess[[transformers.GroundingDinoImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = None, return_segmentation_masks: bool | None = None, masks_path: str | pathlib.Path | None = None, **kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/grounding_dino/image_processing_grounding_dino.py#L563)
**매개변수:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : 전처리할 이미지. 픽셀 값이 0에서 255 범위로 이루어진 단일 이미지 또는 배치 이미지를 기대합니다. 픽셀 값이 0에서 1 범위로 이루어진 이미지를 전달하는 경우 `do_rescale=False`로 설정하세요.
annotations (`AnnotationType` 또는 `list[AnnotationType]`, *선택 사항*) : 이미지에 적용되는 패딩에 따라 변환할 어노테이션입니다.
return_segmentation_masks (`bool`, *선택 사항*, 기본값 `self.return_segmentation_masks`) : 분할 마스크를 반환할지 여부.
masks_path (`str` 또는 `pathlib.Path`, *선택 사항*) : 분할 마스크를 포함하는 디렉터리의 경로.
do_convert_rgb (`bool`, *kwargs*, *선택*) : 이미지를 RGB로 변환할지 여부.
do_resize (`bool`, *kwargs*, *선택*) : 이미지를 리사이즈할지 여부.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 모델의 최대 입력 차원을 설명합니다.
default_to_square (`bool`, *kwargs*, *선택*) : size가 int인 경우 리사이즈 시 정사각형 이미지로 기본 설정할지 여부.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop`를 적용한 후의 출력 이미지 크기.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : 이미지를 리사이즈할 때 사용할 리샘플링 필터입니다. `PILImageResampling` enum 중 하나를 사용할 수 있습니다. `do_resize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_rescale (`bool`, *kwargs*, *선택*) : 이미지를 다시 스케일링할지 여부.
rescale_factor (`float`, *kwargs*, *선택*) : `do_rescale`가 `True`로 설정된 경우 이미지를 재조정하는 데 사용되는 재조정 계수입니다.
do_normalize (`bool`, *kwargs*, *선택*) : 이미지를 정규화할지 여부.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택*) : 정규화에 사용할 이미지 평균값. `do_normalize`이 `True`로 설정된 경우에만 효과가 있습니다.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택*) : 정규화에 사용할 이미지 표준 편차. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_pad (`bool`, *kwargs*, *선택*) : 이미지를 패딩할지 여부입니다. 패딩은 배치 내 가장 큰 크기로 수행하거나, 이미지마다 고정된 정사각형 크기로 수행합니다. 정확한 패딩 전략은 모델에 따라 달라집니다.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 이미지를 패딩할 `{"height": int, "width" int}` 크기를 지정합니다. 전처리용으로 제공된 모든 이미지 크기보다 커야 합니다. `pad_size`가 제공되지 않으면, 이미지는 배치 내 가장 큰 높이와 너비로 패딩됩니다. `do_pad=True.`일 때만 적용됩니다.
do_center_crop (`bool`, *kwargs*, *선택*) : 이미지를 중앙 크롭할지 여부.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : `ChannelDimension.FIRST`만 지원됩니다. 느린 프로세서와의 호환성을 위해 추가되었습니다.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : 입력 이미지의 채널 차원 형식입니다. 설정하지 않으면 입력 이미지에서 채널 차원 형식을 추론합니다. 다음 중 하나일 수 있습니다: - `"channels_first"` 또는 `ChannelDimension.FIRST`: (num_channels, height, width) 형식의 이미지. - `"channels_last"` 또는 `ChannelDimension.LAST`: (height, width, num_channels) 형식의 이미지. - `"none"` 또는 `ChannelDimension.NONE`: (height, width) 형식의 이미지.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 비디오를 처리할 장치입니다. 설정되지 않은 경우, 입력 비디오에서 장치를 추론합니다.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`로 설정된 경우 스택된 텐서를 반환하고, 그렇지 않으면 텐서 목록을 반환합니다.
disable_grouping (`bool`, *kwargs*, *선택*) : 이미지의 크기에 따른 그룹화를 비활성화하여 이미지를 배치 대신 개별적으로 처리할지 여부입니다. None인 경우, 이미지가 CPU에 있으면 True, 그렇지 않으면 False로 설정됩니다. 이 선택은 https://github.com/huggingface/transformers/pull/38157에 자세히 설명된 경험적 관찰에 기반합니다.
image_seq_length (`int`, *kwargs*, *선택*) : 입력의 각 이미지에 사용할 이미지 토큰의 수입니다. 하위 호환성을 위해 추가되었지만, 향후 모델에서는 프로세서 속성으로 설정해야 합니다.
format (`str`, *kwargs*, *선택 사항*, 기본값은 `AnnotationFormat.COCO_DETECTION`) : 어노테이션의 데이터 형식. "coco_detection" 또는 "coco_panoptic" 중 하나입니다.
do_convert_annotations (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : GROUNDING_DINO 모델이 기대하는 형식으로 어노테이션을 변환할지 여부를 제어합니다. 바운딩 박스를 `(center_x, center_y, width, height)` 형식으로 변환하고 범위를 `[0, 1]`로 설정합니다. `preprocess` 메서드의 `do_convert_annotations` 매개변수로 재정의할 수 있습니다.
**반환값:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ 메서드가 반환하는 리스트/배열/텐서 딕셔너리('pixel_values' 등).
- **tensor_type** (`Union[None, str, TensorType]`, *선택 사항*) -- 초기화 시 PyTorch/Numpy 텐서에서 정수 목록을 변환하려면 여기에 tensor_type을 지정할 수 있습니다.
## GroundingDinoImageProcessorPil[[transformers.GroundingDinoImageProcessorPil]]
#### transformers.GroundingDinoImageProcessorPil[[transformers.GroundingDinoImageProcessorPil]]
```python
transformers.GroundingDinoImageProcessorPil(**kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/grounding_dino/image_processing_pil_grounding_dino.py#L300)
**매개변수:**
do_convert_rgb (`bool`, *kwargs*, *선택*) : 이미지를 RGB로 변환할지 여부.
do_resize (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 리사이즈할지 여부.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, 기본값 `{'shortest_edge' : 800, 'longest_edge': 1333}`): 모델에 입력되는 최대 차원을 설명합니다.
default_to_square (`bool`, *kwargs*, *선택 사항*, 기본값 `False`) : size가 int인 경우 리사이즈 시 정사각형 이미지로 설정할지 여부.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop`를 적용한 후의 출력 이미지 크기.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, 기본값 `2`) : 이미지를 리사이즈할 때 사용할 리샘플링 필터입니다. 이는 `PILImageResampling` enum 중 하나일 수 있습니다. `do_resize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_rescale (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 다시 스케일링할지 여부.
rescale_factor (`float`, *kwargs*, *선택 사항*, 기본값 `0.00392156862745098`) : `do_rescale`이 `True`로 설정된 경우 이미지를 재조정하는 데 사용되는 재조정 계수입니다.
do_normalize (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 정규화할지 여부.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택 사항*, 기본값은 `[0.485, 0.456, 0.406]`) : 정규화에 사용할 이미지 평균입니다. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택 사항*, 기본값은 `[0.229, 0.224, 0.225]`) : 정규화에 사용할 이미지 표준 편차입니다. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_pad (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 패딩할지 여부입니다. 패딩은 배치 내 가장 큰 크기로 수행하거나 이미지마다 고정된 정사각형 크기로 수행합니다. 정확한 패딩 전략은 모델에 따라 달라집니다.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 이미지를 패딩할 `{"height": int, "width" int}` 크기를 지정합니다. 전처리용으로 제공된 모든 이미지 크기보다 커야 합니다. `pad_size`가 제공되지 않으면, 이미지는 배치 내 가장 큰 높이와 너비로 패딩됩니다. `do_pad=True.`일 때만 적용됩니다.
do_center_crop (`bool`, *kwargs*, *선택*) : 이미지를 중앙 크롭할지 여부.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : `ChannelDimension.FIRST`만 지원됩니다. 느린 프로세서와의 호환성을 위해 추가되었습니다.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : 입력 이미지의 채널 차원 형식입니다. 설정하지 않으면 입력 이미지에서 채널 차원 형식을 추론합니다. 다음 중 하나일 수 있습니다: - `"channels_first"` 또는 `ChannelDimension.FIRST`: (num_channels, height, width) 형식의 이미지. - `"channels_last"` 또는 `ChannelDimension.LAST`: (height, width, num_channels) 형식의 이미지. - `"none"` 또는 `ChannelDimension.NONE`: (height, width) 형식의 이미지.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 비디오를 처리할 장치입니다. 설정되지 않은 경우, 입력 비디오에서 장치를 추론합니다.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`로 설정된 경우 스택된 텐서를 반환하고, 그렇지 않으면 텐서 목록을 반환합니다.
disable_grouping (`bool`, *kwargs*, *선택*) : 이미지의 크기에 따른 그룹화를 비활성화하여 이미지를 배치 대신 개별적으로 처리할지 여부입니다. None인 경우, 이미지가 CPU에 있으면 True, 그렇지 않으면 False로 설정됩니다. 이 선택은 https://github.com/huggingface/transformers/pull/38157에 자세히 설명된 경험적 관찰에 기반합니다.
image_seq_length (`int`, *kwargs*, *선택*) : 입력의 각 이미지에 사용할 이미지 토큰의 수입니다. 하위 호환성을 위해 추가되었지만, 향후 모델에서는 프로세서 속성으로 설정해야 합니다.
format (`str`, *kwargs*, *선택 사항*, 기본값은 `AnnotationFormat.COCO_DETECTION`) : 어노테이션의 데이터 형식. "coco_detection" 또는 "coco_panoptic" 중 하나입니다.
do_convert_annotations (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : GROUNDING_DINO 모델이 기대하는 형식으로 어노테이션을 변환할지 여부를 제어합니다. 바운딩 박스를 `(center_x, center_y, width, height)` 형식으로 변환하고 범위를 `[0, 1]`로 설정합니다. `preprocess` 메서드의 `do_convert_annotations` 매개변수로 재정의할 수 있습니다.
GroundingDinoImageProcessor 이미지 프로세서를 생성합니다.
#### preprocess[[transformers.GroundingDinoImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = None, return_segmentation_masks: bool | None = None, masks_path: str | pathlib.Path | None = None, **kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/grounding_dino/image_processing_pil_grounding_dino.py#L568)
**매개변수:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : 전처리할 이미지. 픽셀 값이 0에서 255 범위로 이루어진 단일 이미지 또는 배치 이미지를 기대합니다. 픽셀 값이 0에서 1 범위로 이루어진 이미지를 전달하는 경우 `do_rescale=False`로 설정하세요.
annotations (`AnnotationType` 또는 `list[AnnotationType]`, *선택 사항*) : 이미지에 적용되는 패딩에 따라 변환할 어노테이션입니다.
return_segmentation_masks (`bool`, *선택 사항*, 기본값 `self.return_segmentation_masks`) : 분할 마스크를 반환할지 여부.
masks_path (`str` 또는 `pathlib.Path`, *선택 사항*) : 분할 마스크를 포함하는 디렉터리의 경로.
do_convert_rgb (`bool`, *kwargs*, *선택*) : 이미지를 RGB로 변환할지 여부.
do_resize (`bool`, *kwargs*, *선택*) : 이미지를 리사이즈할지 여부.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 모델의 최대 입력 차원을 설명합니다.
default_to_square (`bool`, *kwargs*, *선택*) : size가 int인 경우 리사이즈 시 정사각형 이미지로 기본 설정할지 여부.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop`를 적용한 후의 출력 이미지 크기.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : 이미지를 리사이즈할 때 사용할 리샘플링 필터입니다. `PILImageResampling` enum 중 하나를 사용할 수 있습니다. `do_resize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_rescale (`bool`, *kwargs*, *선택*) : 이미지를 다시 스케일링할지 여부.
rescale_factor (`float`, *kwargs*, *선택*) : `do_rescale`가 `True`로 설정된 경우 이미지를 재조정하는 데 사용되는 재조정 계수입니다.
do_normalize (`bool`, *kwargs*, *선택*) : 이미지를 정규화할지 여부.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택*) : 정규화에 사용할 이미지 평균값. `do_normalize`이 `True`로 설정된 경우에만 효과가 있습니다.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택*) : 정규화에 사용할 이미지 표준 편차. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_pad (`bool`, *kwargs*, *선택*) : 이미지를 패딩할지 여부입니다. 패딩은 배치 내 가장 큰 크기로 수행하거나, 이미지마다 고정된 정사각형 크기로 수행합니다. 정확한 패딩 전략은 모델에 따라 달라집니다.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 이미지를 패딩할 `{"height": int, "width" int}` 크기를 지정합니다. 전처리용으로 제공된 모든 이미지 크기보다 커야 합니다. `pad_size`가 제공되지 않으면, 이미지는 배치 내 가장 큰 높이와 너비로 패딩됩니다. `do_pad=True.`일 때만 적용됩니다.
do_center_crop (`bool`, *kwargs*, *선택*) : 이미지를 중앙 크롭할지 여부.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : `ChannelDimension.FIRST`만 지원됩니다. 느린 프로세서와의 호환성을 위해 추가되었습니다.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : 입력 이미지의 채널 차원 형식입니다. 설정하지 않으면 입력 이미지에서 채널 차원 형식을 추론합니다. 다음 중 하나일 수 있습니다: - `"channels_first"` 또는 `ChannelDimension.FIRST`: (num_channels, height, width) 형식의 이미지. - `"channels_last"` 또는 `ChannelDimension.LAST`: (height, width, num_channels) 형식의 이미지. - `"none"` 또는 `ChannelDimension.NONE`: (height, width) 형식의 이미지.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 비디오를 처리할 장치입니다. 설정되지 않은 경우, 입력 비디오에서 장치를 추론합니다.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`로 설정된 경우 스택된 텐서를 반환하고, 그렇지 않으면 텐서 목록을 반환합니다.
disable_grouping (`bool`, *kwargs*, *선택*) : 이미지의 크기에 따른 그룹화를 비활성화하여 이미지를 배치 대신 개별적으로 처리할지 여부입니다. None인 경우, 이미지가 CPU에 있으면 True, 그렇지 않으면 False로 설정됩니다. 이 선택은 https://github.com/huggingface/transformers/pull/38157에 자세히 설명된 경험적 관찰에 기반합니다.
image_seq_length (`int`, *kwargs*, *선택*) : 입력의 각 이미지에 사용할 이미지 토큰의 수입니다. 하위 호환성을 위해 추가되었지만, 향후 모델에서는 프로세서 속성으로 설정해야 합니다.
format (`str`, *kwargs*, *선택 사항*, 기본값은 `AnnotationFormat.COCO_DETECTION`) : 어노테이션의 데이터 형식. "coco_detection" 또는 "coco_panoptic" 중 하나입니다.
do_convert_annotations (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : GROUNDING_DINO 모델이 기대하는 형식으로 어노테이션을 변환할지 여부를 제어합니다. 바운딩 박스를 `(center_x, center_y, width, height)` 형식으로 변환하고 범위를 `[0, 1]`로 설정합니다. `preprocess` 메서드의 `do_convert_annotations` 매개변수로 재정의할 수 있습니다.
**반환값:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ 메서드가 반환하는 리스트/배열/텐서 딕셔너리('pixel_values' 등).
- **tensor_type** (`Union[None, str, TensorType]`, *선택 사항*) -- 초기화 시 PyTorch/Numpy 텐서에서 정수 목록을 변환하려면 여기에 tensor_type을 지정할 수 있습니다.
#### post_process_object_detection[[transformers.GroundingDinoImageProcessorPil.post_process_object_detection]]
```python
post_process_object_detection(outputs: GroundingDinoObjectDetectionOutput, threshold: float = 0.1, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/grounding_dino/image_processing_pil_grounding_dino.py#L713)
**매개변수:**
outputs (`GroundingDinoObjectDetectionOutput`) : 모델의 원시 출력
threshold (`float`, *선택 사항*, 기본값 0.1) : 객체 감지 예측을 유지하기 위한 점수 임계값.
target_sizes (`torch.Tensor` 또는 `list[tuple[int, int]]`, *선택 사항*) : 배치 내 각 이미지의 대상 크기 `(height, width)`를 포함하는 `(batch_size, 2)` 모양의 Tensor 또는 튜플(`tuple[int, int]`) 목록입니다. 설정되지 않으면 예측 결과가 리사이즈되지 않습니다.
**반환값:** `list[Dict]`
각각 다음 키를 포함하는 사전의 목록:
- 이미지의 각 예측 박스에 대한 신뢰도 점수입니다.
- "labels": 모델이 이미지에서 예측한 클래스의 인덱스.
- "boxes": (top_left_x, top_left_y, bottom_right_x, bottom_right_y) 형식의 이미지 바운딩 박스.
[GroundingDinoForObjectDetection](/docs/transformers/v5.23.0/ko/model_doc/grounding-dino#transformers.GroundingDinoForObjectDetection)의 원시 출력을 (top_left_x, top_left_y, bottom_right_x, bottom_right_y) 형식의 최종 바운딩 박스로 변환합니다.
## GroundingDinoProcessor[[transformers.GroundingDinoProcessor]]
#### transformers.GroundingDinoProcessor[[transformers.GroundingDinoProcessor]]
```python
transformers.GroundingDinoProcessor(image_processor, tokenizer)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/grounding_dino/processing_grounding_dino.py#L100)
**매개변수:**
image_processor (`GroundingDinoImageProcessor`) : 이미지 프로세서가 필수 입력입니다.
tokenizer (`BertTokenizer`) : 토크나이저는 필수 입력입니다.
이미지 프로세서와 토크나이저를 단일 프로세서로 감싸는 GroundingDinoProcessor를 생성합니다.
[GroundingDinoProcessor](/docs/transformers/v5.23.0/ko/model_doc/grounding-dino#transformers.GroundingDinoProcessor)는 [GroundingDinoImageProcessor](/docs/transformers/v5.23.0/ko/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor)와 [BertTokenizer](/docs/transformers/v5.23.0/ko/model_doc/lxmert#transformers.BertTokenizer)의 모든 기능을 제공합니다. 자세한 내용은 [~GroundingDinoImageProcessor](/docs/transformers/v5.23.0/ko/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor)와 [~BertTokenizer](/docs/transformers/v5.23.0/ko/model_doc/lxmert#transformers.BertTokenizer)를 참고하세요.
#### __call__[[transformers.GroundingDinoProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L670)
**매개변수:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *선택*) : 전처리할 이미지. 픽셀 값이 0에서 255 범위로 이루어진 단일 이미지 또는 배치 이미지를 기대합니다. 픽셀 값이 0에서 1 범위로 이루어진 이미지를 전달하는 경우 `do_rescale=False`로 설정하세요.
text (`Union[str, list[str], list[list[str]]]`, *선택*) : 인코딩할 시퀀스 또는 시퀀스 배치입니다. 각 시퀀스는 문자열 또는 문자열 목록(사전 토큰화된 문자열)일 수 있습니다. 사전 토큰화된 입력을 전달하는 경우, 배치 입력과의 혼동을 피하기 위해 `is_split_into_words=True`를 설정하세요.
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`, *선택*) : 전처리할 비디오입니다. 픽셀 값이 0에서 255 범위를 가지는 단일 비디오 또는 비디오 배치(batch)를 기대합니다. 픽셀 값이 0에서 1 범위를 가지는 비디오를 전달하는 경우 `do_rescale=False`로 설정하세요.
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`, *선택 사항*) : 준비할 오디오 또는 오디오 배치입니다. 각 오디오는 NumPy 배열 또는 PyTorch 텐서일 수 있습니다. NumPy 배열/PyTorch 텐서의 경우, 각 오디오의 shape은 (C, T)여야 하며, 여기서 C는 채널 수, T는 오디오의 샘플 길이입니다.
return_mm_token_type_ids (`bool`, *kwargs*) : 멀티모달 플레이스홀더 토큰의 위치를 나타내는 멀티모달 토큰 타입 ID를 반환할지 여부.
return_text_replacement_offsets (`bool`, *kwargs*) : 각 멀티모달 플레이스홀더 및 그 대체 문자열의 문자 오프셋을 반환할지 여부.
return_tensors (`str` 또는 [TensorType](/docs/transformers/v5.23.0/ko/internal/file_utils#transformers.TensorType), *optional*) : 설정된 경우, 특정 프레임워크의 텐서를 반환합니다. 허용되는 값은 다음과 같습니다: - `'pt'`: PyTorch `torch.Tensor` 객체를 반환합니다. - `'np'`: NumPy `np.ndarray` 객체를 반환합니다.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/v5.23.0/ko/main_classes/processors#transformers.ProcessingKwargs), *optional*) : 각 모달리티(텍스트, 이미지, 비디오, 오디오)에 대한 추가 처리 옵션입니다. 모델별 매개변수는 위에 나열되어 있으며, 지원되는 인수의 전체 목록은 TypedDict 클래스를 참조하세요.
#### post_process_grounded_object_detection[[transformers.GroundingDinoProcessor.post_process_grounded_object_detection]]
```python
post_process_grounded_object_detection(outputs: GroundingDinoObjectDetectionOutput, input_ids: transformers.utils.generic.TensorType | None = None, threshold: float = 0.25, text_threshold: float = 0.25, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None, text_labels: list[list[str]] | None = None)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/grounding_dino/processing_grounding_dino.py#L130)
**매개변수:**
outputs (`GroundingDinoObjectDetectionOutput`) : 모델의 원시 출력
input_ids (`torch.LongTensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 입력 텍스트의 토큰 ID입니다. 제공되지 않으면 모델 출력에서 가져옵니다.
threshold (`float`, *선택 사항*, 기본값 0.25) : 신뢰도 점수에 기반하여 객체 감지 예측을 유지할 임계값.
text_threshold (`float`, *선택 사항*, 기본값 0.25) : 텍스트 감지 예측을 유지하기 위한 점수 임계값.
target_sizes (`torch.Tensor` 또는 `list[tuple[int, int]]`, *선택 사항*) : 배치 내 각 이미지의 대상 크기 `(height, width)`를 포함하는 `(batch_size, 2)` 모양의 Tensor 또는 튜플(`tuple[int, int]`) 목록입니다. 설정되지 않으면 예측 결과가 리사이즈되지 않습니다.
text_labels (`list[list[str]]`, *선택*) : 각 이미지에서 감지할 후보 라벨 목록. 현재는 *사용되지 않지만*, zero-shot object detection 파이프라인의 시그니처에 포함해야 합니다. 텍스트 라벨은 대신 `outputs`에 제공된 `input_ids` 텐서에서 추출됩니다.
**반환값:** `list[Dict]`
각 사전에 다음을 포함하는
- **scores**: 감지된 객체에 대한 신뢰도 점수 텐서
- **boxes**: [x0, y0, x1, y1] 형식의 바운딩 박스 텐서
- **labels**: 각 감지된 객체에 대한 텍스트 라벨 목록 (v4.51.0에서 정수 id로 대체됨)
- **text_labels**: 감지된 객체에 대한 텍스트 라벨 목록
[GroundingDinoForObjectDetection](/docs/transformers/v5.23.0/ko/model_doc/grounding-dino#transformers.GroundingDinoForObjectDetection)의 원시 출력을 (top_left_x, top_left_y, bottom_right_x, bottom_right_y) 형식의 최종 바운딩 박스로 변환하고 관련 텍스트 라벨을 가져옵니다.
## GroundingDinoConfig[[transformers.GroundingDinoConfig]]
#### transformers.GroundingDinoConfig[[transformers.GroundingDinoConfig]]
```python
transformers.GroundingDinoConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, is_encoder_decoder: bool = True, backbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, num_queries: int = 900, encoder_layers: int = 6, encoder_ffn_dim: int = 2048, encoder_attention_heads: int = 8, decoder_layers: int = 6, decoder_ffn_dim: int = 2048, decoder_attention_heads: int = 8, activation_function: str = 'relu', d_model: int = 256, dropout: float | int = 0.1, attention_dropout: float | int = 0.0, activation_dropout: float | int = 0.0, auxiliary_loss: bool = False, position_embedding_type: str = 'sine', num_feature_levels: int = 4, encoder_n_points: int = 4, decoder_n_points: int = 4, two_stage: bool = True, class_cost: float = 1.0, bbox_cost: float = 5.0, giou_cost: float = 2.0, bbox_loss_coefficient: float = 5.0, giou_loss_coefficient: float = 2.0, focal_alpha: float = 0.25, disable_custom_kernels: bool = False, max_text_len: int = 256, text_enhancer_dropout: float | int = 0.0, fusion_droppath: float | int = 0.1, fusion_dropout: float | int = 0.0, embedding_init_target: bool = True, query_dim: int = 4, decoder_bbox_embed_share: bool = True, two_stage_bbox_embed_share: bool = False, positional_embedding_temperature: int = 20, init_std: float = 0.02, layer_norm_eps: float = 1e-05, tie_word_embeddings: bool = True)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/grounding_dino/configuration_grounding_dino.py#L28)
**매개변수:**
is_encoder_decoder (`bool`, *선택 사항*, 기본값 `True`) : 모델이 인코더/디코더로 사용되는지 여부.
backbone_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *선택*) : 백본 모델의 구성입니다.
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *선택*) : 텍스트 백본의 config 객체 또는 사전입니다.
num_queries (`int`, *선택 사항*, 기본값 900) : 객체 쿼리의 수, 즉 감지 슬롯의 수입니다. 이는 [GroundingDinoModel](/docs/transformers/v5.23.0/ko/model_doc/grounding-dino#transformers.GroundingDinoModel)이 단일 이미지에서 감지할 수 있는 최대 객체 수입니다.
encoder_layers (`int`, *선택 사항*, 기본값 `6`) : Transformer 인코더의 숨겨진 레이어 수. 설정되지 않으면 `num_layers`와 동일한 값을 사용합니다.
encoder_ffn_dim (`int`, *선택 사항*, 기본값 `2048`) : 인코더의 "중간"(일반적으로 feed-forward라고도 함) 레이어의 차원.
encoder_attention_heads (`int`, *선택 사항*, 기본값 `8`) : Transformer 인코더의 각 어텐션 레이어에 사용할 어텐션 헤드 수입니다.
decoder_layers (`int`, *선택 사항*, 기본값 `6`) : Transformer decoder의 숨겨진 레이어 수입니다. 설정하지 않으면 `num_layers`와 동일한 값을 사용합니다.
decoder_ffn_dim (`int`, *선택 사항*, 기본값 `2048`) : 디코더의 "intermediate"(일반적으로 feed-forward라고도 함) 레이어의 차원.
decoder_attention_heads (`int`, *선택 사항*, 기본값 `8`) : Transformer decoder의 각 attention layer에 사용할 attention head의 수입니다.
activation_function (`str`, *선택 사항*, 기본값 `relu`) : 디코더의 비선형 활성화 함수(함수 또는 문자열). 예를 들어, `"gelu"`, `"relu"`, `"silu"` 등.
d_model (`int`, *선택 사항*, 기본값 `256`) : 인코더 레이어와 풀러 레이어의 크기.
dropout (`Union[float, int]`, *선택 사항*, 기본값 `0.1`) : 모든 dropout 레이어의 비율입니다.
attention_dropout (`Union[float, int]`, *선택 사항*, 기본값 `0.0`) : attention 확률에 적용할 dropout 비율입니다.
activation_dropout (`Union[float, int]`, *선택 사항*, 기본값 `0.0`) : 완전 연결 계층 내부 활성화에 적용되는 dropout 비율입니다.
auxiliary_loss (`bool`, *선택 사항*, 기본값 `False`) : 보조 디코딩 손실(각 디코더 레이어의 손실)을 사용할지 여부입니다.
position_embedding_type (`str`, *선택 사항*, 기본값 `"sine"`) : 이미지 특징 위에 사용할 위치 임베딩의 유형. `"sine"` 또는 `"learned"` 중 하나입니다.
num_feature_levels (`int`, *선택 사항*, 기본값 4) : 입력 특징 레벨의 수입니다.
encoder_n_points (`int`, *선택 사항*, 기본값 4) : 인코더의 각 어텐션 헤드에서 각 특징 레벨당 샘플링된 키의 수입니다.
decoder_n_points (`int`, *선택 사항*, 기본값 4) : 디코더의 각 어텐션 헤드에서 각 특징 레벨당 샘플링된 키의 수입니다.
two_stage (`bool`, *선택 사항*, 기본값 `True`) : Grounding DINO의 변형으로 영역 제안(region proposals)을 생성하고, 이를 디코더에 추가로 입력하여 바운딩 박스를 반복적으로 정교화하는 2단계 deformable DETR를 적용할지 여부.
class_cost (`float`, *선택 사항*, 기본값 `1.0`) : 헝가리안 매칭 비용에서 분류 오류의 상대적 가중치입니다.
bbox_cost (`float`, *선택 사항*, 기본값 `5.0`) : 헝가리안 매칭 비용에서 L1 바운딩 박스 오류의 상대적 가중치입니다.
giou_cost (`float`, *선택 사항*, 기본값 `2.0`) : 헝가리안 매칭 비용에서 일반화 IoU 손상의 상대적 가중치입니다.
bbox_loss_coefficient (`float`, *선택 사항*, 기본값 `5.0`) : 파노픽 세분화 손실에서 L1 바운딩 박스 손실의 상대적 가중치입니다.
giou_loss_coefficient (`float`, *선택 사항*, 기본값 `2.0`) : 파노픽 세그멘테이션 손실에서 일반화 IoU 손실의 상대적 가중치.
focal_alpha (`float`, *선택 사항*, 기본값 `0.25`) : focal loss의 Alpha 매개변수입니다.
disable_custom_kernels (`bool`, *선택 사항*, 기본값 `False`) : 커스텀 CUDA 및 CPU 커널 사용을 비활성화합니다. PyTorch ONNX export에서 커스텀 커널이 지원되지 않으므로 ONNX export를 위해 이 옵션이 필요합니다.
max_text_len (`int`, *선택 사항*, 기본값 256) : 텍스트 입력의 최대 길이입니다.
text_enhancer_dropout (`float`, *선택 사항*, 기본값 0.0) : 텍스트 enhancer의 dropout 비율입니다.
fusion_droppath (`float`, *선택 사항*, 기본값 0.1) : fusion 모듈의 droppath 비율입니다.
fusion_dropout (`float`, *선택 사항*, 기본값 0.0) : fusion 모듈의 dropout 비율입니다.
embedding_init_target (`bool`, *선택 사항*, 기본값 `True`) : Embedding 가중치로 타겟을 초기화할지 여부.
query_dim (`int`, *선택 사항*, 기본값 4) : 쿼리 벡터의 차원입니다.
decoder_bbox_embed_share (`bool`, *선택 사항*, 기본값 `True`) : 모든 decoder layer에서 bbox regression head를 공유할지 여부.
two_stage_bbox_embed_share (`bool`, *선택 사항*, 기본값 `False`) : 두 단계 bbox 생성기와 region proposal 생성 사이에 bbox 임베딩을 공유할지 여부.
positional_embedding_temperature (`float`, *선택 사항*, 기본값 20) : 비전 백본과 함께 사용되는 Sine Positional Embedding의 temperature입니다.
init_std (`float`, *선택 사항*, 기본값 `0.02`) : 모든 가중치 행렬을 초기화하는 truncated_normal_initializer의 표준 편차입니다.
layer_norm_eps (`float`, *선택 사항*, 기본값 `1e-05`) : layer normalization 레이어에서 사용되는 epsilon 값입니다.
tie_word_embeddings (`bool`, *선택 사항*, 기본값 `True`) : 모델의 `tied_weights_keys` 매핑에 따라 가중치 임베딩을 묶을지 여부.
이것은 Grounding Dino 모델의 구성을 저장하기 위한 구성 클래스입니다. 지정된 인자에 따라 Grounding Dino 모델을 초기화하여 모델 아키텍처를 정의하는 데 사용됩니다. 기본값으로 구성을 초기화하면 [IDEA-Research/grounding-dino-tiny](https://huggingface.co/IDEA-Research/grounding-dino-tiny)와 유사한 구성이 생성됩니다.
Configuration 객체는 [PreTrainedConfig](/docs/transformers/v5.23.0/ko/main_classes/configuration#transformers.PreTrainedConfig)를 상속하며, 모델 출력을 제어하는 데 사용할 수 있습니다. 자세한 내용은 [PreTrainedConfig](/docs/transformers/v5.23.0/ko/main_classes/configuration#transformers.PreTrainedConfig)의 문서를 참고하세요.
예:
```python
>>> from transformers import GroundingDinoConfig, GroundingDinoModel
>>> # Initializing a Grounding DINO IDEA-Research/grounding-dino-tiny style configuration
>>> configuration = GroundingDinoConfig()
>>> # Initializing a model (with random weights) from the IDEA-Research/grounding-dino-tiny style configuration
>>> model = GroundingDinoModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## GroundingDinoModel[[transformers.GroundingDinoModel]]
#### transformers.GroundingDinoModel[[transformers.GroundingDinoModel]]
```python
transformers.GroundingDinoModel(config: GroundingDinoConfig)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/grounding_dino/modeling_grounding_dino.py#L1869)
**매개변수:**
config ([GroundingDinoConfig](/docs/transformers/v5.23.0/ko/model_doc/grounding-dino#transformers.GroundingDinoConfig)) : 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하는 것은 모델과 관련된 가중치를 로드하지 않으며, 구성 정보만 로드합니다. 모델 가중치를 로드하려면 [from_pretrained()](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.PreTrainedModel.from_pretrained) 메서드를 확인하세요.
특정 헤드가 없는 맨 위의 raw hidden-states를 출력하는, 백본과 인코더-디코더 Transformer로 구성된 순수 Grounding DINO 모델.
이 모델은 [PreTrainedModel](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.PreTrainedModel)에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대해서는 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법과 동작에 관한 모든 사항은 PyTorch 문서를 참조하세요.
#### forward[[transformers.GroundingDinoModel.forward]]
```python
forward(pixel_values: Tensor, input_ids: Tensor, token_type_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.Tensor] = None, encoder_outputs = None, output_attentions = None, output_hidden_states = None, return_dict = None, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/grounding_dino/modeling_grounding_dino.py#L2015)
**매개변수:**
pixel_values (`torch.Tensor`, shape `(batch_size, num_channels, image_size, image_size)`) : 입력 이미지에 해당하는 텐서입니다. 픽셀 값은 [GroundingDinoImageProcessor](/docs/transformers/v5.23.0/ko/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor)를 사용하여 얻을 수 있습니다. 자세한 내용은 [GroundingDinoImageProcessor.__call__()](/docs/transformers/v5.23.0/ko/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)를 참조하세요 ([GroundingDinoProcessor](/docs/transformers/v5.23.0/ko/model_doc/grounding-dino#transformers.GroundingDinoProcessor)는 이미지 처리에 [GroundingDinoImageProcessor](/docs/transformers/v5.23.0/ko/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor)를 사용합니다).
input_ids (`torch.LongTensor`, shape `(batch_size, text_sequence_length)`) : 어휘 사전에서 입력 시퀀스 토큰의 인덱스입니다. 패딩을 제공한 경우 기본적으로 무시됩니다. [AutoTokenizer](/docs/transformers/v5.23.0/ko/model_doc/auto#transformers.AutoTokenizer)를 사용하여 인덱스를 얻을 수 있습니다. 자세한 내용은 [BertTokenizer.__call__()](/docs/transformers/v5.23.0/ko/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)를 참조하세요.
token_type_ids (`torch.LongTensor`, shape `(batch_size, text_sequence_length)`, *선택 사항*) : 입력의 첫 번째 및 두 번째 부분을 나타내는 세그먼트 토큰 인덱스입니다. 인덱스는 `[0, 1]`에서 선택되며, 0은 `sentence A` 토큰, 1은 `sentence B` 토큰에 해당합니다. [토큰 타입 ID란 무엇인가요?](../glossary#token-type-ids)
attention_mask (`torch.Tensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 패딩 토큰 인덱스에 대한 attention을 수행하지 않도록 방지하는 마스크입니다. `[0, 1]`에서 선택된 마스크 값: - **마스크되지 않은** 토큰은 1, - **마스크된** 토큰은 0. [attention 마스크란?](../glossary#attention-mask)
pixel_mask (`torch.Tensor`, shape `(batch_size, height, width)`, *선택 사항*) : 패딩 픽셀 값에 대한 attention 수행을 방지하기 위한 마스크. `[0, 1]`에서 선택된 마스크 값: - 실제 픽셀(즉, **마스크되지 않은** 픽셀)은 1, - 패딩 픽셀(즉, **마스크된** 픽셀)은 0. [attention 마스크란 무엇인가요?](../glossary#attention-mask)
encoder_outputs (``) : Tuple consists of (`last_hidden_state`, *optional*: `hidden_states`, *optional*: `attentions`) `last_hidden_state` of shape `(batch_size, sequence_length, hidden_size)`, *optional*) 은 인코더의 마지막 레이어 출력에서 생성된 hidden-states의 시퀀스입니다. 디코더의 cross-attention에 사용됩니다.
output_attentions (``) : Whether or not to return the attentions tensors of all attention layers. See `attentions` under returned tensors for more detail.
output_hidden_states (``) : Whether or not to return the hidden states of all layers. See `hidden_states` under returned tensors for more detail.
return_dict (``) : 일반 튜플 대신 [ModelOutput](/docs/transformers/v5.23.0/ko/main_classes/output#transformers.utils.ModelOutput)를 반환할지 여부.
**반환값:** `GroundingDinoModelOutput` 또는 `tuple(torch.Tensor)`
구성([GroundingDinoConfig](/docs/transformers/v5.23.0/ko/model_doc/grounding-dino#transformers.GroundingDinoConfig))과 입력에 따라 다양한 요소를 포함하는 `GroundingDinoModelOutput` 또는 `torch.Tensor`의 튜플(`return_dict=False`가 전달되거나 `config.return_dict=False`인 경우).
[GroundingDinoModel](/docs/transformers/v5.23.0/ko/model_doc/grounding-dino#transformers.GroundingDinoModel)의 forward 메서드는 `__call__` 특수 메서드를 오버라이드합니다.
`Module` 인스턴스는 전처리 및 후처리 단계를 실행하는 것을 처리하지만, 이 함수는 해당 단계를 조용히 무시하므로, 순전파(forward pass) 레시피를 이 함수 내에서 정의해야 하더라도 이후에는 이 함수 대신 `Module` 인스턴스를 호출해야 합니다.
- **last_hidden_state** (`torch.Tensor`, shape `(batch_size, num_queries, hidden_size)`) -- 모델의 decoder 마지막 레이어 출력의 hidden-state 시퀀스.
- **init_reference_points** (`torch.Tensor`, shape `(batch_size, num_queries, 4)`) -- Transformer decoder를 통해 전달되는 초기 reference points.
- **intermediate_hidden_states** (`torch.Tensor`, shape `(batch_size, config.decoder_layers, num_queries, hidden_size)`) -- 중간 hidden states의 스택 (decoder의 각 레이어 출력).
- **intermediate_reference_points** (`torch.Tensor`, shape `(batch_size, config.decoder_layers, num_queries, 4)`) -- decoder의 각 레이어의 reference point를 스택한 중간 reference point
- **decoder_hidden_states** (`tuple[torch.Tensor]`, *선택*, `output_hidden_states=True`가 전달되거나 `config.output_hidden_states=True`인 경우 반환) -- shape가 `(batch_size, sequence_length, hidden_size)`인 `torch.Tensor`의 튜플 (모델에 임베딩 레이어가 있는 경우 임베딩 출력 1개 + 각 레이어의 출력 1개).
각 레이어의 출력에서 디코더의 Hidden-states와 초기 임베딩 출력을 더한 값.
- **decoder_attentions** (`tuple[tuple[torch.Tensor]]`, *선택 사항*, `output_attentions=True`가 전달되거나 `config.output_attentions=True`인 경우 반환됨) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, 모양은 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
self-attention 헤드에서 가중 평균을 계산하는 데 사용되는, attention softmax 이후의 decoder의 attention 가중치입니다.
- **encoder_last_hidden_state_vision** (`torch.Tensor`, shape `(batch_size, sequence_length, hidden_size)`, *선택 사항*) -- 모델 인코더의 마지막 레이어 출력에서 생성된 hidden-state 시퀀스입니다.
- **encoder_last_hidden_state_text** (`torch.Tensor`, shape `(batch_size, sequence_length, hidden_size)`, *선택 사항*) -- 모델 인코더의 마지막 레이어 출력에서 생성된 hidden-state 시퀀스입니다.
- **encoder_vision_hidden_states** (`tuple(torch.Tensor)`, *선택 사항*, `output_hidden_states=True`가 전달되거나 `config.output_hidden_states=True`인 경우 반환됨) -- `torch.Tensor`의 튜플(비전 임베딩 출력 1개 + 각 레이어의 출력 1개)로, 모양은 `(batch_size, sequence_length, hidden_size)`입니다. 각 레이어 출력 시점의 비전 인코더 히든 스테이트와 초기 임베딩 출력을 포함합니다.
- **encoder_text_hidden_states** (`tuple(torch.Tensor)`, *선택 사항*, `output_hidden_states=True`가 전달되었거나 `config.output_hidden_states=True`인 경우 반환됨) -- `torch.Tensor`의 튜플(텍스트 임베딩 출력 1개 + 각 레이어 출력 1개)로, 모양은 `(batch_size, sequence_length, hidden_size)`입니다. 각 레이어 출력 및 초기 임베딩 출력에서의 텍스트 인코더 히든 스테이트입니다.
- **encoder_attentions** (`tuple(tuple(torch.Tensor))`, *선택 사항*, `output_attentions=True`가 전달되거나 `config.output_attentions=True`인 경우 반환됨) -- 각 레이어의 어텐션에 대해 하나씩 포함된 `torch.Tensor`의 튜플의 튜플로, 모양은 `(batch_size, num_heads, sequence_length, sequence_length)`입니다. 텍스트-비전 어텐션, 비전-텍스트 어텐션, 텍스트-엔핸서(셀프-어텐션) 및 멀티스케일 변형 어텐션 헤드에서 가중 평균을 계산하는 데 사용되는 어텐션 softmax 이후의 어텐션 가중치입니다. 바이어텐션 헤드에서 가중 평균을 계산하는 데 사용되는 어텐션 softmax입니다.
- **enc_outputs_class** (`torch.Tensor`, shape `(batch_size, sequence_length, config.num_labels)`, *선택 사항*, `config.two_stage=True`일 때 반환됨) -- 첫 번째 단계에서 상위 `config.num_queries` 점수 bounding box가 region proposals로 선택되는 예측 bounding box 점수입니다. bounding box 이진 분류(즉, foreground와 background)의 출력입니다.
- **enc_outputs_coord_logits** (`torch.Tensor`, shape `(batch_size, sequence_length, 4)`, *선택적*, `config.two_stage=True`일 때 반환됨) -- 1단계에서 예측된 바운딩 박스 좌표의 로짓.
- **encoder_logits** (`torch.Tensor`, shape `(batch_size, sequence_length, config.num_labels)`, *선택 사항*, `config.two_stage=True`일 때 반환됨) -- 1단계에서 상위 `config.num_queries` 점수를 가진 바운딩 박스의 로짓입니다.
- **encoder_pred_boxes** (`torch.Tensor`, shape `(batch_size, sequence_length, 4)`, *선택 사항*, `config.two_stage=True`일 때 반환됨) -- 1단계에서 상위 `config.num_queries` 점수를 가진 바운딩 박스의 좌표입니다.
예:
```python
>>> from transformers import AutoProcessor, AutoModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "a cat."
>>> processor = AutoProcessor.from_pretrained("IDEA-Research/grounding-dino-tiny")
>>> model = AutoModel.from_pretrained("IDEA-Research/grounding-dino-tiny")
>>> inputs = processor(images=image, text=text, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 900, 256]
```
## GroundingDinoForObjectDetection[[transformers.GroundingDinoForObjectDetection]]
#### transformers.GroundingDinoForObjectDetection[[transformers.GroundingDinoForObjectDetection]]
```python
transformers.GroundingDinoForObjectDetection(config: GroundingDinoConfig)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/grounding_dino/modeling_grounding_dino.py#L2385)
**매개변수:**
config ([GroundingDinoConfig](/docs/transformers/v5.23.0/ko/model_doc/grounding-dino#transformers.GroundingDinoConfig)) : 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하는 것은 모델과 관련된 가중치를 로드하지 않으며, 구성 정보만 로드합니다. 모델 가중치를 로드하려면 [from_pretrained()](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.PreTrainedModel.from_pretrained) 메서드를 확인하세요.
COCO detection과 같은 작업을 위해 객체 탐지 헤드를 상단에 배치한 Grounding DINO 모델(백본과 인코더-디코더 Transformer로 구성됨).
이 모델은 [PreTrainedModel](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.PreTrainedModel)에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대해서는 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법과 동작에 관한 모든 사항은 PyTorch 문서를 참조하세요.
#### forward[[transformers.GroundingDinoForObjectDetection.forward]]
```python
forward(pixel_values: Tensor, input_ids: LongTensor, token_type_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, pixel_mask: typing.Optional[torch.BoolTensor] = None, encoder_outputs: transformers.models.grounding_dino.modeling_grounding_dino.GroundingDinoEncoderOutput | tuple | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, labels: list[dict[str, typing.Union[torch.LongTensor, torch.Tensor]]] | None = None, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/grounding_dino/modeling_grounding_dino.py#L2426)
**매개변수:**
pixel_values (`torch.Tensor`, shape `(batch_size, num_channels, image_size, image_size)`) : 입력 이미지에 해당하는 텐서입니다. 픽셀 값은 [GroundingDinoImageProcessor](/docs/transformers/v5.23.0/ko/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor)를 사용하여 얻을 수 있습니다. 자세한 내용은 [GroundingDinoImageProcessor.__call__()](/docs/transformers/v5.23.0/ko/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)를 참조하세요 ([GroundingDinoProcessor](/docs/transformers/v5.23.0/ko/model_doc/grounding-dino#transformers.GroundingDinoProcessor)는 이미지 처리에 [GroundingDinoImageProcessor](/docs/transformers/v5.23.0/ko/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor)를 사용합니다).
input_ids (`torch.LongTensor`, shape `(batch_size, text_sequence_length)`) : 어휘 사전에서 입력 시퀀스 토큰의 인덱스입니다. 패딩을 제공한 경우 기본적으로 무시됩니다. [AutoTokenizer](/docs/transformers/v5.23.0/ko/model_doc/auto#transformers.AutoTokenizer)를 사용하여 인덱스를 얻을 수 있습니다. 자세한 내용은 [BertTokenizer.__call__()](/docs/transformers/v5.23.0/ko/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)를 참조하세요.
token_type_ids (`torch.LongTensor`, shape `(batch_size, text_sequence_length)`, *선택 사항*) : 입력의 첫 번째 및 두 번째 부분을 나타내는 세그먼트 토큰 인덱스입니다. 인덱스는 `[0, 1]`에서 선택되며, 0은 `sentence A` 토큰, 1은 `sentence B` 토큰에 해당합니다. [토큰 타입 ID란 무엇인가요?](../glossary#token-type-ids)
attention_mask (`torch.LongTensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 패딩 토큰 인덱스에 대한 어텐션 수행을 방지하기 위한 마스크. `[0, 1]`에서 선택된 마스크 값: - **마스크되지 않은** 토큰은 1, - **마스크된** 토큰은 0. [어텐션 마스크란?](../glossary#attention-mask)
pixel_mask (`torch.BoolTensor`, shape `(batch_size, height, width)`, *선택 사항*) : 패딩 픽셀 값에 대한 attention 수행을 방지하기 위한 마스크. `[0, 1]`에서 선택된 마스크 값: - 실제 픽셀(즉, **마스크되지 않은** 픽셀)은 1, - 패딩 픽셀(즉, **마스크된** 픽셀)은 0. [attention 마스크란?](../glossary#attention-mask)
encoder_outputs (`Union[~models.grounding_dino.modeling_grounding_dino.GroundingDinoEncoderOutput, tuple]`, *선택*) : (`last_hidden_state`, *선택*: `hidden_states`, *선택*: `attentions`) `last_hidden_state`의 shape이 `(batch_size, sequence_length, hidden_size)`, *선택*)인 튜플로, 인코더의 마지막 레이어 출력에서 생성된 hidden-states의 시퀀스입니다. 디코더의 cross-attention에 사용됩니다.
output_attentions (`bool`, *선택 사항*) : 모든 어텐션 레이어의 어텐션 텐서를 반환할지 여부. 자세한 내용은 반환 텐서 섹션의 `attentions`를 참조하세요.
output_hidden_states (`bool`, *선택 사항*) : 모든 레이어의 hidden states를 반환할지 여부. 자세한 내용은 반환되는 텐서 중 `hidden_states` 항목을 참조하세요.
return_dict (`bool`, *선택 사항*) : 일반 튜플 대신 [ModelOutput](/docs/transformers/v5.23.0/ko/main_classes/output#transformers.utils.ModelOutput)를 반환할지 여부.
labels (`list[Dict]` of len `(batch_size,)`, *optional*) : 이분 매칭 손실을 계산하기 위한 라벨. 딕셔너리의 목록으로, 각 딕셔너리는 최소한 다음 2개의 키를 포함해야 합니다: 'class_labels'와 'boxes' (배치 내 이미지의 클래스 라벨과 바운딩 박스). 클래스 라벨 자체는 len이 `(number of bounding boxes in the image,)`인 `torch.LongTensor`여야 하고, boxes는 shape이 `(number of bounding boxes in the image, 4)`인 `torch.Tensor`여야 합니다.
[GroundingDinoForObjectDetection](/docs/transformers/v5.23.0/ko/model_doc/grounding-dino#transformers.GroundingDinoForObjectDetection)의 forward 메서드는 `__call__` 특수 메서드를 오버라이드합니다.
`Module` 인스턴스는 전처리 및 후처리 단계를 실행하는 것을 처리하지만, 이 함수는 해당 단계를 조용히 무시하므로, 순전파(forward pass) 레시피를 이 함수 내에서 정의해야 하더라도 이후에는 이 함수 대신 `Module` 인스턴스를 호출해야 합니다.
예:
```python
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> import torch
>>> from PIL import Image
>>> from transformers import AutoProcessor, AutoModelForZeroShotObjectDetection
>>> model_id = "IDEA-Research/grounding-dino-tiny"
>>> device = "cuda"
>>> processor = AutoProcessor.from_pretrained(model_id)
>>> model = AutoModelForZeroShotObjectDetection.from_pretrained(model_id).to(device)
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> # Check for cats and remote controls
>>> text_labels = [["a cat", "a remote control"]]
>>> inputs = processor(images=image, text=text_labels, return_tensors="pt").to(device)
>>> with torch.no_grad():
... outputs = model(**inputs)
>>> results = processor.post_process_grounded_object_detection(
... outputs,
... threshold=0.4,
... text_threshold=0.3,
... target_sizes=[(image.height, image.width)]
... )
>>> # Retrieve the first image result
>>> result = results[0]
>>> for box, score, text_label in zip(result["boxes"], result["scores"], result["text_labels"]):
... box = [round(x, 2) for x in box.tolist()]
... print(f"Detected {text_label} with confidence {round(score.item(), 3)} at location {box}")
Detected a cat with confidence 0.479 at location [344.7, 23.11, 637.18, 374.28]
Detected a cat with confidence 0.438 at location [12.27, 51.91, 316.86, 472.44]
Detected a remote control with confidence 0.478 at location [38.57, 70.0, 176.78, 118.18]
```