# CLIPSeg
## 概述
CLIPSeg 模型由 Timo Lüddecke 和 Alexander Ecker 在 [Image Segmentation Using Text and Image Prompts](https://huggingface.co/papers/2112.10003) 中提出。CLIPSeg 在冻结的 [CLIP](clip) 模型之上添加了一个极简的解码器,用于实现零样本和单样本图像分割。
该论文的摘要如下:
*图像分割通常通过针对一组固定的目标类别训练模型来解决。后续若要加入额外的类别或更复杂的查询,成本高昂,因为需要在涵盖这些表达的数据集上重新训练模型。在此,我们提出一种系统,能够在测试时根据任意提示生成图像分割。提示可以是文本或图像。这种方法使我们能够创建一个统一模型(仅训练一次),用于三种常见的分割任务,这些任务各自面临不同的挑战:指代表达分割、零样本分割和单样本分割。我们以 CLIP 模型作为骨干网络,并为其扩展了一个基于 Transformer 的解码器,以实现密集预测。在扩展版的 PhraseCut 数据集上训练后,我们的系统能够根据自由文本提示或表达查询的额外图像,为图像生成二值分割图。我们详细分析了后一种基于图像的提示的不同变体。这种新颖的混合输入不仅允许动态适应上述三种分割任务,还允许适应任何可以表述为文本或图像查询的二值分割任务。最后,我们发现我们的系统能够很好地适应涉及可供性或属性的泛化查询*
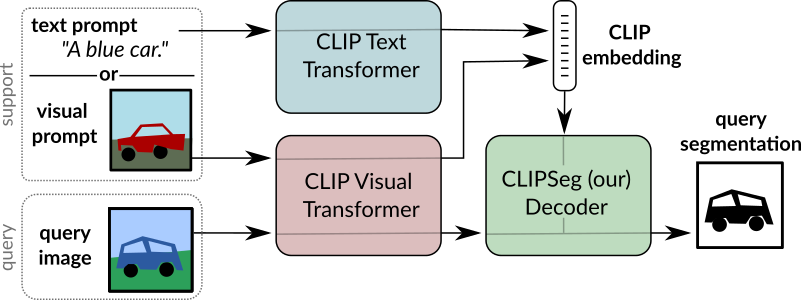 CLIPSeg 概览。摘自原始论文。
该模型由 [nielsr](https://huggingface.co/nielsr) 贡献。原始代码可在[此处](https://github.com/timojl/clipseg)找到。
## 使用技巧
- [CLIPSegForImageSegmentation](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegForImageSegmentation) 在 [CLIPSegModel](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegModel) 之上添加了一个解码器。后者与 [CLIPModel](/docs/transformers/v5.23.0/zh/model_doc/clip#transformers.CLIPModel) 完全相同。
- [CLIPSegForImageSegmentation](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegForImageSegmentation) 可以在测试时根据任意提示生成图像分割。提示可以是文本
(作为`input_ids`提供给模型)或图像(作为`conditional_pixel_values`提供给模型)。也可以提供自定义的条件嵌入(作为`conditional_embeddings`提供给模型)。
## 资源
以下是 Hugging Face 官方和社区(以 🌎 标识)提供的资源列表,可帮助您快速上手 CLIPSeg。如果您希望提交资源以收录于此,欢迎随时发起 Pull Request,我们将进行审核!理想情况下,该资源应展示一些新内容,而非重复现有资源。
- 一个演示[使用 CLIPSeg 进行零样本图像分割](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/CLIPSeg/Zero_shot_image_segmentation_with_CLIPSeg.ipynb)的笔记本。
## CLIPSegConfig[[transformers.CLIPSegConfig]]
#### transformers.CLIPSegConfig[[transformers.CLIPSegConfig]]
```python
transformers.CLIPSegConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, text_config: dict | transformers.models.clipseg.configuration_clipseg.CLIPSegTextConfig | None = None, vision_config: dict | transformers.models.clipseg.configuration_clipseg.CLIPSegVisionConfig | None = None, projection_dim: int | None = 512, logit_scale_init_value: float | int | None = 2.6592, initializer_factor: float | None = 1.0, extract_layers: list[int] | tuple[int, ...] = (3, 6, 9), reduce_dim: int = 64, decoder_num_attention_heads: int = 4, decoder_attention_dropout: float | int = 0.0, decoder_hidden_act: str = 'quick_gelu', decoder_intermediate_size: int = 2048, conditional_layer: int = 0, use_complex_transposed_convolution: bool = False)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/configuration_clipseg.py#L124)
**参数:**
text_config (`Union[dict, ~models.clipseg.configuration_clipseg.CLIPSegTextConfig]`, *可选*) : 文本骨干网络的配置对象或字典。
vision_config (`Union[dict, ~models.clipseg.configuration_clipseg.CLIPSegVisionConfig]`, *可选*) : 视觉骨干网络的配置对象或字典。
projection_dim (`int`,*可选*,默认值为 `512`):文本和视觉投影层的维度。
logit_scale_init_value (`Union[float, int]`,*可选*,默认值为 `2.6592`):*logit_scale* 参数的初始值。
initializer_factor (`float`, *可选*,默认为 `1.0`):用于初始化所有权重矩阵的系数(应保持为 1,内部用于初始化测试)。
extract_layers (`list[int]`,*可选*,默认为 `[3, 6, 9]`):在将查询图像通过 CLIP 的冻结视觉骨干网络进行前向传播时,需要提取的层。
reduce_dim (`int`, *可选*,默认为 64):用于降低 CLIP 视觉嵌入维度的值。
decoder_num_attention_heads (`int`,*可选*,默认为 `4`):Transformer 解码器中每个注意力层的注意力头数量。
decoder_attention_dropout (`Union[float, int]`,*可选*,默认值为 `0.0`):注意力概率的 dropout 比率。
decoder_hidden_act (`str`,*可选*,默认为 `quick_gelu`):解码器中的非线性激活函数(函数或字符串)。例如,`"gelu"`、`"relu"`、`"silu"` 等。
decoder_intermediate_size (`int`,*可选*,默认为 `2048`):MLP 表示的维度。
conditional_layer (`int`, *optional*, 默认为 0) : 要使用的 Transformer 编码器层,其激活值将通过 FiLM(Feature-wise Linear Modulation)与条件嵌入进行组合。如果为 0,则使用最后一层。
use_complex_transposed_convolution (`bool`,*可选*,默认为 `False`):是否在解码器中使用更复杂的转置卷积,以实现更精细的分割。
这是用于存储 CLIPSegModel 配置的类。它根据指定的参数实例化 Clipseg 模型,并定义模型架构。使用默认值实例化配置将生成与 [CIDAS/clipseg-rd64](https://huggingface.co/CIDAS/clipseg-rd64) 类似的配置。
配置对象继承自 [PreTrainedConfig](/docs/transformers/v5.23.0/zh/main_classes/configuration#transformers.PreTrainedConfig),可用于控制模型输出。有关更多信息,请参阅 [PreTrainedConfig](/docs/transformers/v5.23.0/zh/main_classes/configuration#transformers.PreTrainedConfig) 的文档。
示例:
```python
>>> from transformers import CLIPSegConfig, CLIPSegModel
>>> # Initializing a CLIPSegConfig with CIDAS/clipseg-rd64 style configuration
>>> configuration = CLIPSegConfig()
>>> # Initializing a CLIPSegModel (with random weights) from the CIDAS/clipseg-rd64 style configuration
>>> model = CLIPSegModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
>>> # We can also initialize a CLIPSegConfig from a CLIPSegTextConfig and a CLIPSegVisionConfig
>>> # Initializing a CLIPSegText and CLIPSegVision configuration
>>> config_text = CLIPSegTextConfig()
>>> config_vision = CLIPSegVisionConfig()
>>> config = CLIPSegConfig(text_config=config_text, vision_config=config_vision)
```
## CLIPSegTextConfig[[transformers.CLIPSegTextConfig]]
#### transformers.CLIPSegTextConfig[[transformers.CLIPSegTextConfig]]
```python
transformers.CLIPSegTextConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 49408, hidden_size: int = 512, intermediate_size: int = 2048, num_hidden_layers: int = 12, num_attention_heads: int = 8, max_position_embeddings: int = 77, hidden_act: str = 'quick_gelu', layer_norm_eps: float | None = 1e-05, attention_dropout: int | float | None = 0.0, initializer_range: float = 0.02, initializer_factor: float | None = 1.0, pad_token_id: int | None = 1, bos_token_id: int | None = 49406, eos_token_id: int | list[int] | None = 49407)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/configuration_clipseg.py#L31)
**参数:**
vocab_size (`int`,*可选*,默认值为 `49408`):模型的词汇表大小。定义了 `input_ids` 可以表示的不同 token 数量。
hidden_size (`int`,*可选*,默认为 `512`):隐藏表示的维度。
intermediate_size (`int`,*可选*,默认为 `2048`):MLP 表示的维度。
num_hidden_layers (`int`,*可选*,默认为 `12`):Transformer 解码器中的隐藏层数。
num_attention_heads (`int`,*可选*,默认为 `8`):Transformer 解码器中每个注意力层的注意力头数量。
max_position_embeddings (`int`,*可选*,默认值为 `77`):该模型可能使用的最大序列长度。
hidden_act (`str`,*可选*,默认为 `quick_gelu`):解码器中的非线性激活函数(函数或字符串)。例如,`"gelu"`、`"relu"`、`"silu"` 等。
layer_norm_eps (`float`,*可选*,默认为 `1e-05`):层归一化层所使用的 epsilon。
attention_dropout (`Union[int, float]`,*可选*,默认值为 `0.0`):注意力概率的 dropout 比率。
initializer_range (`float`,*可选*,默认值为 `0.02`):用于初始化所有权重矩阵的 truncated_normal_initializer 的标准差。
initializer_factor (`float`, *可选*,默认为 `1.0`):用于初始化所有权重矩阵的系数(应保持为 1,内部用于初始化测试)。
pad_token_id (`int`,*可选*,默认为 `1`):词表中用于填充的 token id。
bos_token_id (`int`,*可选*,默认为 `49406`):词汇表中用于表示流开始的 Token ID。
eos_token_id (`Union[int, list[int]]`,*可选*,默认为 `49407`):词汇表中用于表示流结束(end-of-stream)的 Token ID。
这是用于存储 CLIPSegModel 配置的类。它根据指定的参数实例化 Clipseg 模型,并定义模型架构。使用默认值实例化配置将生成与 [CIDAS/clipseg-rd64](https://huggingface.co/CIDAS/clipseg-rd64) 类似的配置。
配置对象继承自 [PreTrainedConfig](/docs/transformers/v5.23.0/zh/main_classes/configuration#transformers.PreTrainedConfig),可用于控制模型输出。有关更多信息,请参阅 [PreTrainedConfig](/docs/transformers/v5.23.0/zh/main_classes/configuration#transformers.PreTrainedConfig) 的文档。
示例:
```python
>>> from transformers import CLIPSegTextConfig, CLIPSegTextModel
>>> # Initializing a CLIPSegTextConfig with CIDAS/clipseg-rd64 style configuration
>>> configuration = CLIPSegTextConfig()
>>> # Initializing a CLIPSegTextModel (with random weights) from the CIDAS/clipseg-rd64 style configuration
>>> model = CLIPSegTextModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## CLIPSegVisionConfig[[transformers.CLIPSegVisionConfig]]
#### transformers.CLIPSegVisionConfig[[transformers.CLIPSegVisionConfig]]
```python
transformers.CLIPSegVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, intermediate_size: int = 3072, num_hidden_layers: int = 12, num_attention_heads: int = 12, num_channels: int = 3, image_size: int | list[int] | tuple[int, int] | None = 224, patch_size: int | list[int] | tuple[int, int] | None = 32, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: int | float | None = 0.0, initializer_range: float = 0.02, initializer_factor: float = 1.0)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/configuration_clipseg.py#L80)
**参数:**
hidden_size (`int`,*可选*,默认为 `768`):隐藏表示的维度。
intermediate_size (`int`,*可选*,默认值为 `3072`):MLP 表示的维度。
num_hidden_layers (`int`,*可选*,默认为 `12`):Transformer 解码器中的隐藏层数。
num_attention_heads (`int`,*可选*,默认为 `12`):Transformer 解码器中每个注意力层的注意力头数量。
num_channels (`int`,*可选*,默认为 `3`):输入通道数。
image_size (`Union[int, list[int], tuple[int, int]]`,*可选*,默认为 `224`):每张图片的尺寸(分辨率)。
patch_size (`Union[int, list[int], tuple[int, int]]`,*可选*,默认为 `32`):每个 patch 的大小(分辨率)。
hidden_act (`str`,*可选*,默认为 `quick_gelu`):解码器中的非线性激活函数(函数或字符串)。例如,`"gelu"`、`"relu"`、`"silu"` 等。
layer_norm_eps (`float`,*可选*,默认为 `1e-05`):层归一化层所使用的 epsilon。
attention_dropout (`Union[int, float]`,*可选*,默认值为 `0.0`):注意力概率的 dropout 比率。
initializer_range (`float`,*可选*,默认值为 `0.02`):用于初始化所有权重矩阵的 truncated_normal_initializer 的标准差。
initializer_factor (`float`, *可选*,默认为 `1.0`):用于初始化所有权重矩阵的系数(应保持为 1,内部用于初始化测试)。
这是用于存储 CLIPSegModel 配置的类。它根据指定的参数实例化 Clipseg 模型,并定义模型架构。使用默认值实例化配置将生成与 [CIDAS/clipseg-rd64](https://huggingface.co/CIDAS/clipseg-rd64) 类似的配置。
配置对象继承自 [PreTrainedConfig](/docs/transformers/v5.23.0/zh/main_classes/configuration#transformers.PreTrainedConfig),可用于控制模型输出。有关更多信息,请参阅 [PreTrainedConfig](/docs/transformers/v5.23.0/zh/main_classes/configuration#transformers.PreTrainedConfig) 的文档。
示例:
```python
>>> from transformers import CLIPSegVisionConfig, CLIPSegVisionModel
>>> # Initializing a CLIPSegVisionConfig with CIDAS/clipseg-rd64 style configuration
>>> configuration = CLIPSegVisionConfig()
>>> # Initializing a CLIPSegVisionModel (with random weights) from the CIDAS/clipseg-rd64 style configuration
>>> model = CLIPSegVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## CLIPSegProcessor[[transformers.CLIPSegProcessor]]
#### transformers.CLIPSegProcessor[[transformers.CLIPSegProcessor]]
```python
transformers.CLIPSegProcessor(image_processor = None, tokenizer = None, **kwargs)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/processing_clipseg.py#L24)
**参数:**
image_processor (`ViTImageProcessor`):图像处理器是必需的输入。
tokenizer (`CLIPTokenizer`):分词器是必需的输入。
构建一个 CLIPSegProcessor,它将图像处理器和分词器封装为单个处理器。
[CLIPSegProcessor](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegProcessor) 提供了 [ViTImageProcessor](/docs/transformers/v5.23.0/zh/model_doc/vit#transformers.ViTImageProcessor) 和 [CLIPTokenizer](/docs/transformers/v5.23.0/zh/model_doc/clip#transformers.CLIPTokenizer) 的所有功能。有关更多信息,请参阅 [~ViTImageProcessor](/docs/transformers/v5.23.0/zh/model_doc/vit#transformers.ViTImageProcessor) 和 [~CLIPTokenizer](/docs/transformers/v5.23.0/zh/model_doc/clip#transformers.CLIPTokenizer)。
#### __调用__[[transformers.CLIPSegProcessor.__call__]]
```python
__call__(text = None, images = None, visual_prompt = None, **kwargs)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/processing_clipseg.py#L28)
**参数:**
text (``) : The sequence or batch of sequences to be encoded. Each sequence can be a string or a list of strings (pretokenized string). If you pass a pretokenized input, set `is_split_into_words=True` to avoid ambiguity with batched inputs.
images (``) : Image to preprocess. Expects a single or batch of images with pixel values ranging from 0 to 255. If passing in images with pixel values between 0 and 1, set `do_rescale=False`.
visual_prompt (`PIL.Image.Image`, `np.ndarray`, `torch.Tensor`, `list[PIL.Image.Image]`, `list[np.ndarray]`, `list[torch.Tensor]`) : 要准备处理的视觉提示图像或图像批次。每个视觉提示图像可以是 PIL 图像、NumPy 数组或 PyTorch 张量。对于 NumPy 数组/PyTorch 张量,每个图像的形状应为 (C, H, W),其中 C 是通道数,H 和 W 分别是图像的高度和宽度。
return_tensors (`str` 或 [TensorType](/docs/transformers/v5.23.0/zh/internal/file_utils#transformers.TensorType),*可选*):如果设置,将返回特定框架的张量。可接受的值为: - `'pt'`:返回 PyTorch `torch.Tensor` 对象。 - `'np'`:返回 NumPy `np.ndarray` 对象。
**返回:** [BatchEncoding](/docs/transformers/v5.23.0/zh/main_classes/tokenizer#transformers.BatchEncoding)
一个包含以下字段的 [BatchEncoding](/docs/transformers/v5.23.0/zh/main_classes/tokenizer#transformers.BatchEncoding):
- **input_ids** -- 要输入模型的 token id 列表。当 `text` 不为 `None` 时返回。
- **attention_mask** -- 指定模型应关注哪些 token 的索引列表(当 `return_attention_mask=True` 时,或当 *"attention_mask"* 位于 `self.model_input_names` 中且 `text` 不为 `None` 时)。
- **pixel_values** -- 输入模型的像素值。当 `images` 不为 `None` 时返回。
## CLIPSegModel[[transformers.CLIPSegModel]]
#### transformers.CLIPSegModel[[transformers.CLIPSegModel]]
```python
transformers.CLIPSegModel(config: CLIPSegConfig)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L783)
**参数:**
config ([CLIPSegConfig](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegConfig)):模型配置类,包含模型的所有参数。通过配置文件进行初始化时,不会加载与模型关联的权重,仅加载配置。请查看 [from_pretrained()](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel.from_pretrained) 方法以加载模型权重。
未添加任何特定头部的裸 Clipseg 模型,直接输出原始隐藏状态。
该模型继承自 [PreTrainedModel](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel)。请查阅父类文档,了解该库为所有模型实现的通用方法(例如下载或保存、调整输入嵌入大小、剪枝头等)。
该模型也是 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) 的子类。请将其作为常规的 PyTorch Module 使用,有关通用用法和行为的所有事项,请参阅 PyTorch 文档。
#### forward[[transformers.CLIPSegModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, return_loss: bool | None = None, interpolate_pos_encoding: bool = True, **kwargs: *)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L877)
**参数:**
input_ids (`torch.LongTensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中 token 在词汇表中的索引。默认情况下,填充(padding)将被忽略。可以使用 [AutoTokenizer](/docs/transformers/v5.23.0/zh/model_doc/auto#transformers.AutoTokenizer) 获取索引。有关详细信息,请参阅 [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 和 [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)。[什么是输入 ID?](../glossary#input-ids)
pixel_values (`torch.Tensor`,形状为 `(batch_size, num_channels, image_size, image_size)`,*可选*) : 与输入图像对应的张量。可以使用 [ViTImageProcessor](/docs/transformers/v5.23.0/zh/model_doc/vit#transformers.ViTImageProcessor) 获取像素值。有关详细信息,请参阅 [ViTImageProcessor.__call__()](/docs/transformers/v5.23.0/zh/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)([CLIPSegProcessor](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegProcessor) 使用 [ViTImageProcessor](/docs/transformers/v5.23.0/zh/model_doc/vit#transformers.ViTImageProcessor) 处理图像)。
attention_mask (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于避免对填充(padding)标记索引执行注意力机制的掩码。掩码值取自 `[0, 1]`: - 1 表示**未掩码**的标记, - 0 表示**已掩码**的标记。 [什么是注意力掩码?](../glossary#attention-mask)
position_ids (`torch.LongTensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中每个 token 在位置嵌入中的位置索引。取值范围为 `[0, config.n_positions - 1]`。[什么是位置 ID?](../glossary#position-ids)
return_loss (`bool`, *可选*) : 是否返回对比损失。
interpolate_pos_encoding (`bool`, *可选*, 默认为 `True`) : 是否对预训练的位置编码进行插值。
**返回:** `CLIPSegOutput` 或 `tuple(torch.Tensor)`
`CLIPSegOutput` 或 `torch.Tensor` 元组(如果传入 `return_dict=False` 或 `config.return_dict=False`),其包含的元素取决于配置([CLIPSegConfig](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegConfig))和输入。
[CLIPSegModel](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegModel) 的 forward 方法重写了 `__call__` 特殊方法。
尽管前向传播的实现需要在此函数中定义,但之后应调用 `Module` 实例,而不是直接调用此函数,因为前者会负责执行预处理和后处理步骤,而后者会静默地忽略这些步骤。
- **loss** (`torch.Tensor`,形状为 `(1,)`,*可选*,当 `return_loss` 为 `True` 时返回) -- 用于图像-文本相似度的对比损失。
- **logits_per_image**(形状为 `(image_batch_size, text_batch_size)` 的 `torch.Tensor`)-- `image_embeds` 与 `text_embeds` 之间的缩放点积分数。这表示图像-文本相似度分数。
- **logits_per_text**(形状为 `(text_batch_size, image_batch_size)` 的 `torch.Tensor`)-- `text_embeds` 与 `image_embeds` 之间的缩放点积分数。这表示文本-图像相似度分数。
- **text_embeds**(形状为 `(batch_size, output_dim`) 的 `torch.Tensor`)-- 通过对 [CLIPSegTextModel](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegTextModel) 的池化输出应用投影层获得的文本嵌入。
- **image_embeds** (`torch.Tensor`,形状为 `(batch_size, output_dim`) -- 通过对 [CLIPSegVisionModel](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegVisionModel) 的池化输出应用投影层得到的图像嵌入。
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`,*可选*) -- [CLIPSegTextModel](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegTextModel) 的输出。
- **vision_model_output**(`~modeling_outputs.BaseModelOutputWithPooling`,*可选*)—— [CLIPSegVisionModel](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegVisionModel) 的输出。
示例:
```python
>>> import torch
>>> from transformers import AutoProcessor, CLIPSegModel
>>> from transformers.image_utils import load_image
>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(
... text=["a photo of a cat", "a photo of a dog"], images=image, return_tensors="pt", padding=True
... )
>>> with torch.inference_mode():
... outputs = model(**inputs)
>>> logits_per_image = outputs.logits_per_image # this is the image-text similarity score
>>> probs = logits_per_image.softmax(dim=1) # we can take the softmax to get the label probabilities
```
#### get_text_features[[transformers.CLIPSegModel.get_text_features]]
```python
get_text_features(input_ids: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L804)
**参数:**
input_ids (形状为 `(batch_size, sequence_length)` 的 `torch.Tensor`):输入序列中 token 在词汇表中的索引。默认情况下,填充(padding)将被忽略。可以使用 [AutoTokenizer](/docs/transformers/v5.23.0/zh/model_doc/auto#transformers.AutoTokenizer) 获取索引。有关详细信息,请参阅 [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 和 [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)。[什么是输入 ID?](../glossary#input-ids)
attention_mask (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于避免对填充(padding)标记索引执行注意力机制的掩码。掩码值取自 `[0, 1]`: - 1 表示**未掩码**的标记, - 0 表示**已掩码**的标记。 [什么是注意力掩码?](../glossary#attention-mask)
position_ids (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中每个 token 在位置嵌入中的位置索引。取值范围为 `[0, config.n_positions - 1]`。[什么是位置 ID?](../glossary#position-ids)
**返回:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) 或 `tuple(torch.Tensor)`
一个 [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) 或 `torch.Tensor` 元组(如果传入了 `return_dict=False` 或 `config.return_dict=False`),其包含的元素取决于配置([CLIPSegConfig](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegConfig))和输入。
- **last_hidden_state**(形状为 `(batch_size, sequence_length, hidden_size)` 的 `torch.Tensor`)-- 模型最后一层输出的隐藏状态序列。
- **pooler_output**(形状为 `(batch_size, hidden_size)` 的 `torch.Tensor`)-- 序列中第一个 token(分类 token)的最后一层隐藏状态,经过用于辅助预训练任务的层进一步处理后的结果。例如,对于 BERT 系列模型,这返回的是分类 token 经过线性层和 tanh 激活函数处理后的结果。线性层的权重是在预训练期间通过下一句预测(分类)目标训练得到的。
- **hidden_states** (`tuple(torch.Tensor)`,*可选*,在传入 `output_hidden_states=True` 或 `config.output_hidden_states=True` 时返回) -- 一个 `torch.Tensor` 元组(如果模型具有嵌入层,则包含嵌入层的输出,以及每一层的输出),形状为 `(batch_size, sequence_length, hidden_size)`。
模型在每一层输出处的隐藏状态,以及可选的初始嵌入输出。
- **attentions** (`tuple(torch.Tensor)`,*可选*,当传入 `output_attentions=True` 或 `config.output_attentions=True` 时返回) -- 一个 `torch.Tensor` 元组(每层一个),形状为 `(batch_size, num_heads, sequence_length, sequence_length)`。
经过注意力 softmax 后的注意力权重,用于在自注意力头中计算加权平均值。
示例:
```python
>>> import torch
>>> from transformers import AutoTokenizer, CLIPSegModel
>>> tokenizer = AutoTokenizer.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> inputs = tokenizer(["a photo of a cat", "a photo of a dog"], padding=True, return_tensors="pt")
>>> with torch.inference_mode():
... text_features = model.get_text_features(**inputs)
```
#### get_image_features[[transformers.CLIPSegModel.get_image_features]]
```python
get_image_features(pixel_values: Tensor, interpolate_pos_encoding: bool = True, **kwargs: *)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L839)
**参数:**
pixel_values (`torch.Tensor`,形状为 `(batch_size, num_channels, image_size, image_size)`):与输入图像对应的张量。可以使用 [ViTImageProcessor](/docs/transformers/v5.23.0/zh/model_doc/vit#transformers.ViTImageProcessor) 获取像素值。有关详细信息,请参阅 [ViTImageProcessor.__call__()](/docs/transformers/v5.23.0/zh/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)([CLIPSegProcessor](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegProcessor) 使用 [ViTImageProcessor](/docs/transformers/v5.23.0/zh/model_doc/vit#transformers.ViTImageProcessor) 处理图像)。
interpolate_pos_encoding (`bool`, *可选*, 默认为 `True`) : 是否对预训练的位置编码进行插值。
**返回:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) 或 `tuple(torch.Tensor)`
一个 [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) 或 `torch.Tensor` 元组(如果传入了 `return_dict=False` 或 `config.return_dict=False`),其包含的元素取决于配置([CLIPSegConfig](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegConfig))和输入。
- **last_hidden_state**(形状为 `(batch_size, sequence_length, hidden_size)` 的 `torch.Tensor`)-- 模型最后一层输出的隐藏状态序列。
- **pooler_output**(形状为 `(batch_size, hidden_size)` 的 `torch.Tensor`)-- 序列中第一个 token(分类 token)的最后一层隐藏状态,经过用于辅助预训练任务的层进一步处理后的结果。例如,对于 BERT 系列模型,这返回的是分类 token 经过线性层和 tanh 激活函数处理后的结果。线性层的权重是在预训练期间通过下一句预测(分类)目标训练得到的。
- **hidden_states** (`tuple(torch.Tensor)`,*可选*,在传入 `output_hidden_states=True` 或 `config.output_hidden_states=True` 时返回) -- 一个 `torch.Tensor` 元组(如果模型具有嵌入层,则包含嵌入层的输出,以及每一层的输出),形状为 `(batch_size, sequence_length, hidden_size)`。
模型在每一层输出处的隐藏状态,以及可选的初始嵌入输出。
- **attentions** (`tuple(torch.Tensor)`,*可选*,当传入 `output_attentions=True` 或 `config.output_attentions=True` 时返回) -- 一个 `torch.Tensor` 元组(每层一个),形状为 `(batch_size, num_heads, sequence_length, sequence_length)`。
经过注意力 softmax 后的注意力权重,用于在自注意力头中计算加权平均值。
示例:
```python
>>> import torch
>>> from transformers import AutoProcessor, CLIPSegModel
>>> from transformers.image_utils import load_image
>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(images=image, return_tensors="pt")
>>> with torch.inference_mode():
... image_features = model.get_image_features(**inputs)
```
## CLIPSegTextModel[[transformers.CLIPSegTextModel]]
#### transformers.CLIPSegTextModel[[transformers.CLIPSegTextModel]]
```python
transformers.CLIPSegTextModel(config: CLIPSegTextConfig)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L594)
**参数:**
config ([CLIPSegTextConfig](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegTextConfig)):模型配置类,包含模型的所有参数。通过配置文件进行初始化时,不会加载与模型关联的权重,仅加载配置。请查看 [from_pretrained()](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel.from_pretrained) 方法以加载模型权重。
CLIPSEG 的文本模型,顶部未添加任何分类头或投影层。
该模型继承自 [PreTrainedModel](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel)。请查阅父类文档,了解该库为所有模型实现的通用方法(例如下载或保存、调整输入嵌入大小、剪枝头等)。
该模型也是 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) 的子类。请将其作为常规的 PyTorch Module 使用,有关通用用法和行为的所有事项,请参阅 PyTorch 文档。
#### forward[[transformers.CLIPSegTextModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L610)
**参数:**
input_ids (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中各个 token 在词汇表中的索引。默认情况下,填充(padding)会被忽略。可以使用 [AutoTokenizer](/docs/transformers/v5.23.0/zh/model_doc/auto#transformers.AutoTokenizer) 获取这些索引。有关详细信息,请参阅 [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 和 [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)。[什么是输入 ID?](../glossary#input-ids)
attention_mask (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于避免对填充(padding)标记索引执行注意力机制的掩码。掩码值取自 `[0, 1]`: - 1 表示**未掩码**的标记, - 0 表示**已掩码**的标记。 [什么是注意力掩码?](../glossary#attention-mask)
position_ids (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中每个 token 在位置嵌入中的位置索引。取值范围为 `[0, config.n_positions - 1]`。[什么是位置 ID?](../glossary#position-ids)
**返回:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) 或 `tuple(torch.Tensor)`
一个 [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) 或 `torch.Tensor` 元组(如果传入了 `return_dict=False` 或 `config.return_dict=False`),其包含的元素取决于配置([CLIPSegConfig](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegConfig))和输入。
[CLIPSegTextModel](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegTextModel) 的 forward 方法重写了 `__call__` 特殊方法。
尽管前向传播的实现需要在此函数中定义,但之后应调用 `Module` 实例,而不是直接调用此函数,因为前者会负责执行预处理和后处理步骤,而后者会静默地忽略这些步骤。
- **last_hidden_state**(形状为 `(batch_size, sequence_length, hidden_size)` 的 `torch.Tensor`)-- 模型最后一层输出的隐藏状态序列。
- **pooler_output**(形状为 `(batch_size, hidden_size)` 的 `torch.Tensor`)-- 序列中第一个 token(分类 token)的最后一层隐藏状态,经过用于辅助预训练任务的层进一步处理后的结果。例如,对于 BERT 系列模型,这返回的是分类 token 经过线性层和 tanh 激活函数处理后的结果。线性层的权重是在预训练期间通过下一句预测(分类)目标训练得到的。
- **hidden_states** (`tuple(torch.Tensor)`,*可选*,在传入 `output_hidden_states=True` 或 `config.output_hidden_states=True` 时返回) -- 一个 `torch.Tensor` 元组(如果模型具有嵌入层,则包含嵌入层的输出,以及每一层的输出),形状为 `(batch_size, sequence_length, hidden_size)`。
模型在每一层输出处的隐藏状态,以及可选的初始嵌入输出。
- **attentions** (`tuple(torch.Tensor)`,*可选*,当传入 `output_attentions=True` 或 `config.output_attentions=True` 时返回) -- 一个 `torch.Tensor` 元组(每层一个),形状为 `(batch_size, num_heads, sequence_length, sequence_length)`。
经过注意力 softmax 后的注意力权重,用于在自注意力头中计算加权平均值。
示例:
```python
>>> from transformers import AutoTokenizer, CLIPSegTextModel
>>> tokenizer = AutoTokenizer.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegTextModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> inputs = tokenizer(["a photo of a cat", "a photo of a dog"], padding=True, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output # pooled (EOS token) states
```
## CLIPSegVisionModel[[transformers.CLIPSegVisionModel]]
#### transformers.CLIPSegVisionModel[[transformers.CLIPSegVisionModel]]
```python
transformers.CLIPSegVisionModel(config: CLIPSegVisionConfig)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L694)
**参数:**
config ([CLIPSegVisionConfig](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegVisionConfig)):模型配置类,包含模型的所有参数。通过配置文件进行初始化并不会加载与模型关联的权重,仅加载配置。请查看 [from_pretrained()](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel.from_pretrained) 方法以加载模型权重。
CLIPSEG 的视觉模型,顶部未添加任何分类头或投影层。
该模型继承自 [PreTrainedModel](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel)。请查阅父类文档,了解该库为所有模型实现的通用方法(例如下载或保存、调整输入嵌入大小、剪枝头等)。
该模型也是 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) 的子类。请将其作为常规的 PyTorch Module 使用,有关通用用法和行为的所有事项,请参阅 PyTorch 文档。
#### forward[[transformers.CLIPSegVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor], interpolate_pos_encoding: bool | None = True, **kwargs: *)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L710)
**参数:**
pixel_values (`torch.Tensor`,形状为 `(batch_size, num_channels, image_size, image_size)`,*可选*) : 与输入图像对应的张量。可以使用 [ViTImageProcessor](/docs/transformers/v5.23.0/zh/model_doc/vit#transformers.ViTImageProcessor) 获取像素值。有关详细信息,请参阅 [ViTImageProcessor.__call__()](/docs/transformers/v5.23.0/zh/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)([CLIPSegProcessor](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegProcessor) 使用 [ViTImageProcessor](/docs/transformers/v5.23.0/zh/model_doc/vit#transformers.ViTImageProcessor) 处理图像)。
interpolate_pos_encoding (`bool`, *可选*, 默认为 `True`) : 是否对预训练的位置编码进行插值。
**返回:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) 或 `tuple(torch.Tensor)`
一个 [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) 或 `torch.Tensor` 元组(如果传入了 `return_dict=False` 或 `config.return_dict=False`),其包含的元素取决于配置([CLIPSegConfig](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegConfig))和输入。
[CLIPSegVisionModel](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegVisionModel) 的 forward 方法重写了 `__call__` 特殊方法。
尽管前向传播的实现需要在此函数中定义,但之后应调用 `Module` 实例,而不是直接调用此函数,因为前者会负责执行预处理和后处理步骤,而后者会静默地忽略这些步骤。
- **last_hidden_state**(形状为 `(batch_size, sequence_length, hidden_size)` 的 `torch.Tensor`)-- 模型最后一层输出的隐藏状态序列。
- **pooler_output**(形状为 `(batch_size, hidden_size)` 的 `torch.Tensor`)-- 序列中第一个 token(分类 token)的最后一层隐藏状态,经过用于辅助预训练任务的层进一步处理后的结果。例如,对于 BERT 系列模型,这返回的是分类 token 经过线性层和 tanh 激活函数处理后的结果。线性层的权重是在预训练期间通过下一句预测(分类)目标训练得到的。
- **hidden_states** (`tuple(torch.Tensor)`,*可选*,在传入 `output_hidden_states=True` 或 `config.output_hidden_states=True` 时返回) -- 一个 `torch.Tensor` 元组(如果模型具有嵌入层,则包含嵌入层的输出,以及每一层的输出),形状为 `(batch_size, sequence_length, hidden_size)`。
模型在每一层输出处的隐藏状态,以及可选的初始嵌入输出。
- **attentions** (`tuple(torch.Tensor)`,*可选*,当传入 `output_attentions=True` 或 `config.output_attentions=True` 时返回) -- 一个 `torch.Tensor` 元组(每层一个),形状为 `(batch_size, num_heads, sequence_length, sequence_length)`。
经过注意力 softmax 后的注意力权重,用于在自注意力头中计算加权平均值。
示例:
```python
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> from transformers import AutoProcessor, CLIPSegVisionModel
>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegVisionModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output # pooled CLS states
```
## CLIPSegForImageSegmentation[[transformers.CLIPSegForImageSegmentation]]
#### transformers.CLIPSegForImageSegmentation[[transformers.CLIPSegForImageSegmentation]]
```python
transformers.CLIPSegForImageSegmentation(config: CLIPSegConfig)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L961)
**参数:**
config ([CLIPSegConfig](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegConfig)):模型配置类,包含模型的所有参数。通过配置文件进行初始化时,不会加载与模型关联的权重,仅加载配置。请查看 [from_pretrained()](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel.from_pretrained) 方法以加载模型权重。
CLIPSeg 模型,其顶部采用基于 Transformer 的解码器,用于实现零样本和单样本图像分割。
该模型继承自 [PreTrainedModel](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel)。请查阅父类文档,了解该库为所有模型实现的通用方法(例如下载或保存、调整输入嵌入大小、剪枝头等)。
该模型也是 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) 的子类。请将其作为常规的 PyTorch Module 使用,有关通用用法和行为的所有事项,请参阅 PyTorch 文档。
#### forward[[transformers.CLIPSegForImageSegmentation.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, conditional_pixel_values: typing.Optional[torch.Tensor] = None, conditional_embeddings: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = True, **kwargs: *)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/clipseg/modeling_clipseg.py#L1001)
**参数:**
input_ids (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中各个 token 在词汇表中的索引。默认情况下,填充(padding)会被忽略。可以使用 [AutoTokenizer](/docs/transformers/v5.23.0/zh/model_doc/auto#transformers.AutoTokenizer) 获取这些索引。有关详细信息,请参阅 [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 和 [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)。[什么是输入 ID?](../glossary#input-ids)
pixel_values (`torch.Tensor`,形状为 `(batch_size, num_channels, image_size, image_size)`,*可选*) : 与输入图像对应的张量。可以使用 [ViTImageProcessor](/docs/transformers/v5.23.0/zh/model_doc/vit#transformers.ViTImageProcessor) 获取像素值。有关详细信息,请参阅 [ViTImageProcessor.__call__()](/docs/transformers/v5.23.0/zh/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)([CLIPSegProcessor](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegProcessor) 使用 [ViTImageProcessor](/docs/transformers/v5.23.0/zh/model_doc/vit#transformers.ViTImageProcessor) 处理图像)。
conditional_pixel_values (`torch.Tensor`, *可选*) : 条件图像的像素值。
conditional_embeddings (`torch.Tensor`,形状为 `(batch_size, config.projection_dim)`,*可选*):查询图像的嵌入。如果提供,模型将使用此值,而不是从 conditional_pixel_values 计算嵌入。
attention_mask (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于避免对填充(padding)标记索引执行注意力机制的掩码。掩码值取自 `[0, 1]`: - 1 表示**未掩码**的标记, - 0 表示**已掩码**的标记。 [什么是注意力掩码?](../glossary#attention-mask)
position_ids (`torch.LongTensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中每个 token 在位置嵌入中的位置索引。取值范围为 `[0, config.n_positions - 1]`。[什么是位置 ID?](../glossary#position-ids)
labels (`torch.Tensor`,形状为 `(batch_size, height, width)`,*可选*) : 真实分割掩码,取值范围为 `[0, 1]`,且空间尺寸与 `logits` 相同。将在预测的 logits 与这些掩码之间计算二元交叉熵损失。
interpolate_pos_encoding (`bool`, *可选*, 默认为 `True`) : 是否对预训练的位置编码进行插值。
**返回:** `CLIPSegOutput` 或 `tuple(torch.Tensor)`
`CLIPSegOutput` 或 `torch.Tensor` 元组(如果传入 `return_dict=False` 或 `config.return_dict=False`),其包含的元素取决于配置([CLIPSegConfig](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegConfig))和输入。
[CLIPSegForImageSegmentation](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegForImageSegmentation) 的 forward 方法重写了 `__call__` 特殊方法。
尽管前向传播的实现需要在此函数中定义,但之后应调用 `Module` 实例,而不是直接调用此函数,因为前者会负责执行预处理和后处理步骤,而后者会静默地忽略这些步骤。
- **loss** (`torch.Tensor`,形状为 `(1,)`,*可选*,当 `return_loss` 为 `True` 时返回) -- 用于图像-文本相似度的对比损失。
- **logits_per_image**(形状为 `(image_batch_size, text_batch_size)` 的 `torch.Tensor`)-- `image_embeds` 与 `text_embeds` 之间的缩放点积分数。这表示图像-文本相似度分数。
- **logits_per_text**(形状为 `(text_batch_size, image_batch_size)` 的 `torch.Tensor`)-- `text_embeds` 与 `image_embeds` 之间的缩放点积分数。这表示文本-图像相似度分数。
- **text_embeds**(形状为 `(batch_size, output_dim`) 的 `torch.Tensor`)-- 通过对 [CLIPSegTextModel](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegTextModel) 的池化输出应用投影层获得的文本嵌入。
- **image_embeds** (`torch.Tensor`,形状为 `(batch_size, output_dim`) -- 通过对 [CLIPSegVisionModel](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegVisionModel) 的池化输出应用投影层得到的图像嵌入。
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`,*可选*) -- [CLIPSegTextModel](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegTextModel) 的输出。
- **vision_model_output**(`~modeling_outputs.BaseModelOutputWithPooling`,*可选*)—— [CLIPSegVisionModel](/docs/transformers/v5.23.0/zh/model_doc/clipseg#transformers.CLIPSegVisionModel) 的输出。
示例:
```python
>>> import torch
>>> from transformers import AutoProcessor, CLIPSegForImageSegmentation
>>> from transformers.image_utils import load_image
>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegForImageSegmentation.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> texts = ["a cat", "a remote", "a blanket"]
>>> inputs = processor(text=texts, images=[image] * len(texts), padding=True, return_tensors="pt")
>>> with torch.inference_mode():
... outputs = model(**inputs)
>>> logits = outputs.logits
>>> print(logits.shape)
torch.Size([3, 352, 352])
```