
Hub documentation
Menggunakan 🤗 transformers di Hugging Face
Menggunakan 🤗 transformers di Hugging Face
🤗 transformers adalah pustaka yang dikelola oleh Hugging Face dan komunitas, untuk Machine Learning terkini untuk PyTorch, TensorFlow, dan JAX. Pustaka ini menyediakan ribuan model pretrained untuk melakukan tugas pada berbagai modalitas seperti teks, visi, dan audio. Kami sedikit bias, tetapi kami benar-benar menyukai 🤗 transformers!
Menjelajahi 🤗 transformers di Hub
Terdapat lebih dari 630.000 model transformers di Hub yang dapat Anda temukan dengan memfilter di sebelah kiri halaman model.
Anda dapat menemukan model untuk berbagai tugas yang berbeda:
- Mengekstrak jawaban dari konteks (question-answering).
- Membuat ringkasan dari teks yang besar (summarization).
- Klasifikasikan teks (misalnya sebagai spam atau bukan spam, text-classification).
- Buat teks baru dengan model seperti GPT (text-generation).
- Identifikasi bagian-bagian kalimat (kata kerja, subjek, dll.) atau entitas (negara, organisasi, dll.) dalam sebuah kalimat (token-classification).
- Transkripsi file audio menjadi teks (automatic-speech-recognition).
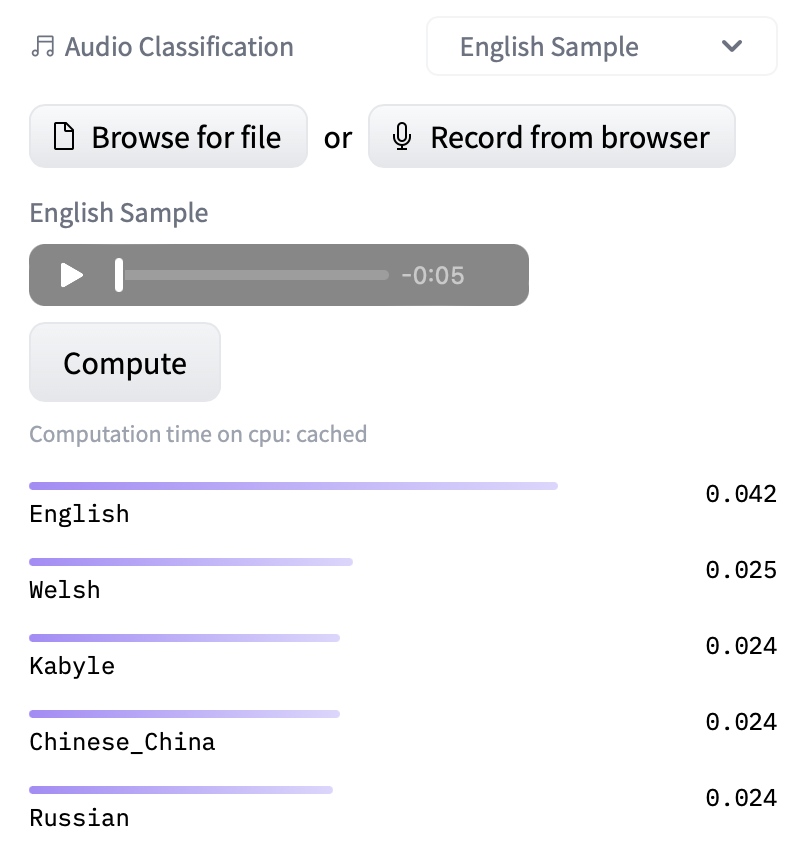
- Klasifikasikan pembicara atau bahasa dalam file audio (audio-classification).
- Deteksi objek dalam gambar (object-detection).
- Segmentasi gambar (image-segmentation).
- Lakukan Pembelajaran Penguatan (reinforcement-learning)!
Anda dapat mencoba model-model tersebut langsung di browser jika ingin mengujinya tanpa mengunduhnya, berkat widget di dalam browser!
File repositori Transformers
Repositori model Transformers umumnya berisi file model dan file preprocessor.

Model
File
config.jsonmenyimpan detail tentang arsitektur model, seperti jumlah lapisan tersembunyi, ukuran kosakata, jumlah kepala perhatian, dimensi setiap kepala, dan lainnya. Metadata ini adalah cetak biru model.File
model.safetensorsmenyimpan lapisan dan bobot model yang telah dilatih sebelumnya. Untuk model besar, file safetensors dipecah menjadi beberapa bagian (sharded) untuk membatasi jumlah memori yang dibutuhkan untuk memuatnya. Telusuri filemodel.safetensors.index.jsonuntuk melihat dari file safetensors mana bobot model dimuat.{ "metadata": { "total_size": 16060522496 }, "weight_map": { "lm_head.weight": "model-00004-of-00004.safetensors", "model.embed_tokens.weight": "model-00001-of-00004.safetensors", ... } }Anda juga dapat memvisualisasikan pemetaan ini dengan mengklik tombol ↗ di kartu model.

Safetensors adalah format serialisasi yang lebih aman dan cepat - dibandingkan dengan pickle - untuk menyimpan bobot model. Anda mungkin akan menemui bobot yang di-pickle dalam format seperti
bin,pth, atauckpt, tetapisafetensorssemakin diadopsi dalam ekosistem model sebagai alternatif yang lebih baik.Sebuah model juga dapat memiliki file
generation_config.jsonyang menyimpan detail tentang cara menghasilkan teks, seperti apakah akan melakukan sampling, token teratas untuk disampelkan, suhu, dan token khusus untuk memulai dan menghentikan generasi.
Preprocessor
- File
tokenizer_config.jsonmenyimpan token khusus yang ditambahkan oleh sebuah model. Token khusus ini memberi sinyal berbagai hal kepada model, seperti awal dari sebuah kalimat, format tertentu untuk template chat, atau penanda adanya gambar. File ini juga menampilkan panjang urutan input maksimum yang dapat diterima model, kelas preprocessor, dan output yang dikembalikannya. - File
tokenizer.jsonmenyimpan kosakata yang dipelajari oleh model. special_tokens_map.jsonadalah pemetaan dari token khusus. Sebagai contoh, pada Llama 3.1-8B-Instruct, token awal string adalah"<|begin_of_text|>".
Untuk modalitas lain, file
tokenizer_config.jsondigantikan olehpreprocessor_config.json.
Menggunakan model yang sudah ada
Semua model transformer siap digunakan! Tergantung pada cara Anda ingin menggunakannya, Anda dapat menggunakan API tingkat tinggi dengan fungsi pipeline atau menggunakan AutoModel untuk kontrol yang lebih besar.
# With pipeline, just specify the task and the model id from the Hub.
from transformers import pipeline
pipe = pipeline("text-generation", model="distilbert/distilgpt2")

# If you want more control, you will need to define the tokenizer and model.
from transformers import AutoTokenizer, AutoModelForCausalLM
tokenizer = AutoTokenizer.from_pretrained("distilbert/distilgpt2")
model = AutoModelForCausalLM.from_pretrained("distilbert/distilgpt2")
Anda juga dapat memuat model dari versi tertentu (berdasarkan commit hash, nama tag, atau branch) sebagai berikut:
model = AutoModel.from_pretrained(
    "julien-c/EsperBERTo-small", revision="v2.0.1"  # tag name, or branch name, or commit hash
)
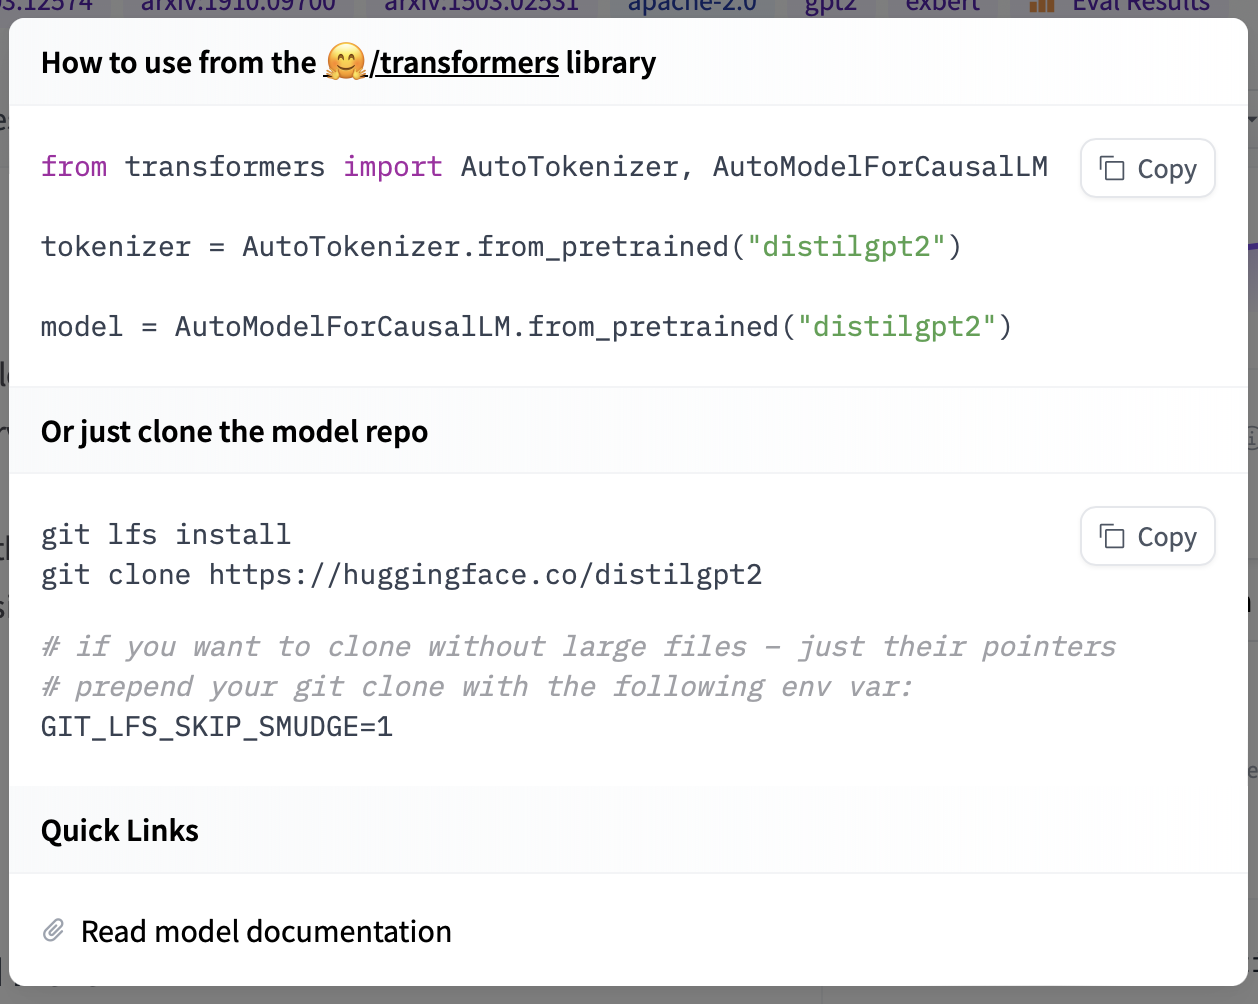
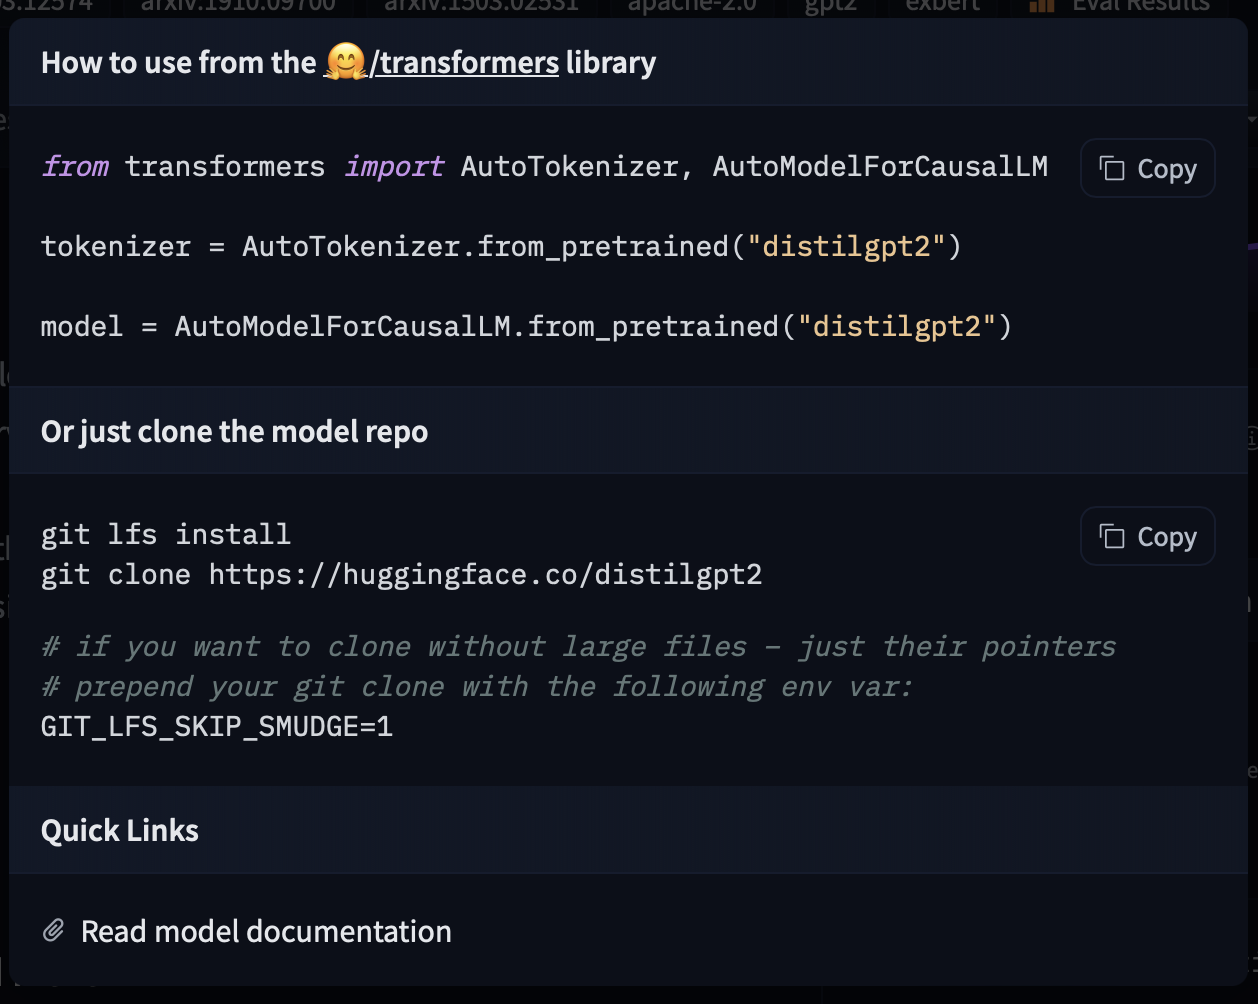
Jika Anda ingin melihat cara memuat model tertentu, Anda dapat mengklik Use in Transformers dan Anda akan diberikan potongan kode yang berfungsi untuk memuatnya! Jika Anda membutuhkan informasi lebih lanjut tentang arsitektur model, Anda juga dapat mengklik “Read model documentation” di bagian bawah potongan kode tersebut.
Berbagi model Anda
Untuk membaca semua tentang berbagi model dengan transformers, silakan buka panduan Share a model di dokumentasi resmi.
Banyak kelas di transformers, seperti model dan tokenizer, memiliki metode push_to_hub yang memungkinkan Anda mengunggah file ke repositori dengan mudah.
# Pushing model to your own account
model.push_to_hub("my-awesome-model")

# Pushing your tokenizer
tokenizer.push_to_hub("my-awesome-model")

# Pushing all things after training
trainer.push_to_hub()
Masih ada banyak hal lain yang bisa Anda lakukan, jadi kami menyarankan untuk meninjau panduan Bagikan model.
Sumber daya tambahan
- Transformers library.
- Dokumentasi Transformers.
- Bagikan panduan model.