
Hub documentation
WebDataset
WebDataset
WebDatasetは、大規模なデータセット向けのI/Oパイプラインを作成するためのライブラリです。 シーケンシャルI/Oとシャーディングの機能により、大規模なデータセットをDataLoaderにストリーミングする際に特に有用です。
WebDataset形式
WebDatasetファイルは、一連のデータファイルを含むTARアーカイブです。 同じプレフィックスを持つ連続するすべてのデータファイルは、同じサンプルの一部(例:画像/音声ファイルとそのラベルまたはメタデータ)とみなされます。
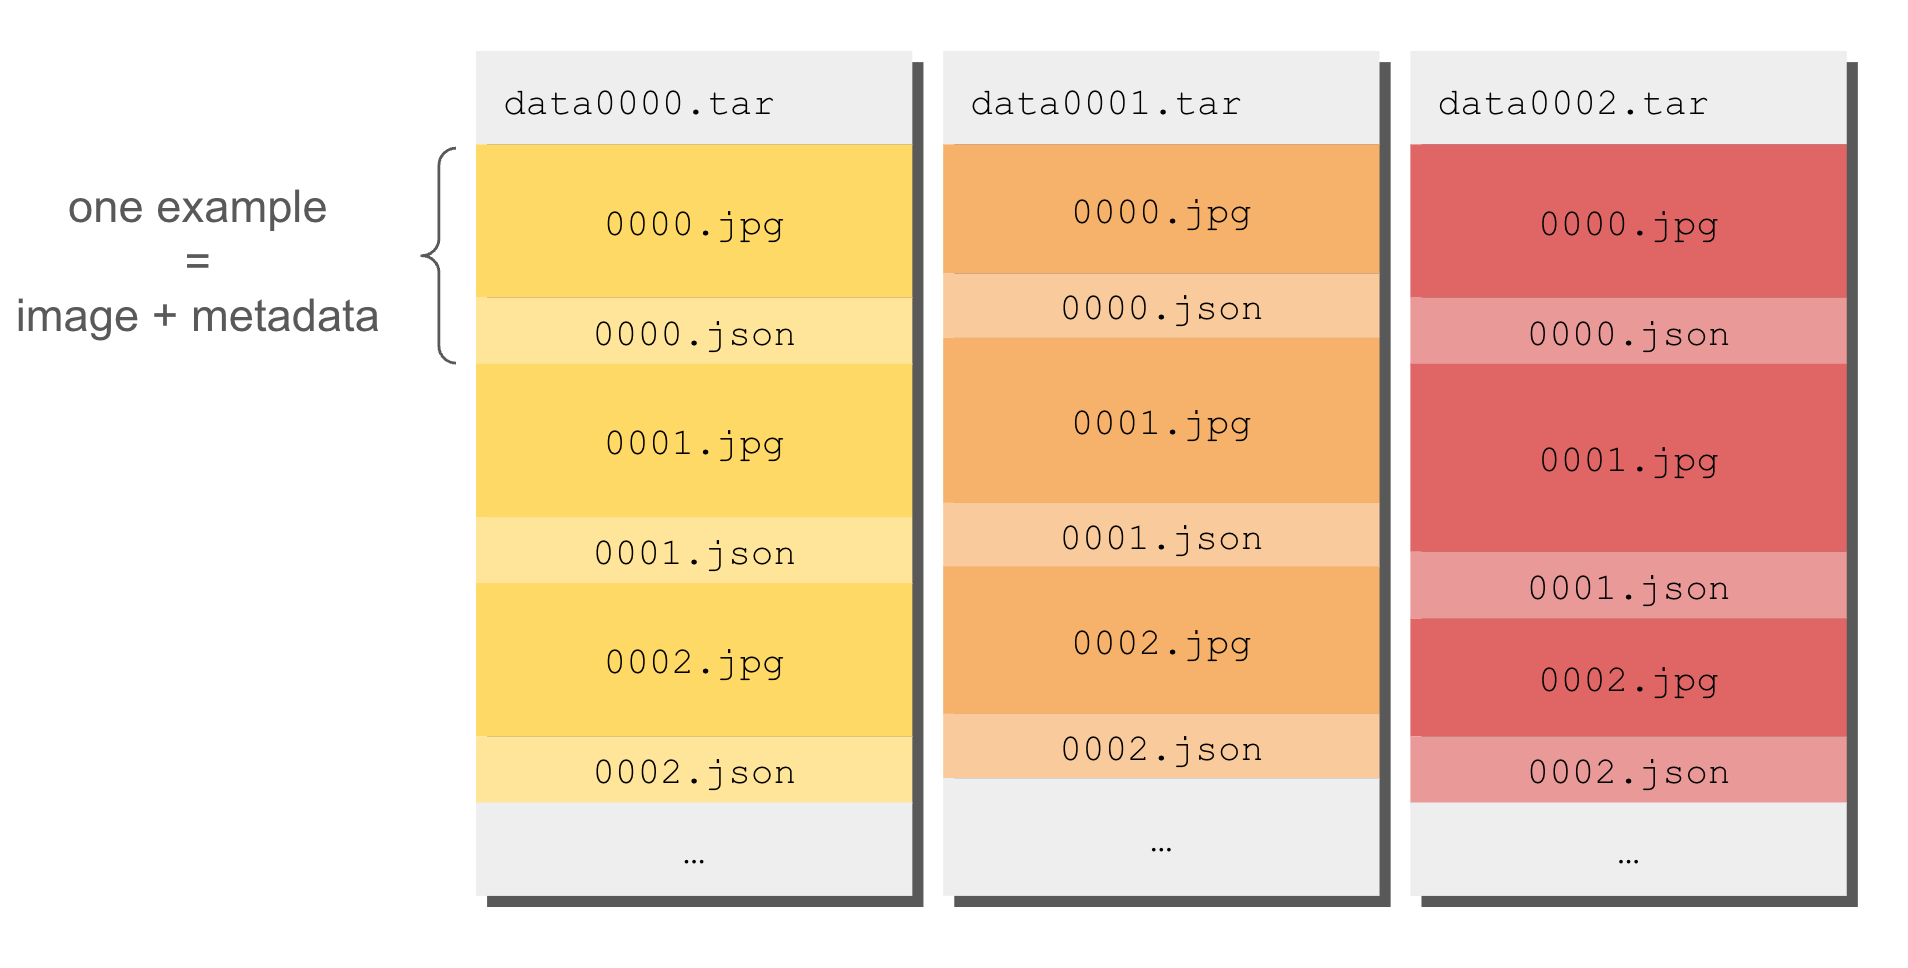

ラベルとメタデータは、.jsonファイル、.txt(キャプションや説明用)、または.cls(クラスインデックス用)に格納できます。
大規模なWebDatasetは、シャードと呼ばれる多数のファイルで構成されており、各シャードはTARアーカイブです。 各シャードは通常約1GBですが、データセット全体は数テラバイトに達する可能性があります!
マルチモーダル対応
WebDatasetは、画像、音声、および/または動画のデータセット、すなわちマルチモーダルデータセットのために設計されています。
実際、メディアファイルは比較的大きくなる傾向があるため、WebDatasetのシーケンシャルI/Oは大きな読み取りとバッファリングを可能にし、最適なデータ読み込み速度を実現します。
サポートされているデータ形式の非網羅的なリストを以下に示します。
- image: jpeg, png, tiff
- audio: mp3, m4a, wav, flac
- video: mp4, mov, avi
- other: npy, npz
完全なリストは時間とともに変化し、実装によって異なります。例えば、webdatasetパッケージがサポートする形式は、ソースコードのこちらで確認できます。
ストリーミング
TARアーカイブのストリーミングは、連続したデータチャンクを読み込むため高速です。 個別のデータファイルを1つずつ読み込む場合と比べて、桁違いに高速になる可能性があります。
WebDatasetのストリーミングは、ディスクからの読み取りとクラウドストレージからの読み取りの両方で高速なパフォーマンスを発揮するため、DataLoaderにデータを供給する形式として最適です:


例えば、Hugging Faceからtimm/imagenet-12k-wdsデータセットを直接ストリーミングする方法は以下の通りです:
まず、Hugging Face アカウントでログインする必要があります。例えば、以下のようにします:
hf auth loginその後、WebDatasetでデータセットをストリーミングできます。
>>> import webdataset as wds
>>> from huggingface_hub import get_token
>>> from torch.utils.data import DataLoader

>>> hf_token = get_token()
>>> url = "https://huggingface.co/datasets/timm/imagenet-12k-wds/resolve/main/imagenet12k-train-{{0000..1023}}.tar"
>>> url = f"pipe:curl -s -L {url} -H 'Authorization:Bearer {hf_token}'"
>>> dataset = wds.WebDataset(url).decode()
>>> dataloader = DataLoader(dataset, batch_size=64, num_workers=4)
シャッフル
一般的に、WebDataset形式のデータセットはすでにシャッフル済みであり、DataLoaderにそのまま供給できます。 ただし、WebDatasetの近似シャッフル機能を使用して、データを再シャッフルすることもできます。
シャードのリストをシャッフルするだけでなく、WebDatasetはバッファを使用して、速度にコストをかけずにデータセットをシャッフルします:


シャード化されたファイルのリストをシャッフルし、シャッフルバッファからランダムにサンプリングするには:
>>> buffer_size = 1000
>>> dataset = (
...     wds.WebDataset(url, shardshuffle=True)
...     .shuffle(buffer_size)
...     .decode()
... )