
Hub documentation
Hugging Face'te 🤗 transformers kullanımı
Hugging Face'te 🤗 transformers kullanımı
🤗 transformers, Hugging Face ve topluluk tarafından sürdürülen; PyTorch, TensorFlow ve JAX için son teknoloji Makine Öğrenimi sunan bir kütüphanedir. Metin, görüntü ve ses gibi farklı modalitelerdeki görevleri gerçekleştirmek için binlerce önceden eğitilmiş model sağlar. Biraz önyargılıyız ama 🤗 transformers'ı gerçekten çok seviyoruz!
Hub'da 🤗 transformers'ı keşfetme
Hub'da, modeller sayfasının solundaki filtreleme özelliğiyle bulabileceğiniz 630.000'den fazla transformers modeli bulunmaktadır.
Birçok farklı görev için modelleri bulabilirsiniz:
- Bir bağlamdan cevabı çıkarma (soru-cevap).
- Büyük bir metinden özetler oluşturma (summarization).
- Metni sınıflandırın (ör. spam veya spam değil, text-classification).
- GPT gibi modellerle yeni bir metin oluşturun (text-generation).
- Bir cümlede söz türlerini (fiil, özne vb.) veya varlıkları (ülke, kuruluş vb.) belirleyin (token-classification).
- Ses dosyalarını metne dönüştürün (automatic-speech-recognition).
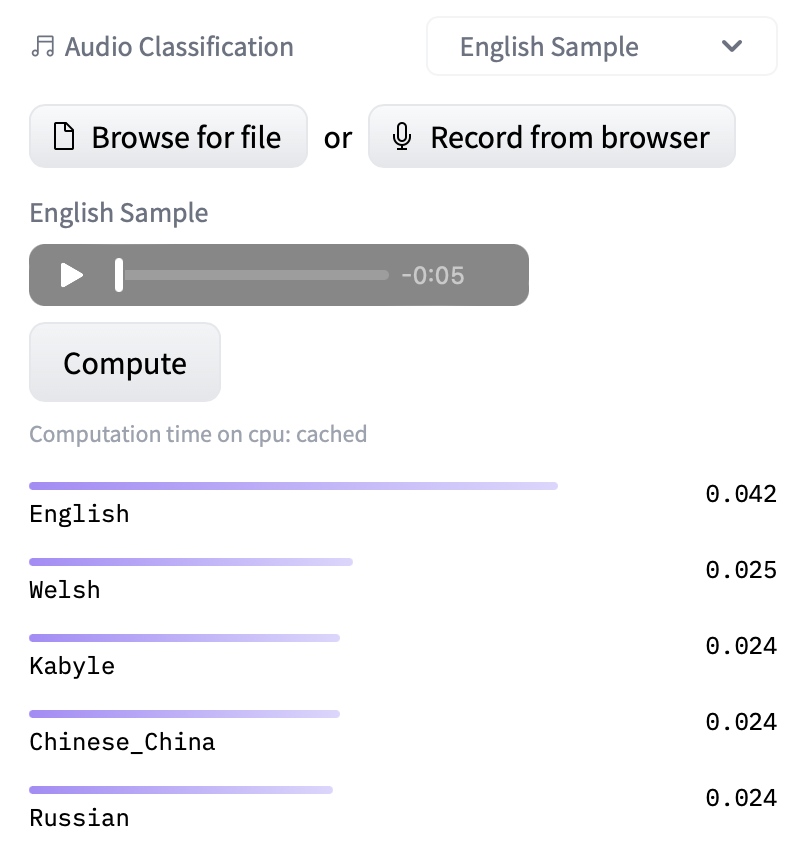
- Bir ses dosyasındaki konuşmacıyı veya dili sınıflandırın (audio-classification).
- Bir görüntüde nesneleri algıla (object-detection).
- Bir görüntüyü segmente edin (image-segmentation).
- Pekiştirmeli Öğrenme (reinforcement-learning) yapın!
Tarayıcı içi widget'ler sayesinde, indirmeden önce modelleri test etmek isterseniz tarayıcıda doğrudan deneyebilirsiniz!
Transformers deposu dosyaları
Bir Transformers model deposu genellikle model dosyaları ve ön işleyici dosyaları içerir.

Model
config.jsondosyası, gizli katman sayısı, sözlük boyutu, dikkat başı sayısı, her başın boyutları gibi model mimarisiyle ilgili ayrıntıları saklar. Bu meta veriler, modelin planıdır.model.safetensorsdosyası, modelin önceden eğitilmiş katmanlarını ve ağırlıklarını saklar. Büyük modeller için, yüklenmesi gereken bellek miktarını sınırlamak amacıyla safetensors dosyası parçalara ayrılır. Model ağırlıklarının hangi safetensors dosyasından yüklendiğini görmek içinmodel.safetensors.index.jsondosyasını inceleyin.{ "metadata": { "total_size": 16060522496 }, "weight_map": { "lm_head.weight": "model-00004-of-00004.safetensors", "model.embed_tokens.weight": "model-00001-of-00004.safetensors", ... } }Model kartındaki ↗ düğmesine tıklayarak bu eşlemeyi görselleştirebilirsiniz.

Safetensors, model ağırlıklarını depolamak için pickle ile karşılaştırıldığında daha güvenli ve hızlı bir seri hale getirme biçimidir. Ağırlıklarla
bin,pthveyackptgibi biçimlerde karşılaşabilirsiniz ancaksafetensors, model ekosisteminde giderek daha iyi bir alternatif olarak benimsenmektedir.Bir model, metin üretiminin nasıl yapılacağına dair ayrıntıları (örneğin örneklemeye gidilip gidilmeyeceği, örneklemenin hangi üst jetonlardan yapılacağı, sıcaklık ve üretimi başlatmak/durdurmak için kullanılan özel jetonlar) saklayan bir
generation_config.jsondosyasına da sahip olabilir.
Önişleyici
tokenizer_config.jsondosyası, bir modelin eklediği özel jetonları saklar. Bu özel jetonlar, bir modele cümlenin başlangıcı, sohbet şablonları için belirli biçimlendirme veya bir görüntüyü belirtme gibi birçok şeyi iletir. Bu dosya ayrıca, modelin kabul edebileceği maksimum giriş dizisi uzunluğunu, ön işleyici sınıfını ve döndürdüğü çıktıları da gösterir.tokenizer.jsondosyası, modelin öğrenmiş olduğu sözlüğü saklar.special_tokens_map.json, özel jetonların eşlemesidir. Örneğin, Llama 3.1-8B-Instruct'te başlangıç jetonu"<|begin_of_text|>"'dür.
Diğer modaliteler için
tokenizer_config.jsondosyası yerinepreprocessor_config.jsonkullanılır.
Mevcut modelleri kullanma
Tüm transformer modelleri kullanıma bir satır uzaklıkta! Kullanım amacınıza bağlı olarak, yüksek seviyeli API'yi pipeline işleviyle kullanabilir veya daha fazla kontrol için AutoModel kullanabilirsiniz.
# With pipeline, just specify the task and the model id from the Hub.
from transformers import pipeline
pipe = pipeline("text-generation", model="distilbert/distilgpt2")

# If you want more control, you will need to define the tokenizer and model.
from transformers import AutoTokenizer, AutoModelForCausalLM
tokenizer = AutoTokenizer.from_pretrained("distilbert/distilgpt2")
model = AutoModelForCausalLM.from_pretrained("distilbert/distilgpt2")
Belirli bir sürümden (commit hash, etiket adı veya dal bazında) bir model yüklemek için aşağıdaki gibi yapabilirsiniz:
model = AutoModel.from_pretrained(
    "julien-c/EsperBERTo-small", revision="v2.0.1"  # tag name, or branch name, or commit hash
)
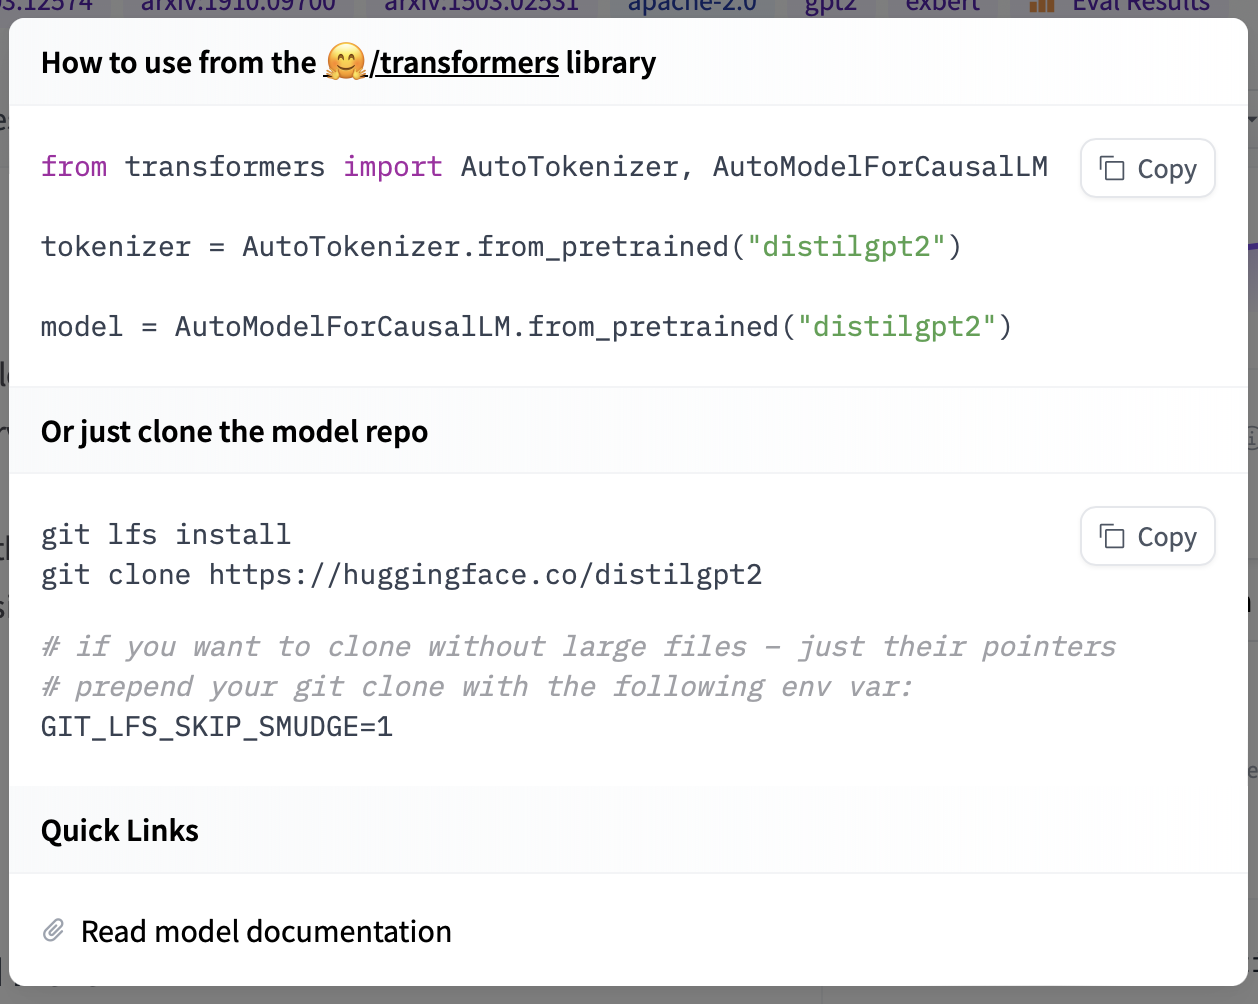
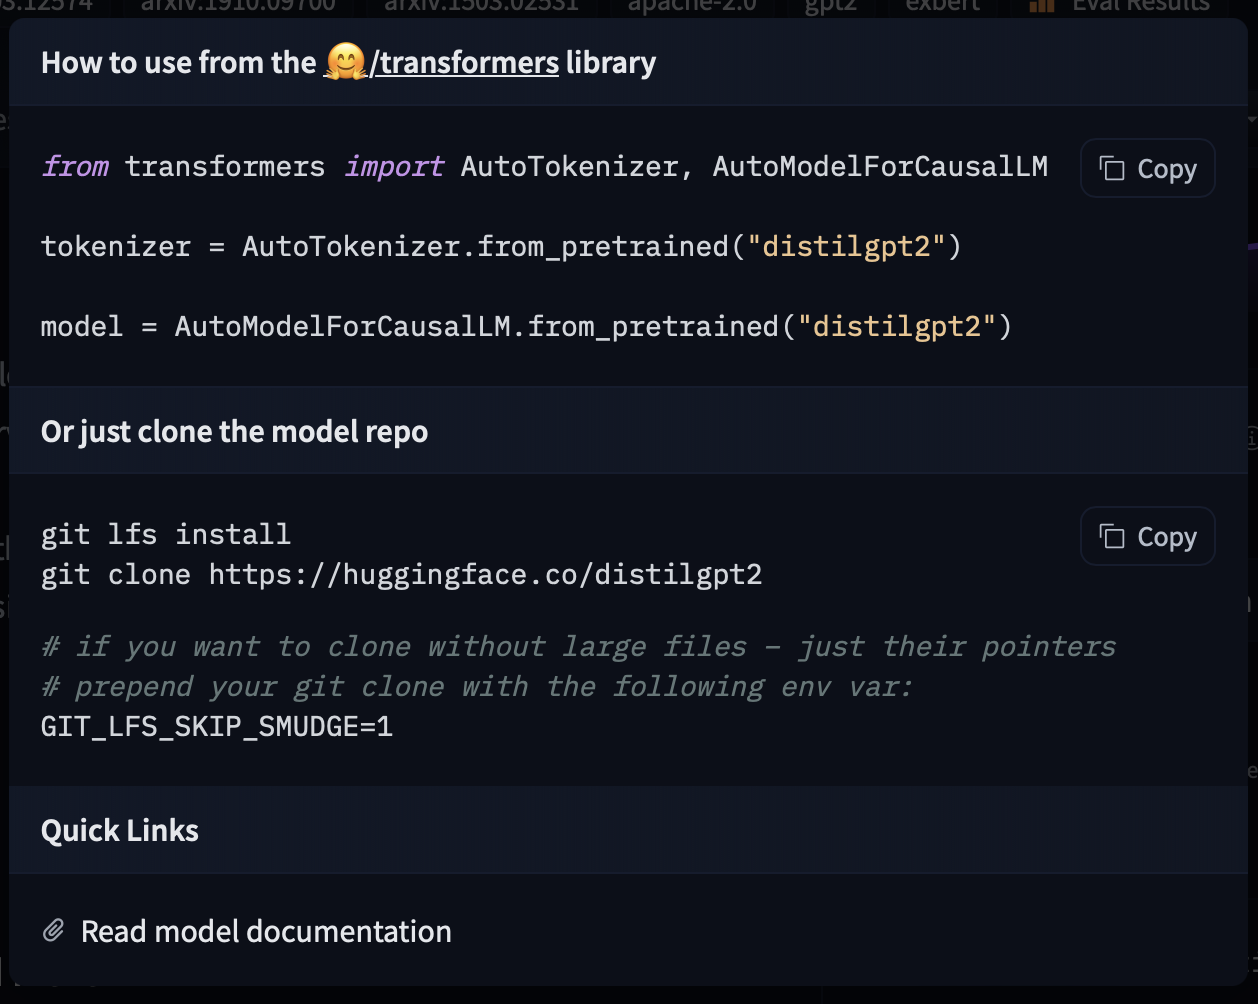
Belirli bir modelin nasıl yükleneceğini görmek istiyorsanız, Use in Transformers bağlantısına tıklayabilir ve modelinizi yüklemek için kullanabileceğiniz çalışan bir kod parçası alabilirsiniz. Model mimarisi hakkında daha fazla bilgiye ihtiyacınız varsa, kod parçasının altındaki “Read model documentation” bağlantısına da tıklayabilirsiniz.
Modellerinizi paylaşma
transformers ile modelleri paylaşma hakkında her şeyi okumak için lütfen resmi dokümantasyondaki Bir model paylaş kılavuzuna gidin.
transformers içindeki modeller ve tokenizörler gibi birçok sınıf, dosyaları bir depoya kolayca yüklemeye olanak tanıyan bir push_to_hub yöntemine sahiptir.
# Pushing model to your own account
model.push_to_hub("my-awesome-model")

# Pushing your tokenizer
tokenizer.push_to_hub("my-awesome-model")

# Pushing all things after training
trainer.push_to_hub()
Yapabilecekleriniz çok daha fazla olduğundan, Bir model paylaş kılavuzunu incelemenizi öneririz.
Ek kaynaklar
- Transformers kütüphanesi.
- Transformers belgeleri.
- Bir model kılavuzu paylaşın.