
Hub documentation
DuckDB
DuckDB
DuckDB là hệ thống quản lý cơ sở dữ liệu SQL OLAP chạy trong tiến trình.
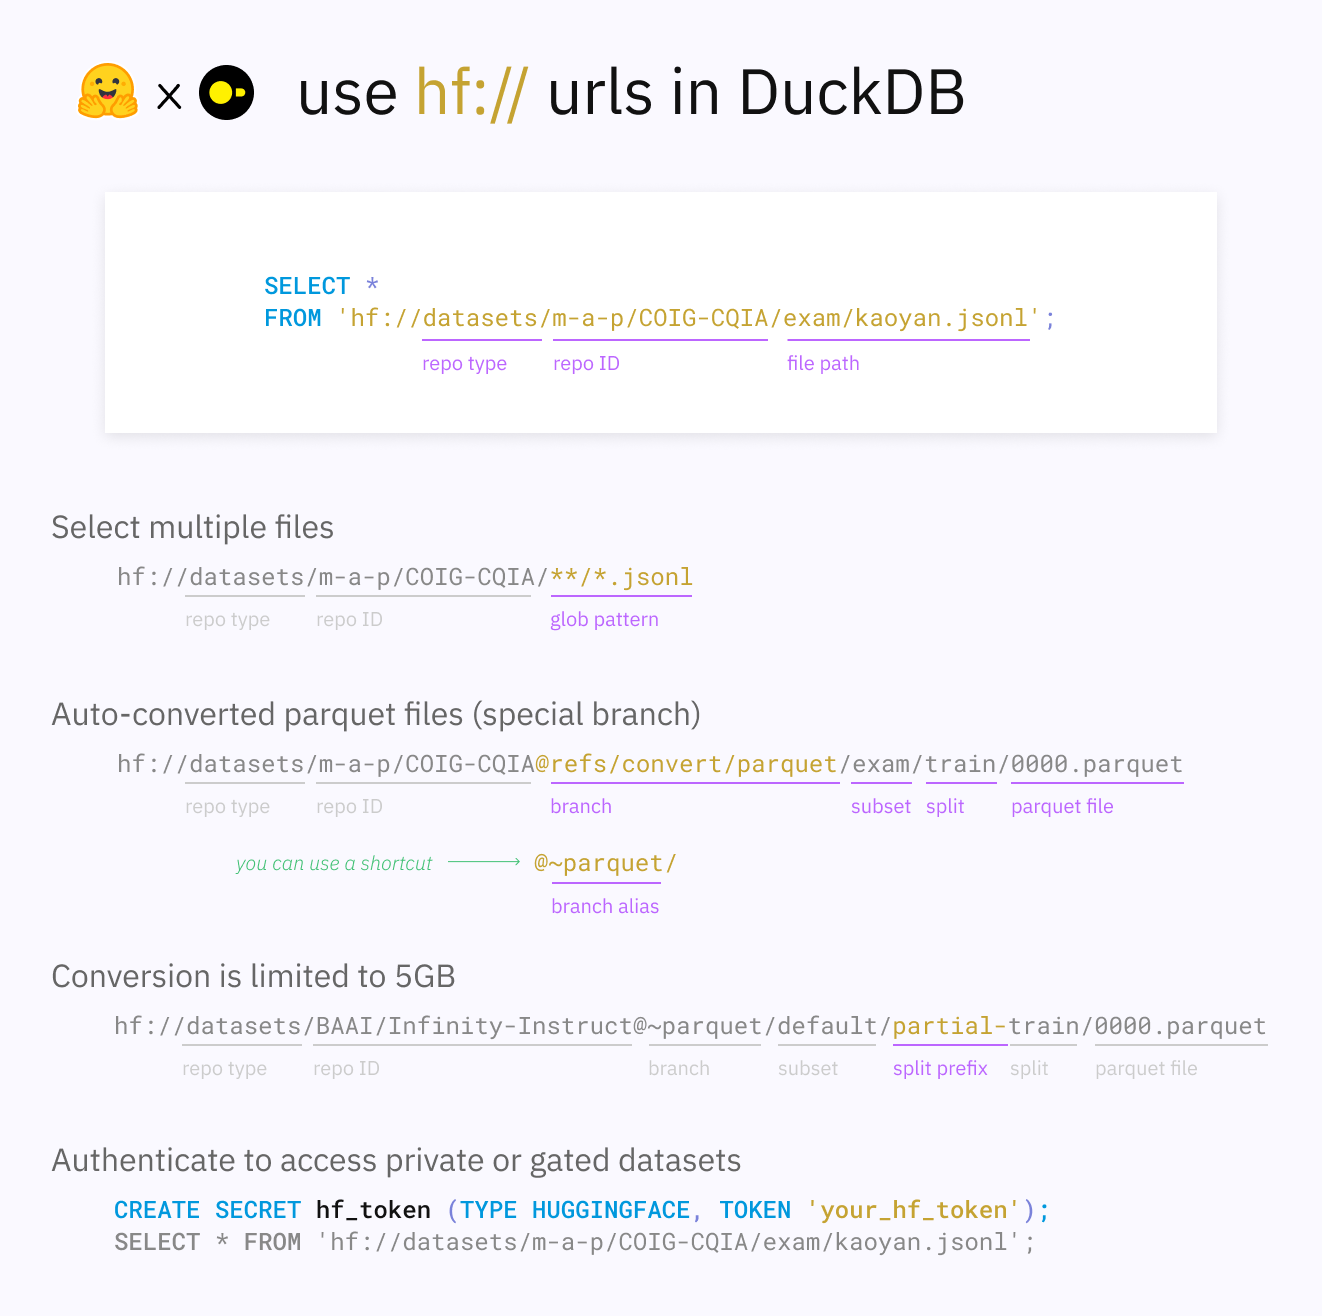
Bạn có thể sử dụng đường dẫn Hugging Face (hf://) để truy cập dữ liệu trên Hub:
DuckDB CLI (Giao diện dòng lệnh) là một tệp thực thi đơn lẻ, không phụ thuộc vào thư viện bên ngoài. Ngoài ra còn có các API khác để chạy DuckDB, bao gồm Python, C++, Go, Java, Rust và nhiều hơn nữa. Để biết thêm chi tiết, hãy truy cập trang clients của họ.
Để biết chi tiết cài đặt, hãy truy cập trang cài đặt.
Nếu bạn sử dụng CLI
hf, bạn có thể chạy các truy vấn DuckDB trực tiếp bằnghf datasets sql, ví dụhf datasets sql "FROM 'hf://datasets/ibm/duorc/ParaphraseRC/*.parquet' LIMIT 3". Xác thực cho các dataset có cổng và riêng tư được cấu hình tự động từ token đã đăng nhập của bạn, và--format jsontrả về đầu ra có thể đọc được bằng máy.
Bắt đầu từ phiên bản v0.10.3, DuckDB CLI bao gồm hỗ trợ native để truy cập các dataset trên Hugging Face Hub thông qua các URL có scheme hf://. Dưới đây là một số tính năng bạn có thể tận dụng với công cụ mạnh mẽ này:
- Truy vấn các bộ dữ liệu công khai cũng như các bộ dữ liệu có kiểm soát và riêng tư của bạn
- Phân tích bộ dữ liệu và thực hiện các thao tác SQL
- Kết hợp các bộ dữ liệu và xuất chúng sang các định dạng khác nhau
- Thực hiện tìm kiếm tương tự vector trên các bộ dữ liệu nhúng
- Triển khai tìm kiếm toàn văn trên các bộ dữ liệu
Để xem danh sách đầy đủ các tính năng của DuckDB, hãy truy cập tài liệu của DuckDB.
Để khởi động CLI, hãy thực hiện lệnh sau trong thư mục cài đặt:
./duckdb
Xây dựng URL của Hugging Face
Để truy cập các bộ dữ liệu Hugging Face, hãy sử dụng định dạng URL sau:
hf://datasets/{my-username}/{my-dataset}/{path_to_file} - my-username, người dùng hoặc tổ chức của bộ dữ liệu, ví dụ
ibm - my-dataset, tên bộ dữ liệu, ví dụ:
duorc - path_to_parquet_file, đường dẫn tệp parquet hỗ trợ các mẫu glob, ví dụ
**/*.parquet, để truy vấn tất cả các tệp parquet
Bạn có thể truy vấn các tệp Parquet được chuyển đổi tự động bằng nhánh @~parquet, tương ứng với bản sửa đổi
refs/convert/parquet. Để biết thêm chi tiết, hãy tham khảo tài liệu tại https://huggingface.co/docs/datasets-server/en/parquet#conversion-to-parquet.Để tham chiếu đến bản sửa đổi
refs/convert/parquetcủa một tập dữ liệu, hãy sử dụng cú pháp sau:hf://datasets/{my-username}/{my-dataset}@~parquet/{path_to_file}Dưới đây là một URL mẫu tuân theo cú pháp ở trên:
hf://datasets/ibm/duorc@~parquet/ParaphraseRC/test/0000.parquet
Truy vấn một tập dữ liệu
Hãy bắt đầu với một demo nhanh để truy vấn tất cả các hàng của một tập dữ liệu:
FROM 'hf://datasets/ibm/duorc/ParaphraseRC/*.parquet' LIMIT 3;Hoặc sử dụng cú pháp SQL truyền thống:
SELECT * FROM 'hf://datasets/ibm/duorc/ParaphraseRC/*.parquet' LIMIT 3;Trong các phần tiếp theo, chúng ta sẽ tìm hiểu các thao tác phức tạp hơn mà bạn có thể thực hiện với DuckDB trên các bộ dữ liệu của Hugging Face.
Truy vấn Storage Buckets: DuckDB 2.0 trở lên cũng đọc Storage Buckets một cách bản địa, từ CLI và mọi client:
SELECT * FROM 'hf://buckets/username/my-bucket/data.parquet' LIMIT 10;Buckets không được phiên bản hóa, nên cú pháp
@revisionkhông áp dụng cho đường dẫn bucket. Trên DuckDB 1.x, hãy đăng ký hệ thống tệp Hugging Face từ Python thay thế:duckdb.register_filesystem(HfFileSystem()). Xem Truy vấn với DuckDB để biết chi tiết.
Lưu một tập dữ liệu
Sử dụng cú pháp COPY ... TO để lưu bộ dữ liệu vào Hugging Face.
- Cài đặt extension cho DuckDB >=2.0:
SET allow_extension_repositories = 'allowed';
CREATE OR REPLACE EXTENSION REPOSITORY hf_repo
  WITH PREFIX 'https://hf.co/buckets/duckdb-extensions/builds/resolve';
INSTALL hf FROM hf_repo;
LOAD hf FROM hf_repo;- Xác thực bằng CLI
hfhoặc trực tiếp trong DuckDB:
Trong CLI:
hf auth login
Trong DuckDB:
CREATE SECRET (TYPE HUGGINGFACE, TOKEN 'hf_...');
- Tạo kho dữ liệu của bạn nếu nó chưa tồn tại:
Trong CLI:
hf repos create username/my-dataset --repo-type dataset --private
Trong DuckDB:
FROM hf_create_repo('hf://datasets/username/my-dataset', private := true);
- Xuất bảng của bạn lên Hugging Face, ví dụ ở định dạng Parquet:
COPY tbl TO 'hf://datasets/username/my-dataset/out.parquet';Sử dụng
PARTITION_BYđể chia bảng thành nhiều tệp dựa trên khóa phân vùng:COPY tbl TO 'hf://datasets/username/my-dataset/out-directory' (FORMAT parquet, PARTITION_BY (year, month));. Các tệp sẽ được đặt trong thư mục con tương ứng dựa trên giá trị của khóa phân vùng, ví dụ'hf://datasets/username/my-dataset/out-directory/year=2026/month=1/data_1.parquet'.
Vì các dataset là các kho git, nên mỗi tệp mới là một commit trong lịch sử của dataset.
Update on GitHub