
Transformers documentation
Démarrage rapide
Démarrage rapide
Transformers est conçu pour être rapide et facile à utiliser, afin que chacun puisse commencer à apprendre ou à développer avec des modèles de type transformer.
Le nombre d’abstractions destinées aux utilisateurs est limité à trois classes pour l’instanciation d’un modèle et à deux API pour l’inférence ou l’entraînement. Cette introduction rapide vous présente les fonctionnalités clés de Transformers et vous montre comment :
Configuration
Pour commencer, nous vous recommandons de créer un compte Hugging Face. Un compte vous permet d'héberger et d'accéder à des modèles, des jeux de données et des Spaces sous contrôle de version sur le Hub Hugging Face, une plateforme collaborative de découverte et de création.
Créez un User Access Token et connectez-vous à votre compte.
Collez votre User Access Token dans notebook_login lorsque l’authentification est demandée.
from huggingface_hub import notebook_login

notebook_login()
Vérifiez que le package huggingface_hub[cli] est installé, puis exécutez la commande ci-dessous. Collez votre User Access Token lorsque le système vous y invite pour vous connecter.
hf auth login
Installer PyTorch.
# remove ! if installing from the CLI
!pip install torch
Installez ensuite une version à jour de Transformers ainsi que quelques bibliothèques supplémentaires de l'écosystème Hugging Face pour accéder aux jeux de données et aux modèles de vision, évaluer l'entraînement et optimiser l'entraînement pour les grands modèles.
# remove ! if installing from the CLI
!pip install -U transformers datasets evaluate accelerate timm
Compétences des agents
Hugging Face Skills apprennent à votre agent de codage à travailler avec Transformers. Plutôt que de rédiger vous-même un script d'entraînement, demandez à votre agent d'effectuer un fine-tuning d'un modèle de vision et laissez la skill le guider.
/plugin marketplace add huggingface/skills
/plugin install hf-cli@huggingface/skills
codex plugin marketplace add huggingface/skills
Puis exécutez /plugins dans Codex et installez une compétence depuis le dépôt huggingface/skills.
Consultez le guide Installation pour découvrir d'autres plateformes prises en charge, telles que Cursor et Gemini.
Une fois une compétence installée, incluez-la dans vos instructions à votre agent de codage.
Use the HF Trainer skill to fine-tune RT-DETRv2 on [Lekim89/sportsmot](https://huggingface.co/datasets/Lekim89/sportsmot) for basketball player tracking.Modèles pré-entraînés
Chaque modèle pré-entraité hérite de trois classes de base.
| Classe | Description |
|---|---|
| PreTrainedConfig | Un fichier qui spécifie les attributs d’un modèle, tels que le nombre de têtes d’attention ou la taille du vocabulaire. |
| PreTrainedModel | Un modèle (ou une architecture) défini par les attributs du modèle issus du fichier de configuration. Un modèle pré-entraîné ne renvoie que les états cachés bruts. Pour une tâche spécifique, utilisez la tête de modèle appropriée pour convertir les états cachés bruts en un résultat significatif (par exemple, LlamaModel par rapport à LlamaForCausalLM). |
| Préprocesseur | Une classe permettant de convertir des entrées brutes (texte, images, audio, multimodal) en entrées numériques pour le modèle. Par exemple, PreTrainedTokenizer convertit le texte en tenseurs et ImageProcessingMixin convertit les pixels en tenseurs. |
Nous recommandons d’utiliser l’API AutoClass pour charger les modèles et les préprocesseurs, car elle infère automatiquement l’architecture appropriée pour chaque tâche et chaque framework d’apprentissage automatique, en se basant sur le nom ou le chemin des poids préentraînés et du fichier de configuration.
Utilisez from_pretrained() pour charger les poids et le fichier de configuration depuis le Hub dans la classe du modèle et du préprocesseur.
Lors du chargement d'un modèle, configurez les paramètres suivants pour vous assurer que le modèle est chargé de manière optimale.
device_map="auto"alloue automatiquement les poids du modèle à votre appareil le plus rapide en premier.dtype="auto"initialise directement les poids du modèle dans le type de données dans lequel ils sont stockés, ce qui peut aider à éviter de charger les poids deux fois (PyTorch charge les poids entorch.float32par défaut).
from transformers import AutoModelForCausalLM, AutoTokenizer

model = AutoModelForCausalLM.from_pretrained("meta-llama/Llama-2-7b-hf", dtype="auto", device_map="auto")
tokenizer = AutoTokenizer.from_pretrained("meta-llama/Llama-2-7b-hf")
Tokenisez le texte et retournez des tenseurs PyTorch avec le tokenizer. Déplacez les entrées tokenisées sur le même appareil que le modèle avant d'exécuter l'inférence afin que le modèle puisse les traiter.
model_inputs = tokenizer(["The secret to baking a good cake is "], return_tensors="pt").to(model.device)Le modèle est maintenant prêt pour l'inférence ou l'entraînement.
Pour l'inférence, passez les entrées tokenisées à generate() pour générer du texte. Décodez les identifiants de jetons en texte à l'aide de batch_decode().
generated_ids = model.generate(**model_inputs, max_length=30)
tokenizer.batch_decode(generated_ids)[0]
'<s> The secret to baking a good cake is 100% in the preparation. There are so many recipes out there,'
Passez directement à la section Trainer pour apprendre à affiner un modèle.
Pipeline
La classe Pipeline est la méthode la plus pratique pour effectuer de l’inférence avec un modèle préentraîné. Elle prend en charge de nombreuses tâches, telles que la génération de texte, la segmentation d’images, la reconnaissance automatique de la parole, la réponse à des questions sur des documents, et bien d’autres.
Reportez-vous à la référence de l'API Pipeline pour obtenir la liste complète des tâches disponibles.
Créez un objet Pipeline et sélectionnez une tâche. Par défaut, Pipeline télécharge et met en cache un modèle pré-entraîné par défaut pour une tâche donnée. Transmettez le nom du modèle au paramètre model pour choisir un modèle spécifique.
Utilisez Accelerator pour détecter automatiquement un accélérateur disponible pour l'inférence.
from transformers import pipeline
from accelerate import Accelerator

device = Accelerator().device

pipe = pipeline("text-generation", model="meta-llama/Llama-2-7b-hf", device=device)
Prompt Pipeline avec un texte initial pour générer plus de texte.
pipe("The secret to baking a good cake is ", max_length=50)
[{'generated_text': 'The secret to baking a good cake is 100% in the batter. The secret to a great cake is the icing.\nThis is why we’ve created the best buttercream frosting reci'}]
Utilisez Accelerator pour détecter automatiquement un accélérateur disponible pour l'inférence.
from transformers import pipeline
from accelerate import Accelerator

device = Accelerator().device

pipeline = pipeline("image-segmentation", model="facebook/detr-resnet-50-panoptic", device=device)
Passez une image — une URL ou un chemin local vers l’image — à Pipeline.
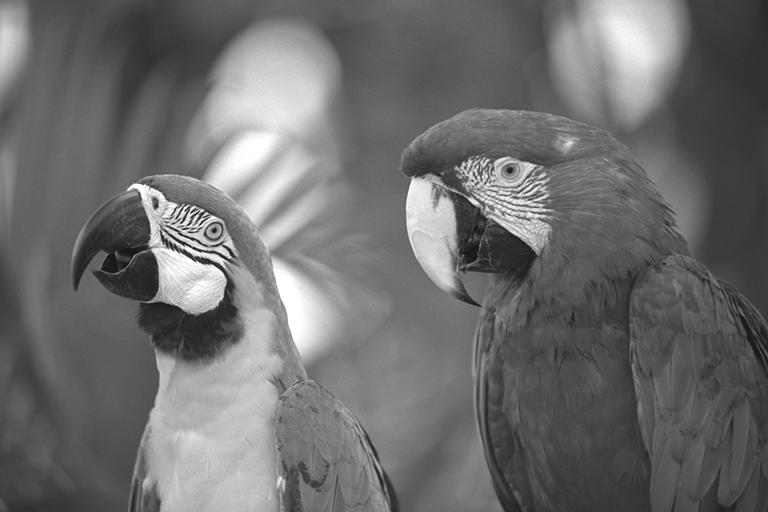
segments = pipeline("https://huggingface.co/datasets/Narsil/image_dummy/raw/main/parrots.png")
segments[0]["label"]
'bird'
segments[1]["label"]
'bird'
Utilisez Accelerator pour détecter automatiquement un accélérateur disponible pour l'inférence.
from transformers import pipeline
from accelerate import Accelerator

device = Accelerator().device

pipeline = pipeline("automatic-speech-recognition", model="openai/whisper-large-v3", device=device)
Transmettez un fichier audio à Pipeline.
pipeline("https://huggingface.co/datasets/Narsil/asr_dummy/resolve/main/1.flac")
{'text': ' He hoped there would be stew for dinner, turnips and carrots and bruised potatoes and fat mutton pieces to be ladled out in thick, peppered flour-fatten sauce.'}
Trainer
Trainer est une boucle complète d’entraînement et d’évaluation pour les modèles PyTorch. Il abstrait une grande partie du code répétitif généralement nécessaire pour écrire manuellement une boucle d’entraînement, vous permettant ainsi de démarrer l’entraînement plus rapidement et de vous concentrer sur les choix de conception de l’entraînement. Il vous suffit d’un modèle, d’un jeu de données, d’un préprocesseur et d’un collateur de données pour construire des lots de données à partir du jeu de données.
Utilisez la classe TrainingArguments pour personnaliser le processus d’entraînement. Elle propose de nombreuses options pour l’entraînement, l’évaluation et plus encore. Expérimentez avec les hyperparamètres et les fonctionnalités d’entraînement, tels que la taille du lot, le taux d’apprentissage, la précision mixte, torch.compile, etc., afin de répondre à vos besoins. Vous pouvez également utiliser les paramètres d’entraînement par défaut pour obtenir rapidement une référence de base.
Charger un modèle, un tokeniseur et un jeu de données pour l'entraînement.
from transformers import AutoModelForSequenceClassification, AutoTokenizer
from datasets import load_dataset

model = AutoModelForSequenceClassification.from_pretrained("distilbert/distilbert-base-uncased")
tokenizer = AutoTokenizer.from_pretrained("distilbert/distilbert-base-uncased")
dataset = load_dataset("cornell-movie-review-data/rotten_tomatoes")
Créez une fonction pour tokeniser le texte et le convertir en tenseurs PyTorch. Appliquez cette fonction à l'ensemble du jeu de données à l'aide de la méthode map.
def tokenize_dataset(dataset):
    return tokenizer(dataset["text"])
dataset = dataset.map(tokenize_dataset, batched=True)
Chargez un collateur de données pour créer des lots de données et passez-lui le tokeniseur.
from transformers import DataCollatorWithPadding

data_collator = DataCollatorWithPadding(tokenizer=tokenizer)
Ensuite, configurez TrainingArguments avec les fonctionnalités d'entraînement et les hyperparamètres.
from transformers import TrainingArguments

training_args = TrainingArguments(
    output_dir="distilbert-rotten-tomatoes",
    learning_rate=2e-5,
    per_device_train_batch_size=8,
    per_device_eval_batch_size=8,
    num_train_epochs=2,
    push_to_hub=True,
)
Enfin, passez tous ces composants distincts à Trainer et appelez train() pour démarrer.
from transformers import Trainer

trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=dataset["train"],
    eval_dataset=dataset["test"],
    processing_class=tokenizer,
    data_collator=data_collator,
)

trainer.train()
Partagez votre modèle et votre tokenizer sur le Hub avec push_to_hub().
trainer.push_to_hub()
Félicitations, vous venez d'entraîner votre premier modèle avec Transformers !
Étapes suivantes
Maintenant que vous avez une meilleure compréhension de Transformers et de ce qu’il propose, il est temps de continuer à explorer et à apprendre ce qui vous intéresse le plus.
- Classes de base : En savoir plus sur les classes de configuration, de modèle et de processeur. Cela vous aidera à comprendre comment créer et personnaliser des modèles, prétraiter différents types d'entrées (audio, images, multimodal) et comment partager votre modèle.
- Inférence : Approfondissez l'exploration du Pipeline, l'inférence et la conversation avec des LLM, des agents, ainsi que les méthodes pour optimiser l'inférence avec votre framework d'apprentissage automatique et votre matériel.
- Entraînement : Étudiez en détail le Trainer, ainsi que l'entraînement distribué et l'optimisation de l'entraînement sur du matériel spécifique.
- Quantification : Réduisez les besoins en mémoire et en stockage grâce à la quantification et accélérez l'inférence en représentant les poids avec moins de bits.
- Ressources : Vous cherchez des recettes de bout en bout pour savoir comment entraîner et effectuer des inférences avec un modèle pour une tâche spécifique ? Consultez les recettes par tâche !