
Transformers documentation
Pembuatan mask
Pembuatan mask
Mask generation adalah tugas untuk menghasilkan mask yang bermakna secara semantik untuk sebuah gambar. Tugas ini sangat mirip dengan segmentasi gambar, tetapi terdapat banyak perbedaan. Model segmentasi gambar dilatih pada dataset berlabel dan terbatas pada kelas-kelas yang telah mereka lihat selama pelatihan; mereka mengembalikan seperangkat mask beserta kelas yang bersesuaian, diberikan sebuah gambar.
Model generasi mask dilatih pada sejumlah besar data dan beroperasi dalam dua mode.
- Mode prompting: Pada mode ini, model menerima gambar dan prompt, di mana prompt dapat berupa lokasi titik 2D (koordinat XY) di dalam objek pada gambar atau kotak pembatas (bounding box) yang mengelilingi objek. Pada mode prompting, model hanya mengembalikan mask di atas objek yang ditunjuk oleh prompt.
- Mode Segment Everything: Pada segment everything, diberikan sebuah gambar, model menghasilkan semua mask dalam gambar tersebut. Untuk melakukannya, sebuah grid titik dihasilkan dan ditumpangkan pada gambar untuk inferensi.
- Inferensi Video: Model menerima sebuah video, serta prompt berupa titik atau kotak pada bingkai video, yang kemudian dilacak sepanjang video. Anda dapat memperoleh informasi lebih lanjut tentang cara melakukan inferensi video dengan mengikuti dokumentasi SAM 2.
Tugas pembuatan mask didukung oleh Segment Anything Model (SAM) dan Segment Anything Model 2 (SAM2), sedangkan inferensi video didukung oleh Segment Anything Model 2 (SAM2). SAM adalah model yang kuat yang terdiri dari encoder gambar berbasis Vision Transformer, prompt encoder, dan mask decoder transformer dua arah. Gambar dan prompt di-encode, kemudian decoder mengambil embedding tersebut dan menghasilkan mask yang valid. Sementara itu, SAM 2 memperluas SAM dengan menambahkan modul memori untuk melacak mask.
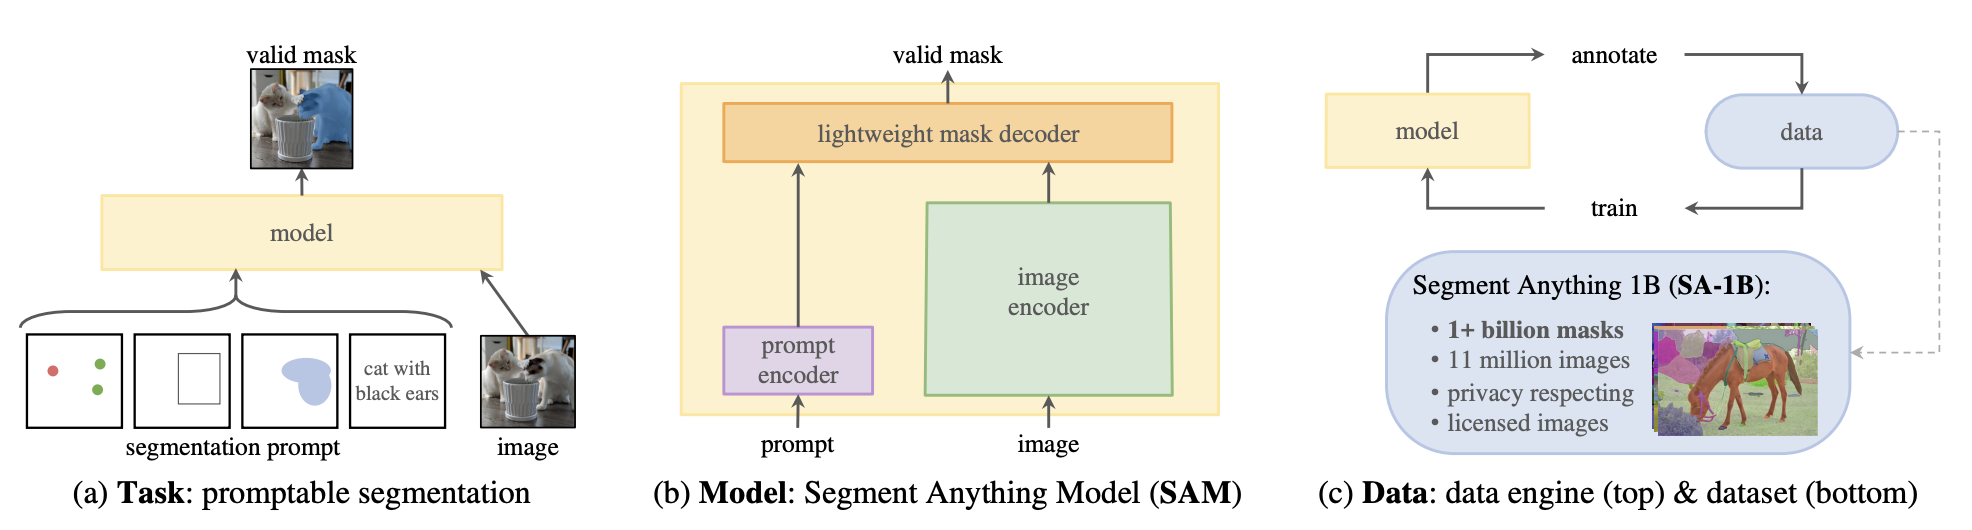
SAM berfungsi sebagai model fondasi yang kuat untuk segmentasi karena cakupan datanya yang luas. Model ini dilatih pada SA-1B, sebuah dataset yang berisi 1 juta gambar dan 1,1 miliar mask.
Dalam panduan ini, Anda akan belajar cara:
- Lakukan inferensi dalam mode segmentasi semua objek dengan batching,
- Lakukan infer dalam mode prompting titik,
- Lakukan inferensi dalam mode prompting in-box.
Pertama, mari kita instal transformers:
pip install -q transformers
Pipeline Pembuatan Mask
Cara termudah untuk melakukan inferensi pada model generasi mask adalah dengan menggunakan pipeline mask-generation.
>>> from transformers import pipeline

>>> checkpoint = "facebook/sam2-hiera-base-plus"
>>> mask_generator = pipeline(model=checkpoint, task="mask-generation")
Mari kita lihat gambar tersebut.
from PIL import Image
import requests

img_url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/bee.jpg"
image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")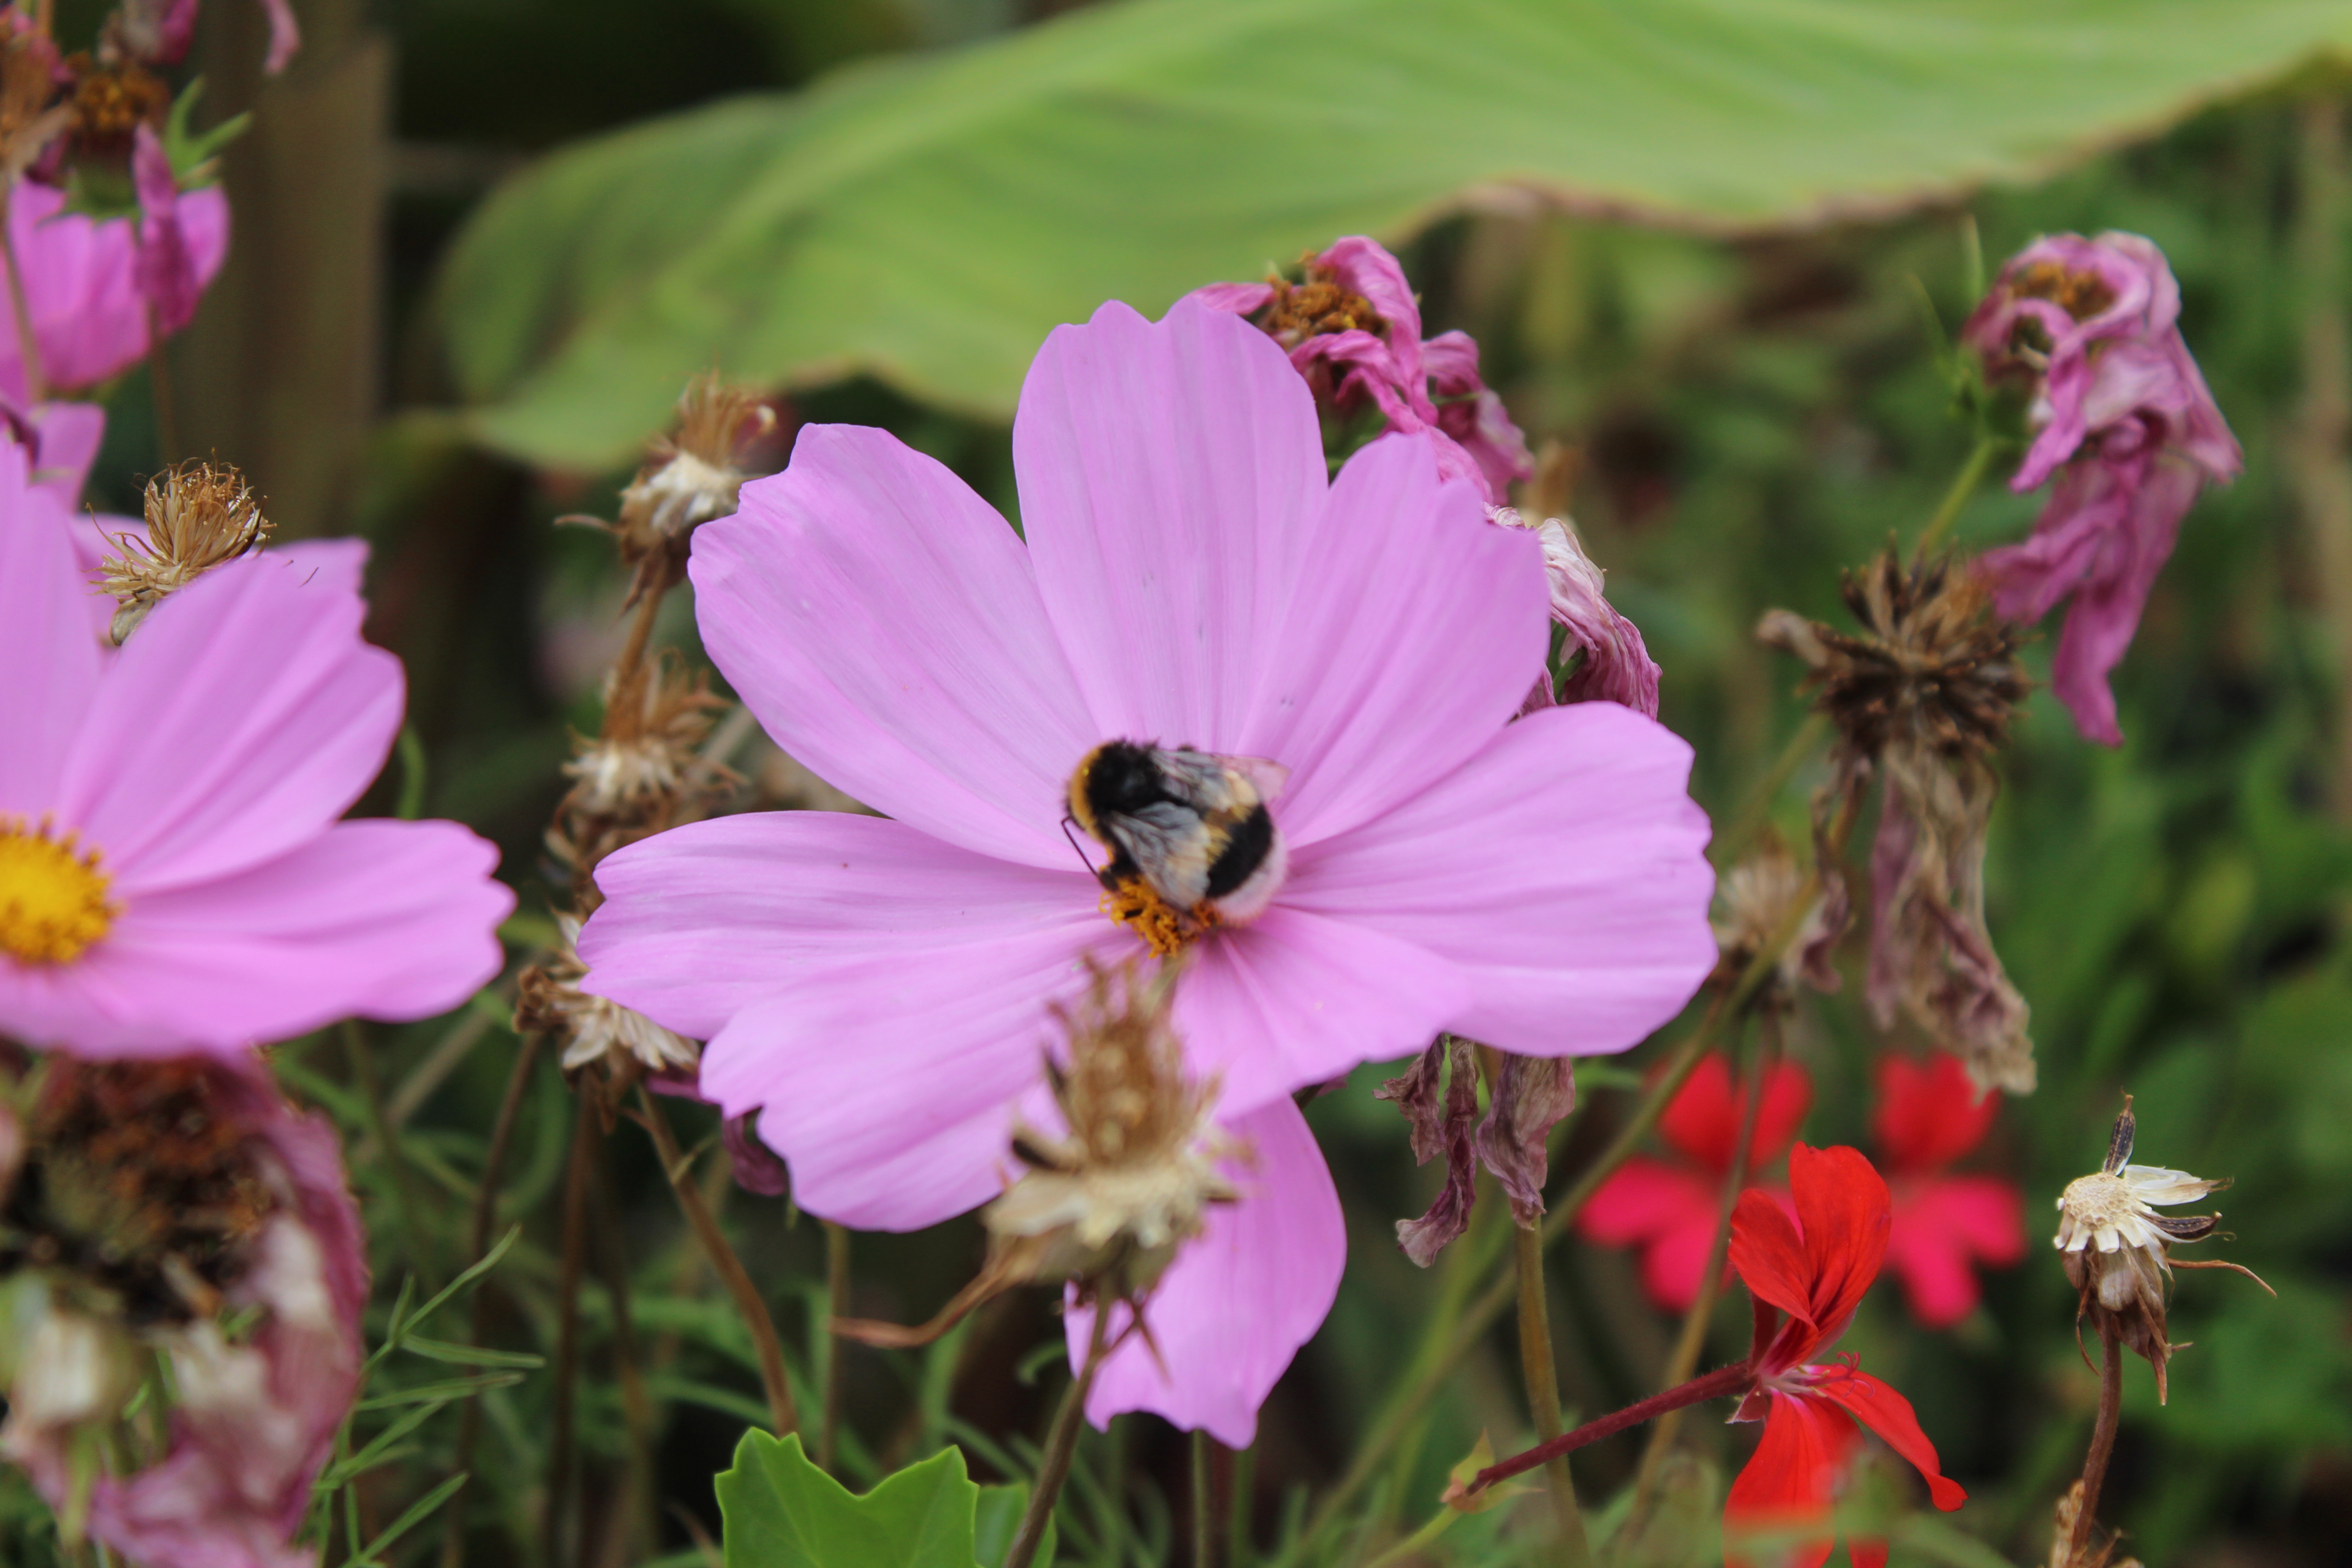
Mari kita segmentasikan semuanya. points-per-batch memungkinkan inferensi paralel dari titik-titik dalam mode segment everything. Hal ini memungkinkan inferensi yang lebih cepat, tetapi mengonsumsi lebih banyak memori. Selain itu, SAM hanya memungkinkan batching pada titik-titik, bukan pada gambar. pred_iou_thresh adalah ambang batas kepercayaan IoU, di mana hanya mask yang berada di atas ambang batas tertentu yang dikembalikan.
masks = mask_generator(image, points_per_batch=128, pred_iou_thresh=0.88)masks terlihat seperti berikut:
{'masks': [tensor([[False, False, False,  ...,  True,  True,  True],
          [False, False, False,  ...,  True,  True,  True],
          [False, False, False,  ...,  True,  True,  True],
          ...,
          [False, False, False,  ..., False, False, False], ..
 'scores': tensor([0.9874, 0.9793, 0.9780, 0.9776, ... 0.9016])}
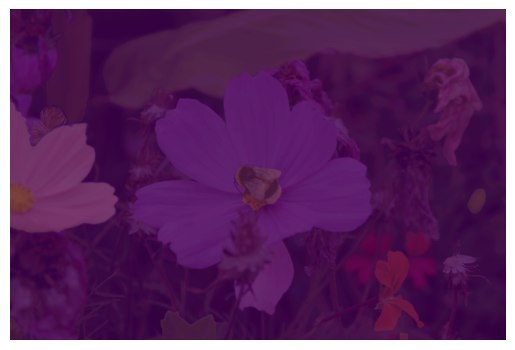
Kita dapat memvisualisasikannya seperti ini:
import matplotlib.pyplot as plt

plt.imshow(image, cmap='gray')

for i, mask in enumerate(masks["masks"]):
    plt.imshow(mask, cmap='viridis', alpha=0.1, vmin=0, vmax=1)

plt.axis('off')
plt.show()
Di bawah ini adalah gambar asli dalam skala abu-abu dengan peta berwarna yang ditumpangkan di atasnya. Sangat mengesankan.
Inferensi Model
Point Prompting
Anda juga dapat menggunakan model tanpa pipeline. Untuk melakukannya, inisialisasi model dan prosesor.
from transformers import SamModel, SamProcessor
from accelerate import Accelerator
import torch
device = Accelerator().device
model = SamModel.from_pretrained("facebook/sam-vit-base").to(device)
processor = SamProcessor.from_pretrained("facebook/sam-vit-base")
Untuk melakukan point prompting, berikan titik input ke processor, lalu ambil output processor dan berikan ke model untuk inferensi. Untuk memproses ulang output model, berikan output dan original_sizes yang diambil dari output awal processor. Kita perlu memberikan ini karena processor mengubah ukuran gambar, dan output perlu diekstrapolasi.
input_points = [[[2592, 1728]]] # point location of the bee

inputs = processor(image, input_points=input_points, return_tensors="pt").to(device)
with torch.no_grad():
    outputs = model(**inputs)
masks = processor.image_processor.post_process_masks(outputs.pred_masks.cpu(), inputs["original_sizes"].cpu())
Kita dapat memvisualisasikan tiga mask pada output masks.
import matplotlib.pyplot as plt
import numpy as np

fig, axes = plt.subplots(1, 4, figsize=(15, 5))

axes[0].imshow(image)
axes[0].set_title('Original Image')
mask_list = [masks[0][0][0].numpy(), masks[0][0][1].numpy(), masks[0][0][2].numpy()]

for i, mask in enumerate(mask_list, start=1):
    overlayed_image = np.array(image).copy()

    overlayed_image[:,:,0] = np.where(mask == 1, 255, overlayed_image[:,:,0])
    overlayed_image[:,:,1] = np.where(mask == 1, 0, overlayed_image[:,:,1])
    overlayed_image[:,:,2] = np.where(mask == 1, 0, overlayed_image[:,:,2])

    axes[i].imshow(overlayed_image)
    axes[i].set_title(f'Mask {i}')
for ax in axes:
    ax.axis('off')

plt.show()
Box Prompting
Anda juga dapat melakukan box prompting dengan cara yang serupa dengan point prompting. Anda cukup melewatkan kotak input dalam format daftar [x_min, y_min, x_max, y_max] bersama dengan gambar ke processor. Ambil output dari processor dan langsung lewati ke model, lalu lakukan post-processing pada output tersebut lagi.
# bounding box around the bee
box = [2350, 1600, 2850, 2100]

inputs = processor(
        image,
        input_boxes=[[[box]]],
        return_tensors="pt"
    ).to(model.device)

with torch.no_grad():
    outputs = model(**inputs)

mask = processor.image_processor.post_process_masks(
    outputs.pred_masks.cpu(),
    inputs["original_sizes"].cpu(),
)[0][0][0].numpy()
Anda dapat memvisualisasikan kotak pembatas di sekitar lebah seperti yang ditunjukkan di bawah ini.
import matplotlib.patches as patches

fig, ax = plt.subplots()
ax.imshow(image)

rectangle = patches.Rectangle((2350, 1600), 500, 500, linewidth=2, edgecolor='r', facecolor='none')
ax.add_patch(rectangle)
ax.axis("off")
plt.show()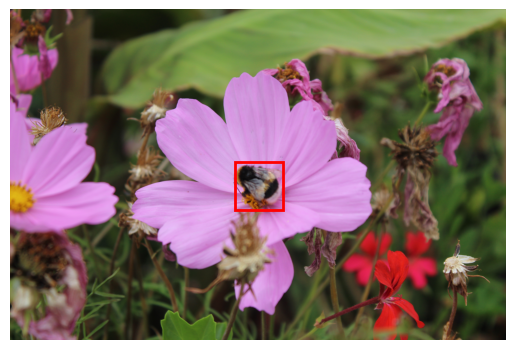
Anda dapat melihat hasil inferensi di bawah ini.
fig, ax = plt.subplots()
ax.imshow(image)
ax.imshow(mask, cmap='viridis', alpha=0.4)

ax.axis("off")
plt.show()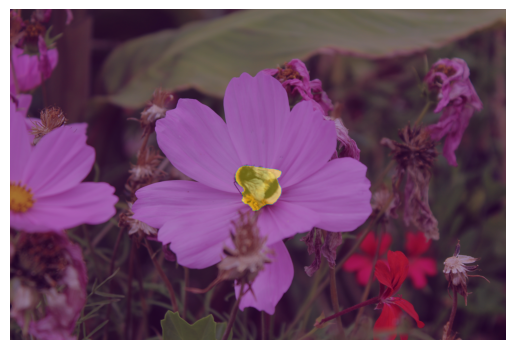
Fine-tuning untuk Generasi Mask
Kami akan melakukan fine-tuning pada SAM2.1 menggunakan sebagian kecil dari dataset MicroMat untuk image matting. Kami perlu menginstal pustaka monai untuk menggunakan DICE loss, serta trackio untuk mencatat mask selama pelatihan.
pip install -q datasets monai trackio
```
We can now load our dataset and take a look.

```python
from datasets import load_dataset

dataset = load_dataset("merve/MicroMat-mini", split="train")
dataset
# Dataset({
#    features: ['image', 'mask', 'prompt', 'image_id', 'object_id', 'sample_idx', 'granularity',
# 'image_path', 'mask_path', 'prompt_path'],  num_rows: 94
#})
Kita membutuhkan kolom image, mask, dan prompt. Kita membagi data untuk train dan test.
dataset = dataset.train_test_split(test_size=0.1)
train_ds = dataset["train"]
val_ds = dataset["test"]
Mari kita lihat sebuah contoh.
train_ds[0] {'image': <PIL.PngImagePlugin.PngImageFile image mode=RGB size=2040x1356>,
'mask': <PIL.PngImagePlugin.PngImageFile image mode=L size=2040x1356>,
'prompt': '{"point": [[137, 1165, 1], [77, 1273, 0], [58, 1351, 0]], "bbox": [0, 701, 251, 1356]}',
'image_id': '0034',
'object_id': '34',
'sample_idx': 1,
'granularity': 'fine',
'image_path': '/content/MicroMat-mini/img/0034.png',
'mask_path': '/content/MicroMat-mini/mask/0034_34.png',
'prompt_path': '/content/MicroMat-mini/prompt/0034_34.json'}Prompts adalah string dari dictionary, sehingga Anda dapat memperoleh bounding box seperti yang ditunjukkan di bawah ini.
import json

json.loads(train_ds["prompt"][0])["bbox"]
# [0, 701, 251, 1356]
Visualisasikan contoh gambar, prompt, dan mask.
import matplotlib.pyplot as plt
import numpy as np

def show_mask(mask, ax):
    color = np.array([0.12, 0.56, 1.0, 0.6])
    mask = np.array(mask)
    h, w = mask.shape
    mask_image = mask.reshape(h, w, 1) * color.reshape(1, 1, 4)
    ax.imshow(mask_image)
    x0, y0, x1, y1 = eval(train_ds["prompt"][0])["bbox"]
    ax.add_patch(
        plt.Rectangle((x0, y0), x1 - x0, y1 - y0,
                      fill=False, edgecolor="lime", linewidth=2))

example = train_ds[0]
image = np.array(example["image"])
ground_truth_mask = np.array(example["mask"])

fig, ax = plt.subplots()
ax.imshow(image)
show_mask(ground_truth_mask, ax)
ax.set_title("Ground truth mask")
ax.set_axis_off()

plt.show()
Sekarang kita dapat mendefinisikan dataset untuk memuat data. SAMDataset membungkus dataset kita dan memformat setiap sampel sesuai dengan yang diharapkan oleh prosesor SAM. Jadi, alih-alih gambar dan mask mentah, Anda akan mendapatkan gambar yang sudah diproses, bounding box, dan mask ground-truth yang siap untuk pelatihan.
Secara default, processor mengubah ukuran gambar, sehingga selain gambar dan mask, ia juga mengembalikan ukuran aslinya. Kita juga perlu membinerisasi mask karena nilainya berada dalam rentang [0, 255].
from torch.utils.data import Dataset
import torch

class SAMDataset(Dataset):
  def __init__(self, dataset, processor):
    self.dataset = dataset
    self.processor = processor

  def __len__(self):
    return len(self.dataset)

  def __getitem__(self, idx):
    item = self.dataset[idx]
    image = item["image"]
    prompt = eval(item["prompt"])["bbox"]
    inputs = self.processor(image, input_boxes=[[prompt]], return_tensors="pt")
    inputs["ground_truth_mask"] = (np.array(item["mask"]) > 0).astype(np.float32)
    inputs["original_image_size"] = torch.tensor(image.size[::-1])


    return inputs
Kita dapat menginisialisasi prosesor dan dataset dengannya.
from transformers import Sam2Processor

processor = Sam2Processor.from_pretrained("facebook/sam2.1-hiera-small")
train_dataset = SAMDataset(dataset=train_ds, processor=processor)
```

We need to define a data collator that will turn varying size of ground truth masks to batches of reshaped masks in same shape. We reshape them using nearest neighbor interpolation. We also make batched tensors for rest of the elements in the batch. If your masks are all of same size, feel free to skip this step.

```python
import torch.nn.functional as F

def collate_fn(batch, target_hw=(256, 256)):

    pixel_values = torch.cat([item["pixel_values"] for item in batch], dim=0)
    original_sizes = torch.stack([item["original_sizes"] for item in batch])
    input_boxes = torch.cat([item["input_boxes"] for item in batch], dim=0)
    ground_truth_masks = torch.cat([
        F.interpolate(
            torch.as_tensor(x["ground_truth_mask"]).unsqueeze(0).unsqueeze(0).float(),
            size=(256, 256),
            mode="nearest"
        )
        for x in batch
    ], dim=0).long()

    return {
        "pixel_values": pixel_values,
        "original_sizes": original_sizes,
        "input_boxes": input_boxes,
        "ground_truth_mask": ground_truth_masks,
        "original_image_size": torch.stack([item["original_image_size"] for item in batch]),
    }

from torch.utils.data import DataLoader
train_dataloader = DataLoader(
    train_dataset,
    batch_size=4,
    shuffle=True,
    collate_fn=collate_fn,
)
Mari kita lihat apa yang dihasilkan oleh data loader.
batch = next(iter(train_dataloader))
for k,v in batch.items():
  print(k,v.shape)

# pixel_values torch.Size([4, 3, 1024, 1024])
# original_sizes torch.Size([4, 1, 2])
# input_boxes torch.Size([4, 1, 4])
# ground_truth_mask torch.Size([4, 1, 256, 256])
#original_image_size torch.Size([4, 2])
Sekarang kita akan memuat model dan membekukan vision serta prompt encoder agar hanya mask decoder yang dilatih.
from transformers import Sam2Model

model = Sam2Model.from_pretrained("facebook/sam2.1-hiera-small")

for name, param in model.named_parameters():
  if name.startswith("vision_encoder") or name.startswith("prompt_encoder"):
    param.requires_grad_(False)
```

We can now define the optimizer and the loss function.
```python
from torch.optim import Adam
import monai

optimizer = Adam(model.mask_decoder.parameters(), lr=1e-5, weight_decay=0)
seg_loss = monai.losses.DiceCELoss(sigmoid=True, squared_pred=True, reduction='mean')
Mari kita lihat bagaimana kinerja model sebelum pelatihan.
import matplotlib.pyplot as plt

item = val_ds[1]
img = item["image"]
bbox = json.loads(item["prompt"])["bbox"]
inputs = processor(images=img, input_boxes=[[bbox]], return_tensors="pt").to(model.device)

with torch.no_grad():
  outputs = model(**inputs)

masks = processor.post_process_masks(outputs.pred_masks.cpu(), inputs["original_sizes"])[0]
preds = masks.squeeze(0)
mask = (preds[0] > 0).cpu().numpy()

overlay = np.asarray(img, dtype=np.uint8).copy()
overlay[mask] = 0.55 * overlay[mask] + 0.45 * np.array([0, 255, 0], dtype=np.float32)

plt.imshow(overlay)
plt.axis("off")
plt.show()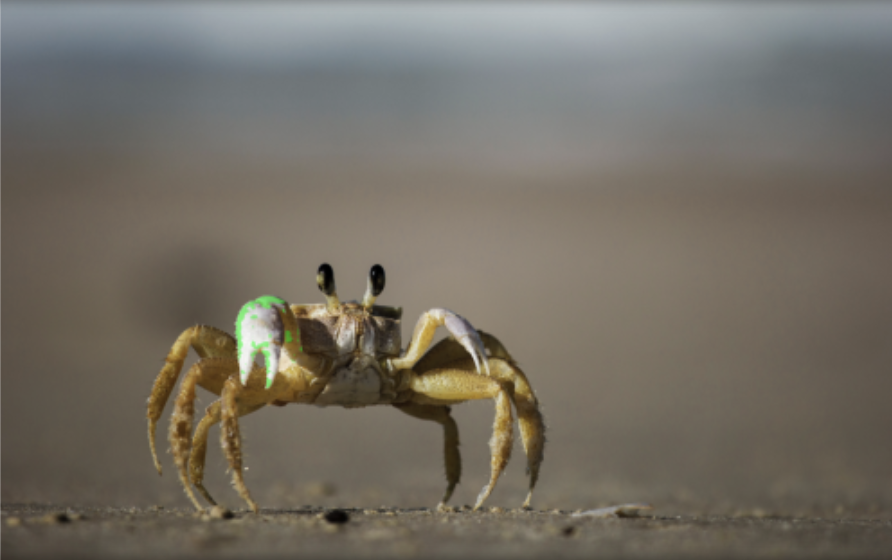
Kita perlu mencatat prediksi kita ke trackio agar dapat memantau peningkatan model di tengah proses pelatihan.
from PIL import Image
import trackio
import json


@torch.no_grad()
def predict_fn(img, bbox):

  inputs = processor(images=img, input_boxes=[[bbox]], return_tensors="pt").to(model.device)

  with torch.no_grad():
      outputs = model(**inputs)

  masks = processor.post_process_masks(outputs.pred_masks.cpu(), inputs["original_sizes"])[0]
  return masks

def log_eval_masks_trackio(dataset, indices, step, predict_fn,  project=None, sample_cap=8):
    logs = {"eval/step": int(step)}
    for idx in indices[:sample_cap]:
        item = dataset[idx]
        img = item["image"]
        bbox = json.loads(item["prompt"])["bbox"]
        preds = predict_fn(img, bbox)
        preds = preds.squeeze(0)
        mask = (preds[0] > 0).cpu().numpy()

        overlay = np.asarray(img, dtype=np.uint8).copy()
        overlay[mask] = 0.55 * overlay[mask] + 0.45 * np.array([0, 255, 0], dtype=np.float32)
        logs[f"{idx}/overlay"] = trackio.Image(overlay, caption="overlay")

    trackio.log(logs)
Sekarang kita bisa menulis loop pelatihan dan mulai melatih!
Perhatikan bagaimana kami mencatat loss dan mask evaluasi kami dengan trackio.
from tqdm import tqdm
from statistics import mean
import trackio
import torch

num_epochs = 30

device = torch.accelerator.current_accelerator().type if torch.accelerator.is_available() else "cpu"
model.to(device)

model.train()
trackio.init(project="mask-eval")
for epoch in range(num_epochs):
    epoch_losses = []
    for batch in tqdm(train_dataloader):
      outputs = model(pixel_values=batch["pixel_values"].to(device),
                      input_boxes=batch["input_boxes"].to(device),
                      multimask_output=False)

      predicted_masks = outputs.pred_masks.squeeze(1)
      ground_truth_masks = batch["ground_truth_mask"].float().to(device)
      loss = seg_loss(predicted_masks, ground_truth_masks)

      optimizer.zero_grad()
      loss.backward()

      optimizer.step()
      epoch_losses.append(loss.item())

    log_eval_masks_trackio(dataset=val_ds, indices=[0, 3, 6, 9], step=epoch, predict_fn=predict_fn, project="mask-eval")
    print(f'Epoch: {epoch}')
    print(f'Mean loss: {mean(epoch_losses)}')
    trackio.log({"loss": mean(epoch_losses)})

trackio.finish()
Mari kita uji model yang telah dilatih.
import matplotlib.pyplot as plt

item = val_ds[1]
img = item["image"]
bbox = json.loads(item["prompt"])["bbox"]

inputs = processor(images=img, input_boxes=[[bbox]], return_tensors="pt").to(model.device)

with torch.no_grad():
  outputs = model(**inputs)

preds = processor.post_process_masks(outputs.pred_masks.cpu(), inputs["original_sizes"])[0]

preds = preds.squeeze(0)
mask = (preds[0] > 0).cpu().numpy()

overlay = np.asarray(img, dtype=np.uint8).copy()
overlay[mask] = 0.55 * overlay[mask] + 0.45 * np.array([0, 255, 0], dtype=np.float32)

plt.imshow(overlay)
plt.axis("off")
plt.show()
Perbaikan yang sangat baik setelah hanya dilatih selama 20 epoch pada dataset kecil!
