
Transformers documentation
クイックスタート
クイックスタート
Transformersは、すべての人がTransformerモデルの学習や構築をすぐに始められるよう、高速かつ使いやすさを重視して設計されています。
ユーザー向けの抽象化は、モデルのインスタンス化に使用する3つのクラスと、推論または学習に使用する2つのAPIに限定されています。このクイックスタートでは、Transformersの主要な機能を紹介し、以下の方法を示します。
セットアップ
まず、Hugging Face のアカウントの作成をお勧めします。アカウントを作成すると、Hugging Face のHub上で、バージョン管理されたモデル、データセット、Spacesをホストし、アクセスできます。Hub は、発見と構築のための協働プラットフォームです。
User Access Tokenを作成し、アカウントにログインしてください。
ログインを促されたら、User Access Token を notebook_login に貼り付けてください。
from huggingface_hub import notebook_login

notebook_login()
huggingface_hub[cli] パッケージがインストールされていることを確認し、以下のコマンドを実行してください。ログインを促されたら、User Access Token を貼り付けてください。
hf auth login
PyTorchをインストールします。
# remove ! if installing from the CLI
!pip install torch
次に、Hugging Faceエコシステムから、データセットやビジョンモデルへのアクセス、トレーニングの評価、大規模モデル向けトレーニングの最適化を行うための、最新バージョンのTransformersと追加のライブラリをインストールします。
# remove ! if installing from the CLI
!pip install -U transformers datasets evaluate accelerate timm
エージェントのスキル
Hugging Face Skills は、コーディングエージェントが Transformers をどのように扱うかを教えます。学習スクリプトを自分で書く代わりに、エージェントにビジョンモデルのファインチューニングを依頼し、スキルがそのプロセスを導くようにします。
/plugin marketplace add huggingface/skills
/plugin install hf-cli@huggingface/skills
codex plugin marketplace add huggingface/skills
次に、Codex で /plugins を実行し、huggingface/skills リポジトリからスキルをインストールします。
Cursor や Gemini など、サポートされている他のプラットフォームについては、インストールガイドを参照してください。
スキルがインストールされたら、コーディングエージェントへの指示にそのスキルを含めてください。
Use the HF Trainer skill to fine-tune RT-DETRv2 on [Lekim89/sportsmot](https://huggingface.co/datasets/Lekim89/sportsmot) for basketball player tracking.事前学習済みモデル
各事前学習済みモデルは、3つのベースクラスを継承します。
| クラス | 説明 |
|---|---|
| PreTrainedConfig | アテンションヘッド数や語彙サイズなど、モデルの属性を指定するファイル。 |
| PreTrainedModel | 設定ファイルのモデル属性によって定義されるモデル(またはアーキテクチャ)。事前学習済みモデルは、生の隠れ状態のみを返します。特定のタスクでは、適切なモデルヘッドを使用して、生の隠れ状態を意味のある結果に変換します(例: LlamaModel と LlamaForCausalLM の違い)。 |
| プリプロセッサ | 生の入力(テキスト、画像、音声、マルチモーダル)をモデルの数値入力に変換するためのクラスです。例えば、PreTrainedTokenizerはテキストをテンソルに変換し、ImageProcessingMixinはピクセルをテンソルに変換します。 |
モデルとプリプロセッサの読み込みには、AutoClass APIの使用を推奨します。このAPIは、事前学習済み重みおよび設定ファイルの名前またはパスに基づいて、各タスクと機械学習フレームワークに適したアーキテクチャを自動的に推論します。
from_pretrained() を使用して、Hub から重みと設定ファイルをモデルおよびプリプロセッサクラスに読み込みます。
モデルを読み込む際は、モデルが最適に読み込まれるよう、以下のパラメータを設定してください。
device_map="auto"を指定すると、モデルの重みが最も高速なデバイスに優先的に割り当てられます。dtype="auto"を指定すると、モデルの重みが保存されているデータ型で直接初期化されるため、重みを2回読み込むことを回避できる場合があります(PyTorch はデフォルトでtorch.float32で重みをロードします)。
from transformers import AutoModelForCausalLM, AutoTokenizer

model = AutoModelForCausalLM.from_pretrained("meta-llama/Llama-2-7b-hf", dtype="auto", device_map="auto")
tokenizer = AutoTokenizer.from_pretrained("meta-llama/Llama-2-7b-hf")
トークナイザを使用してテキストをトークン化し、PyTorch テンソルを返します。推論を実行する前に、モデルが処理できるように、トークン化された入力をモデルと同じデバイスに移動します。
model_inputs = tokenizer(["The secret to baking a good cake is "], return_tensors="pt").to(model.device)モデルは推論または学習の準備が整いました。
推論では、トークン化された入力をgenerate()に渡してテキストを生成します。batch_decode()を使用して、トークンIDをテキストに戻します。
generated_ids = model.generate(**model_inputs, max_length=30)
tokenizer.batch_decode(generated_ids)[0]
'<s> The secret to baking a good cake is 100% in the preparation. There are so many recipes out there,'モデルのファインチューニングの方法を学ぶには、Trainerセクションへスキップしてください。
パイプライン
Pipeline クラスは、事前学習済みモデルで推論を実行する最も便利な方法です。テキスト生成、画像セグメンテーション、自動音声認識、文書質問応答など、多くのタスクに対応しています。
利用可能なタスクの完全なリストについては、Pipeline API リファレンスを参照してください。
Pipeline オブジェクトを作成し、タスクを選択します。デフォルトでは、Pipeline は指定されたタスク用のデフォルトの事前学習済みモデルをダウンロードしてキャッシュします。特定のモデルを選択するには、モデル名を model パラメータに渡します。
Accelerator を使用して、推論に利用可能なアクセラレータを自動的に検出します。
from transformers import pipeline
from accelerate import Accelerator

device = Accelerator().device

pipe = pipeline("text-generation", model="meta-llama/Llama-2-7b-hf", device=device)初期テキストをプロンプトとしてPipelineに渡し、さらにテキストを生成します。
pipe("The secret to baking a good cake is ", max_length=50)
[{'generated_text': 'The secret to baking a good cake is 100% in the batter. The secret to a great cake is the icing.\nThis is why we’ve created the best buttercream frosting reci'}]
Accelerator を使用して、推論に利用可能なアクセラレータを自動的に検出します。
from transformers import pipeline
from accelerate import Accelerator

device = Accelerator().device

pipeline = pipeline("image-segmentation", model="facebook/detr-resnet-50-panoptic", device=device)画像(URLまたはローカルパス)をPipelineに渡します。
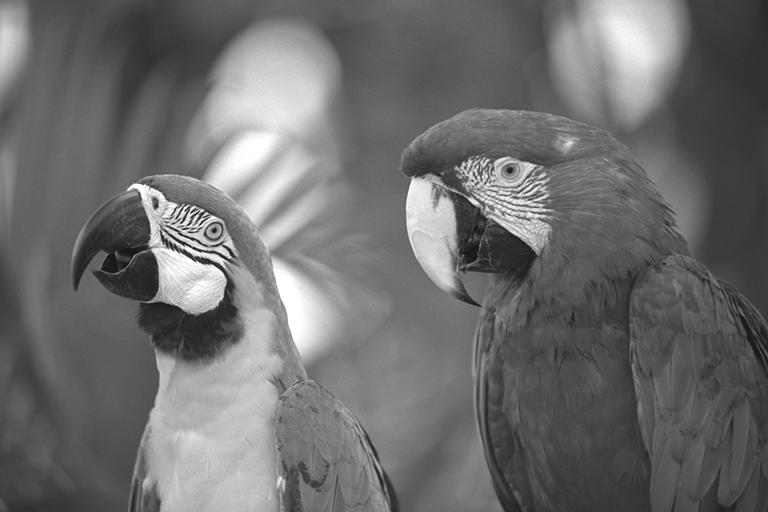
segments = pipeline("https://huggingface.co/datasets/Narsil/image_dummy/raw/main/parrots.png")
segments[0]["label"]
'bird'
segments[1]["label"]
'bird'
Accelerator を使用して、推論に利用可能なアクセラレータを自動的に検出します。
from transformers import pipeline
from accelerate import Accelerator

device = Accelerator().device

pipeline = pipeline("automatic-speech-recognition", model="openai/whisper-large-v3", device=device)オーディオファイルをPipelineに渡します。
pipeline("https://huggingface.co/datasets/Narsil/asr_dummy/resolve/main/1.flac")
{'text': ' He hoped there would be stew for dinner, turnips and carrots and bruised potatoes and fat mutton pieces to be ladled out in thick, peppered flour-fatten sauce.'}
Trainer
Trainerは、PyTorchモデル向けの完全な学習および評価ループです。手動で学習ループを書く際に通常必要となる多くの定型コードを抽象化するため、より素早く学習を開始し、学習の設計判断に集中できます。モデル、データセット、プリプロセッサ、およびデータセットからバッチを構築するためのデータコラレーターがあれば十分です。
TrainingArguments クラスを使用して、トレーニングプロセスをカスタマイズします。トレーニング、評価など、多くのオプションが提供されています。バッチサイズ、学習率、混合精度、torch.compile などのトレーニングハイパーパラメータや機能を試行錯誤し、トレーニングのニーズに合わせて調整できます。また、デフォルトのトレーニングパラメータを使用して、素早くベースラインを生成することもできます。
学習用にモデル、トークナイザー、データセットを読み込みます。
from transformers import AutoModelForSequenceClassification, AutoTokenizer
from datasets import load_dataset

model = AutoModelForSequenceClassification.from_pretrained("distilbert/distilbert-base-uncased")
tokenizer = AutoTokenizer.from_pretrained("distilbert/distilbert-base-uncased")
dataset = load_dataset("cornell-movie-review-data/rotten_tomatoes")
テキストをトークナイズし、PyTorch のテンソルに変換する関数を作成します。この関数を map メソッドを用いてデータセット全体に適用します。
def tokenize_dataset(dataset):
    return tokenizer(dataset["text"])
dataset = dataset.map(tokenize_dataset, batched=True)
データコラテーターを読み込み、データの一括処理(バッチ)を作成し、トークナイザーを渡します。
from transformers import DataCollatorWithPadding

data_collator = DataCollatorWithPadding(tokenizer=tokenizer)次に、TrainingArgumentsに学習機能とハイパーパラメータを設定します。
from transformers import TrainingArguments

training_args = TrainingArguments(
    output_dir="distilbert-rotten-tomatoes",
    learning_rate=2e-5,
    per_device_train_batch_size=8,
    per_device_eval_batch_size=8,
    num_train_epochs=2,
    push_to_hub=True,
)最後に、これらの個別のコンポーネントをすべてTrainerに渡し、train()を呼び出して開始します。
from transformers import Trainer

trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=dataset["train"],
    eval_dataset=dataset["test"],
    processing_class=tokenizer,
    data_collator=data_collator,
)

trainer.train()
push_to_hub() を使用して、モデルとトークナイザーを Hub に共有してください。
trainer.push_to_hub()
おめでとうございます。Transformersで最初のモデルを訓練しました!
次のステップ
Transformersとその提供機能についてより深く理解できたところで、ここからは最も興味のある分野をさらに探求し、学習を深める段階です。
- ベースクラス: 設定、モデル、プロセッサのクラスについて詳しく学びます。これにより、モデルの作成とカスタマイズ方法、異なるタイプの入力(音声、画像、マルチモーダル)の前処理方法、そしてモデルの共有方法について理解を深めることができます。
- 推論: Pipelineのさらなる活用、LLMによる推論とチャット、エージェント、そして機械学習フレームワークとハードウェアを用いた推論の最適化方法について学びます。
- 学習: Trainer、分散学習、特定のハードウェアでの学習の最適化について詳しく学びます。
- 量子化: 重みをより少ないビット数で表現することで、メモリおよびストレージの要件を削減し、推論を高速化します。
- リソース: 特定のタスクでモデルをトレーニングし、推論を行うためのエンドツーエンドのレシピをお探しですか?タスクのレシピをご覧ください!