
Transformers documentation
ImageGPT
Эта модель была добавлена в Hugging Face Transformers 18.11.2021.
ImageGPT
Обзор
Модель ImageGPT была предложена в работе Generative Pretraining from Pixels Марка Чена, Алекса Радафорда, Ривона Чилда, Джеффри У, Хиу Джона, Дэвида Луана и Ильи Сутскевера. ImageGPT (iGPT) — это модель, похожая на GPT-2, обученная предсказывать значение следующего пикселя, что позволяет осуществлять как безусловную, так и условную генерацию изображений.
Аннотация из статьи гласит:
Вдохновлённые прогрессом в обучении представлений без учителя для естественного языка, мы исследуем, могут ли аналогичные модели обучать полезным представлениям для изображений. Мы обучаем последовательный Transformer предсказывать пиксели авто-регрессивно, не используя знания о двумерной структуре входных данных. Несмотря на обучение на ImageNet низкого разрешения без меток, мы обнаруживаем, что модель масштаба GPT-2 обучает сильным представлениям изображений, что подтверждается результатами линейного зондирования, дообучения и классификации с малым объёмом данных. На CIFAR-10 мы достигаем точности 96,3% с линейным зондом, превосходя надзорный Wide ResNet, и точности 99,0% при полном дообучении, что соответствует лучшим надзорным предобученным моделям. Мы также конкурентоспособны с бенчмарками самообучения на ImageNet при замене пикселей на кодирование VQVAE, достигая точности top-1 69,0% при линейном зондировании наших признаков.
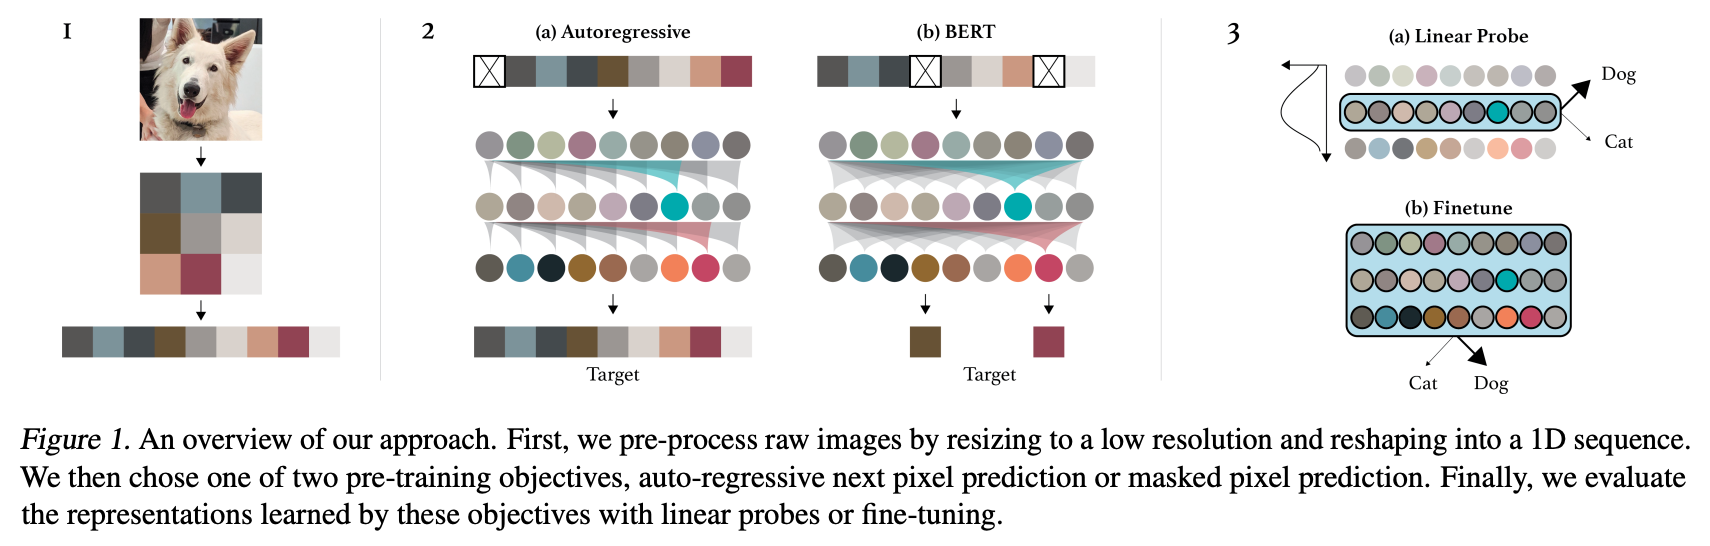 Summary of the approach. Taken from the [original paper](https://cdn.openai.com/papers/Generative_Pretraining_from_Pixels_V2.pdf).
Эта модель была добавлена nielsr на основе этого вопроса. Исходный код можно найти здесь.
Советы по использованию
- ImageGPT практически идентичен GPT-2, за исключением того, что используется другая функция активации (а именно “quick gelu”), а слои нормализации не центрируют входные данные. Кроме того, в ImageGPT нет связанных входных и выходных эмбеддингов.
- Поскольку требования к времени и памяти механизма внимания в Transformers растут квадратично с увеличением длины последовательности, авторы обучали ImageGPT на изображениях с меньшим разрешением, например 32x32 и 64x64. Однако передача в Transformer последовательности из 32x32x3=3072 токенов со значениями от 0 до 255 по-прежнему является недопустимо большой нагрузкой. Поэтому авторы применили кластеризацию k-means к значениям пикселей (R,G,B) с k=512. Таким образом, длина последовательности составляет всего 32*32 = 1024, но теперь она состоит из целых чисел в диапазоне от 0 до 511. Иными словами, мы сокращаем длину последовательности ценой увеличения размера матрицы эмбеддингов. Размер словаря ImageGPT равен 512, плюс 1 для специального токена «начало предложения» (SOS), который используется в начале каждой последовательности. Для подготовки изображений к модели можно использовать ImageGPTImageProcessor.
- Несмотря на то, что ImageGPT обучался полностью без учителя (то есть без использования каких-либо меток), он формирует достаточно эффективные признаки изображений, полезные для задач, следующих за ним, например, для классификации изображений. Авторы показали, что наиболее эффективными являются признаки из средних слоёв сети, и их можно использовать как есть для обучения линейной модели (например, логистической регрессии из sklearn). Этот подход также называют «линейным зондированием» (linear probing). Признаки можно легко получить, сначала пропустив изображение через модель, затем указав
output_hidden_states=True, а после этого применив усредняющее пулинг (average-pooling) к скрытым состояниям на любом выбранном вами слое. - В качестве альтернативы можно дополнительно дообучить всю модель на наборе данных для конкретной задачи, аналогично BERT. Для этого можно использовать ImageGPTForImageClassification.
- ImageGPT выпускается в разных размерах: есть ImageGPT-small, ImageGPT-medium и ImageGPT-large. Авторы также обучили вариант XL, но не опубликовали его. Различия в размерах сведены в следующей таблице:
| Вариант модели | Глубины | Размеры скрытых слоёв | Размер скрытого слоя декодера | Параметры (млн) | ImageNet-1k Top 1 |
|---|---|---|---|---|---|
| MiT-b0 | [2, 2, 2, 2] | [32, 64, 160, 256] | 256 | 3.7 | 70.5 |
| MiT-b1 | [2, 2, 2, 2] | [64, 128, 320, 512] | 256 | 14.0 | 78.7 |
| MiT-b2 | [3, 4, 6, 3] | [64, 128, 320, 512] | 768 | 25.4 | 81.6 |
| MiT-b3 | [3, 4, 18, 3] | [64, 128, 320, 512] | 768 | 45.2 | 83.1 |
| MiT-b4 | [3, 8, 27, 3] | [64, 128, 320, 512] | 768 | 62.6 | 83.6 |
| MiT-b5 | [3, 6, 40, 3] | [64, 128, 320, 512] | 768 | 82.0 | 83.8 |
Ресурсы
Список официальных ресурсов Hugging Face и сообщества (отмечены значком 🌎), которые помогут вам начать работу с ImageGPT.
- Демо-ноутбуки для ImageGPT можно найти здесь.
- ImageGPTForImageClassification поддерживается в этом ноутбуке.
- См. также: Руководство по задаче классификации изображений
Если вы хотите предложить ресурс для включения в этот раздел, пожалуйста, создайте Pull Request, и мы его рассмотрим! В идеале ресурс должен демонстрировать что-то новое, а не дублировать уже имеющийся.
ImageGPTConfig
класс transformers.ImageGPTConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 513n_positions: int = 1024n_embd: int = 512n_layer: int = 24n_head: int = 8n_inner: int | None = Noneactivation_function: str = 'quick_gelu'resid_pdrop: float | int = 0.1embd_pdrop: float | int = 0.1attn_pdrop: float | int = 0.1layer_norm_epsilon: float = 1e-05initializer_range: float = 0.02scale_attn_weights: bool = Trueuse_cache: bool = Truetie_word_embeddings: bool = Falsescale_attn_by_inverse_layer_idx: bool = Falsereorder_and_upcast_attn: bool = Falseadd_cross_attention: bool = Falsepad_token_id: int | None = Nonebos_token_id: int | None = Noneeos_token_id: int | list[int] | None = None )
Параметры
- vocab_size (
int, необязательный, по умолчанию513) — Размер словаря модели. Определяет количество различных токенов, которые могут быть представлены вinput_ids. - n_positions (
int, необязательный, по умолчанию1024) — Максимальная длина последовательности, с которой может использоваться эта модель. - n_embd (
int, необязательный, по умолчанию512) — Размерность эмбеддингов и скрытых состояний. - n_layer (
int, необязательный, по умолчанию24) — Количество скрытых слоев в декодере Transformer. - n_head (
int, необязательный, по умолчанию8) — Количество головок внимания в каждом слое внимания декодера Transformer. - n_inner (
int, необязательный) — Размерность представлений MLP. - activation_function (
str, необязательный, по умолчаниюquick_gelu) — Нелинейная функция активации (функция или строка) в декодере. Например,"gelu","relu","silu"и т. д. - resid_pdrop (
Union[float, int], необязательный, по умолчанию0.1) — Вероятность dropout для всех полносвязных слоёв в блоках эмбеддингов, энкодера и пуллера. - embd_pdrop (
Union[float, int], необязательный, по умолчанию0.1) — Коэффициент dropout для эмбеддингов. - attn_pdrop (
Union[float, int], необязательный, по умолчанию0.1) — Коэффициент dropout для вероятностей внимания. - layer_norm_epsilon (
float, необязательный, по умолчанию1e-05) — Значение epsilon, используемое слоями нормализации. - initializer_range (
float, необязательный, по умолчанию0.02) — Стандартное отклонение truncated_normal_initializer, используемое для инициализации всех матриц весов. - scale_attn_weights (
bool, необязательный, по умолчаниюTrue) — Указывает, следует ли масштабировать эмбеддинги, деля их на sqrt(d_model). - use_cache (
bool, необязательный, по умолчаниюTrue) — Указывает, должен ли модель возвращать последние ключи/значения внимания (не используется во всех моделях). Актуально только еслиconfig.is_decoder=Trueили если модель является генеративной моделью только с декодером. - tie_word_embeddings (
bool, необязательный, по умолчаниюFalse) — Определяет, следует ли связывать веса эмбеддингов согласно маппингуtied_weights_keysмодели. - scale_attn_by_inverse_layer_idx (
bool, необязательный, по умолчаниюFalse) — Указывает, следует ли дополнительно масштабировать веса внимания на1 / layer_idx + 1. - reorder_and_upcast_attn (
bool, необязательный, по умолчаниюFalse) — Указывает, следует ли масштабировать ключи (K) перед вычислением внимания (скалярного произведения) и повышать точность скалярного произведения/softmax внимания до float() при обучении с смешанной точностью. - add_cross_attention (
bool, необязательный, по умолчаниюFalse) — Указывает, следует ли добавлять слои кросс-внимания в модель. - pad_token_id (
int, необязательный) — Идентификатор токена, используемого для выравнивания в словаре. - bos_token_id (
int, необязательный) — Идентификатор токена, используемого для обозначения начала потока в словаре. - eos_token_id (
Union[int, list[int]], необязательный) — Идентификатор токена, используемого для обозначения конца потока в словаре.
Это класс конфигурации для хранения настроек модели ImageGPTModel. Он используется для создания модели Imagegpt в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации openai/imagegpt-small
Объекты конфигурации наследуются от PreTrainedConfig и могут использоваться для управления выводами модели. Подробнее читайте в документации PreTrainedConfig.
Пример:
>>> from transformers import ImageGPTConfig, ImageGPTModel

>>> # Initializing a ImageGPT configuration
>>> configuration = ImageGPTConfig()

>>> # Initializing a model (with random weights) from the configuration
>>> model = ImageGPTModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
ImageGPTImageProcessor
класс transformers.ImageGPTImageProcessor
< source >( clusters: typing.Union[list, numpy.ndarray, torch.Tensor, NoneType] = None**kwargs: *<class 'transformers.models.imagegpt.image_processing_imagegpt.ImageGPTImageProcessorKwargs'> )
Параметры
- clusters (
np.ndarrayилиlist[list[int]]илиtorch.Tensor, необязательный) — Кластеры цветов, используемые при квантовании цвета, с формой(n_clusters, 3). Может быть переопределён параметромclustersвpreprocess. - do_convert_rgb (
bool, kwargs, optional) — Следует ли преобразовать изображение в RGB. - do_resize (
bool, kwargs, optional, по умолчаниюTrue) — Указывает, нужно ли изменять размер изображения. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, по умолчанию{'height' -- 256, 'width': 256}): Определяет максимальные размеры входных данных для модели. - default_to_square (
bool, kwargs, optional, по умолчаниюTrue) — Определяет, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задано как int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Размер выходного изображения после примененияcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, по умолчанию2) — Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисленияPILImageResampling. Влияет только в том случае, еслиdo_resizeустановлено вTrue. - do_rescale (
bool, kwargs, optional, по умолчаниюTrue) — Указывает, следует ли выполнять рескейлинг изображения. - rescale_factor (
float, kwargs, optional, по умолчанию0.00392156862745098) — Коэффициент масштабирования, применяемый к изображению, еслиdo_rescaleустановлен вTrue. - do_normalize (
bool, kwargs, optional, по умолчаниюTrue) — Указывает, следует ли нормализовать изображение. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, optional, по умолчанию[0.5, 0.5, 0.5]) — Среднее значение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional, по умолчанию[0.5, 0.5, 0.5]) — Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - do_pad (
bool, kwargs, optional) — Определяет, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия выравнивания зависит от модели. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Размер в формате{"height": int, "width" int}, до которого следует дополнить изображения. Должен быть больше любого размера изображения, предоставленного для предобработки. Еслиpad_sizeне указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только приdo_pad=True. - do_center_crop (
bool, kwargs, optional) — Выполнять ли центрированную обрезку изображения. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, optional) — Поддерживается толькоChannelDimension.FIRST. Добавлено для совместимости с медленными процессорами. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, необязательный) — Формат размерности каналов для входного изображения. Если не задан, формат размерности каналов выводится из входного изображения. Может быть одним из:"channels_first"илиChannelDimension.FIRST: изображение в формате (num_channels, height, width)."channels_last"илиChannelDimension.LAST: изображение в формате (высота, ширина, число каналов)."none"илиChannelDimension.NONE: изображение в формате (height, width).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — Устройство, на котором будут обрабатываться видео. Если не задано, устройство определяется на основе входных видео. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Возвращает стопку тензоров, если установлено значение'pt', иначе возвращает список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора. - clusters (
np.ndarray, kwargs илиlist[list[int]]илиtorch.Tensor, optional, по умолчаниюself.clusters) — Кластеры цветов, используемые при квантовании цвета, с формой(n_clusters, 3). Могут быть переопределены параметромclustersвpreprocess. - do_color_quantize (
bool, kwargs, optional, по умолчаниюself.do_color_quantize) — Управляет применением квантования цвета для преобразования непрерывных значений пикселей в дискретные индексы кластеров. Если значение равно True, каждый пиксель назначается ближайшему цветовому кластеру, что позволяет использовать дискретное токенизирование в ImageGPT.
Создаёт процессор изображений ImageGPTImageProcessor.
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]*argsimage_like_kwargs: dict[str, typing.Any] | None = None**kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> ) → ~image_processing_base.BatchFeature
Параметры
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Изображение для предобработки. Ожидается одно изображение или батч изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установитеdo_rescale=False. - image_like_kwargs (
dict[str, Any], необязательный) — Флаг для разработчиков, позволяющий передать дополнительные входные данные, похожие на изображения, которые также будут предобработаны. Используйте этот параметр только в том случае, если передача входных данных через kwarg не работает. Например,preprocess(images, masks=masks)— предпочтительный вариант, но для некоторых моделей он приводит к проблемам с приоритетом аргументов. В таких случаях можно использоватьpreprocess(images, image_like_inputs={"masks": masks}). - do_convert_rgb (
bool, kwargs, optional) — Следует ли преобразовать изображение в RGB. - do_resize (
bool, kwargs, optional) — Указывает, нужно ли изменить размер изображения. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Описывает максимальные размеры входных данных для модели. - default_to_square (
bool, kwargs, optional) — Определяет, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size является целым числом. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Размер выходного изображения после примененияcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисленияPILImageResampling. Влияет только в том случае, еслиdo_resizeустановлено вTrue. - do_rescale (
bool, kwargs, optional) — Нужно ли перемасштабировать изображение. - rescale_factor (
float, kwargs, optional) — Коэффициент масштабирования, применяемый к изображению, еслиdo_rescaleустановлен вTrue. - do_normalize (
bool, kwargs, optional) — Нужно ли нормализовать изображение. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — Среднее значение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - do_pad (
bool, kwargs, optional) — Определяет, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия выравнивания зависит от модели. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Размер в формате{"height": int, "width" int}, до которого следует дополнить изображения. Должен быть больше любого размера изображения, предоставленного для предобработки. Еслиpad_sizeне указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только приdo_pad=True. - do_center_crop (
bool, kwargs, optional) — Выполнять ли центрированную обрезку изображения. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, optional) — Поддерживается толькоChannelDimension.FIRST. Добавлено для совместимости с медленными процессорами. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, необязательный) — Формат размерности каналов для входного изображения. Если не задан, формат размерности каналов выводится из входного изображения. Может быть одним из:"channels_first"илиChannelDimension.FIRST: изображение в формате (num_channels, height, width)."channels_last"илиChannelDimension.LAST: изображение в формате (высота, ширина, число каналов)."none"илиChannelDimension.NONE: изображение в формате (height, width).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — Устройство, на котором будут обрабатываться видео. Если не задано, устройство определяется на основе входных видео. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Возвращает стопку тензоров, если установлено значение'pt', иначе возвращает список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
Возвращает
~image_processing_base.BatchFeature
- data (
dict) — Словарь списков/массивов/тензоров, возвращаемый методом call (‘pixel_values’ и т. д.). - tensor_type (
Union[None, str, TensorType], необязательный) — Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
Предобработка изображения или пакета изображений.
ImageGPTImageProcessorPil
класс transformers.ImageGPTImageProcessorPil
< source >( clusters: list | np.ndarray | torch.Tensor | None = None**kwargs: *<class 'transformers.models.imagegpt.image_processing_pil_imagegpt.ImageGPTImageProcessorKwargs'> )
Параметры
- clusters (
np.ndarrayилиlist[list[int]]илиtorch.Tensor, необязательный) — Кластеры цветов, используемые при квантовании цвета, с формой(n_clusters, 3). Может быть переопределён параметромclustersвpreprocess. - do_convert_rgb (
bool, kwargs, optional) — Следует ли преобразовать изображение в RGB. - do_resize (
bool, kwargs, optional, по умолчаниюTrue) — Указывает, нужно ли изменять размер изображения. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, по умолчанию{'height' -- 256, 'width': 256}): Определяет максимальные размеры входных данных для модели. - default_to_square (
bool, kwargs, optional, по умолчаниюTrue) — Определяет, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задано как int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Размер выходного изображения после примененияcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, по умолчанию2) — Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисленияPILImageResampling. Влияет только в том случае, еслиdo_resizeустановлено вTrue. - do_rescale (
bool, kwargs, optional, по умолчаниюTrue) — Указывает, следует ли выполнять рескейлинг изображения. - rescale_factor (
float, kwargs, optional, по умолчанию0.00392156862745098) — Коэффициент масштабирования, применяемый к изображению, еслиdo_rescaleустановлен вTrue. - do_normalize (
bool, kwargs, optional, по умолчаниюTrue) — Указывает, следует ли нормализовать изображение. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, optional, по умолчанию[0.5, 0.5, 0.5]) — Среднее значение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional, по умолчанию[0.5, 0.5, 0.5]) — Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - do_pad (
bool, kwargs, optional) — Определяет, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия выравнивания зависит от модели. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Размер в формате{"height": int, "width" int}, до которого следует дополнить изображения. Должен быть больше любого размера изображения, предоставленного для предобработки. Еслиpad_sizeне указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только приdo_pad=True. - do_center_crop (
bool, kwargs, optional) — Выполнять ли центрированную обрезку изображения. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, optional) — Поддерживается толькоChannelDimension.FIRST. Добавлено для совместимости с медленными процессорами. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, необязательный) — Формат размерности каналов для входного изображения. Если не задан, формат размерности каналов выводится из входного изображения. Может быть одним из:"channels_first"илиChannelDimension.FIRST: изображение в формате (num_channels, height, width)."channels_last"илиChannelDimension.LAST: изображение в формате (высота, ширина, число каналов)."none"илиChannelDimension.NONE: изображение в формате (height, width).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — Устройство, на котором будут обрабатываться видео. Если не задано, устройство определяется на основе входных видео. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Возвращает стопку тензоров, если установлено значение'pt', иначе возвращает список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора. - clusters (
np.ndarray, kwargs илиlist[list[int]]илиtorch.Tensor, optional, по умолчаниюself.clusters) — Кластеры цветов, используемые при квантовании цвета, с формой(n_clusters, 3). Могут быть переопределены параметромclustersвpreprocess. - do_color_quantize (
bool, kwargs, optional, по умолчаниюself.do_color_quantize) — Управляет применением квантования цвета для преобразования непрерывных значений пикселей в дискретные индексы кластеров. Если значение равно True, каждый пиксель назначается ближайшему цветовому кластеру, что позволяет использовать дискретное токенизирование в ImageGPT.
Создаёт процессор изображений ImageGPTImageProcessor.
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]*argsimage_like_kwargs: dict[str, typing.Any] | None = None**kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> ) → ~image_processing_base.BatchFeature
Параметры
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Изображение для предобработки. Ожидается одно изображение или батч изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установитеdo_rescale=False. - image_like_kwargs (
dict[str, Any], необязательный) — Флаг для разработчиков, позволяющий передать дополнительные входные данные, похожие на изображения, которые также будут предобработаны. Используйте этот параметр только в том случае, если передача входных данных через kwarg не работает. Например,preprocess(images, masks=masks)— предпочтительный вариант, но для некоторых моделей он приводит к проблемам с приоритетом аргументов. В таких случаях можно использоватьpreprocess(images, image_like_inputs={"masks": masks}). - do_convert_rgb (
bool, kwargs, optional) — Следует ли преобразовать изображение в RGB. - do_resize (
bool, kwargs, optional) — Указывает, нужно ли изменить размер изображения. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Описывает максимальные размеры входных данных для модели. - default_to_square (
bool, kwargs, optional) — Определяет, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size является целым числом. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Размер выходного изображения после примененияcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисленияPILImageResampling. Влияет только в том случае, еслиdo_resizeустановлено вTrue. - do_rescale (
bool, kwargs, optional) — Нужно ли перемасштабировать изображение. - rescale_factor (
float, kwargs, optional) — Коэффициент масштабирования, применяемый к изображению, еслиdo_rescaleустановлен вTrue. - do_normalize (
bool, kwargs, optional) — Нужно ли нормализовать изображение. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — Среднее значение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - do_pad (
bool, kwargs, optional) — Определяет, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия выравнивания зависит от модели. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Размер в формате{"height": int, "width" int}, до которого следует дополнить изображения. Должен быть больше любого размера изображения, предоставленного для предобработки. Еслиpad_sizeне указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только приdo_pad=True. - do_center_crop (
bool, kwargs, optional) — Выполнять ли центрированную обрезку изображения. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, optional) — Поддерживается толькоChannelDimension.FIRST. Добавлено для совместимости с медленными процессорами. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, необязательный) — Формат размерности каналов для входного изображения. Если не задан, формат размерности каналов выводится из входного изображения. Может быть одним из:"channels_first"илиChannelDimension.FIRST: изображение в формате (num_channels, height, width)."channels_last"илиChannelDimension.LAST: изображение в формате (высота, ширина, число каналов)."none"илиChannelDimension.NONE: изображение в формате (height, width).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — Устройство, на котором будут обрабатываться видео. Если не задано, устройство определяется на основе входных видео. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Возвращает стопку тензоров, если установлено значение'pt', иначе возвращает список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
Возвращает
~image_processing_base.BatchFeature
- data (
dict) — Словарь списков/массивов/тензоров, возвращаемый методом call (‘pixel_values’ и т. д.). - tensor_type (
Union[None, str, TensorType], необязательный) — Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
Предобработка изображения или пакета изображений.
ImageGPTModel
класс transformers.ImageGPTModel
< source >( config: ImageGPTConfig )
Параметры
- config (ImageGPTConfig) — Класс конфигурации модели, содержащий все параметры модели. Инициализация с помощью файла конфигурации не загружает веса, связанные с моделью, а только конфигурацию. Чтобы загрузить веса модели, используйте метод from_pretrained().
Модель Imagegpt без дополнительных слоёв, выводящая необработанные скрытые состояния.
Эта модель наследуется от PreTrainedModel. См. документацию родительского класса для общих методов, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка голов и т. д.)
Эта модель также является подклассом torch.nn.Module в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneattention_mask: typing.Optional[torch.Tensor] = Nonetoken_type_ids: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneencoder_hidden_states: typing.Optional[torch.Tensor] = Noneencoder_attention_mask: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs: Any ) → BaseModelOutputWithPastAndCrossAttentions or tuple(torch.Tensor)
Параметры
- input_ids (
torch.LongTensorформы(batch_size, input_ids_length)) —input_ids_length=sequence_lengthеслиpast_key_valuesравноNoneиначеpast_key_values.get_seq_length()(sequence_lengthвходных состояний past key value). Индексы токенов входной последовательности в словаре.Если используется
past_key_values, в качествеinput_idsследует передавать только теinput_ids, для которых ещё не вычислено прошлое.Индексы можно получить с помощью AutoImageProcessor. Подробности см. в ImageGPTImageProcessor.call().
- past_key_values (
~cache_utils.Cache, необязательный) — Предвычисленные скрытые состояния (ключи и значения в блоках само-внимания и кросс-внимания), которые можно использовать для ускорения последовательного декодирования. Обычно этоpast_key_values, возвращённые моделью на предыдущем этапе декодирования, когдаuse_cache=Trueилиconfig.use_cache=True.В качестве входного параметра допускается только экземпляр Cache, см. наше руководство по кэшу KV. Если
past_key_valuesне переданы, по умолчанию будет инициализирован DynamicCache.Модель будет выводить тот же формат кэша, который был передан на вход.
Если используются
past_key_values, ожидается, что пользователь передаст только необработанныеinput_ids(те, для которых в этой модели ещё не заданы состояния прошлых ключей и значений) формы(batch_size, unprocessed_length), а не всеinput_idsформы(batch_size, sequence_length). - attention_mask (
torch.Tensorформы(batch_size, sequence_length), , необязательный) — Маска для исключения токенов-заполнителей из внимания. Значения маски из диапазона[0, 1]:- 1 для токенов, которые не замаскированы,
- 0 для токенов, которые замаскированы.
- token_type_ids (
torch.Tensorформы(batch_size, sequence_length), , необязательный) — Индексы сегментных токенов для указания первой и второй частей входных данных. Индексы выбираются из[0, 1]:- 0 соответствует токену sentence A,
- 1 соответствует токену sentence B.
- position_ids (
torch.Tensorформы(batch_size, sequence_length), , необязательный) — Индексы позиций токенов каждого входного последовательности в позиционных эмбеддингах. Выбираются из диапазона[0, config.n_positions - 1]. - inputs_embeds (
torch.Tensorформы(batch_size, sequence_length, hidden_size), необязательный) — При необходимости, вместо передачиinput_idsможно напрямую передать встроенное представление. Это полезно, если требуется больший контроль над тем, как индексыinput_idsпреобразуются в соответствующие векторы, чем это обеспечивает внутренняя матрица поиска встраиваний модели. - encoder_hidden_states (
torch.Tensorформы(batch_size, sequence_length, hidden_size), необязательный) — Последовательность скрытых состояний на выходе последнего слоя энкодера. Используется в кросс-внимании, если модель настроена как декодер. - encoder_attention_mask (
torch.Tensorформы(batch_size, sequence_length), , необязательный) — Маска для исключения внимания к индексам токенов отступов во входных данных энкодера. Эта маска используется в кросс-внимании, если модель настроена как декодер. Значения маски из[0, 1]:- 1 для токенов, которые не замаскированы,
- 0 для токенов, которые замаскированы.
- use_cache (
bool, необязательный) — Если установлено вTrue, возвращаются состояния ключей и значенийpast_key_values, которые можно использовать для ускорения декодирования (см.past_key_values). - output_attentions (
bool, необязательный) — Указывает, следует ли возвращать тензоры внимания всех слоев внимания. Подробности см. в описанииattentionsв разделе возвращаемых тензоров. - output_hidden_states (
bool, необязательный) — Указывает, следует ли возвращать скрытые состояния всех слоев. Подробности см. в описанииhidden_statesсреди возвращаемых тензоров. - return_dict (
bool, необязательный) — Указывает, следует ли возвращать ModelOutput вместо обычного кортежа.
Возвращает
BaseModelOutputWithPastAndCrossAttentions или tuple(torch.Tensor)
Объект BaseModelOutputWithPastAndCrossAttentions или кортеж
torch.Tensor (если передано return_dict=False или если config.return_dict=False), содержащий различные
элементы в зависимости от конфигурации (ImageGPTConfig) и входных данных.
Метод forward модели ImageGPTModel переопределяет специальный метод __call__.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр
Module, а не эту функцию, поскольку первый вариант обеспечивает выполнение шагов предварительной и последующей обработки, тогда как второй молча их игнорирует.
last_hidden_state (
torch.Tensorформы(batch_size, sequence_length, hidden_size)) — Последовательность скрытых состояний на выходе последнего слоя модели.Если используется
past_key_values, выводится только последнее скрытое состояние последовательностей формы(batch_size, 1, hidden_size).past_key_values (
Cache, необязательный, возвращается при передачеuse_cache=Trueили когдаconfig.use_cache=True) — это экземпляр Cache. Подробнее см. в нашем руководстве по кэшу kv.Содержит предварительно вычисленные скрытые состояния (ключи и значения в блоках само-внимания и, при необходимости, если
config.is_encoder_decoder=True, в блоках кросс-внимания), которые можно использовать (см. входной параметрpast_key_values) для ускорения последовательного декодирования.hidden_states (
tuple(torch.Tensor), optional, возвращается, если переданоoutput_hidden_states=Trueили еслиconfig.output_hidden_states=True) — кортеж изtorch.Tensor(один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы(batch_size, sequence_length, hidden_size).Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
attentions (
tuple(torch.Tensor), необязательный, возвращается при передачеoutput_attentions=Trueили приconfig.output_attentions=True) — Кортежtorch.Tensor(по одному на каждый слой) формы(batch_size, num_heads, sequence_length, sequence_length).Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
cross_attentions (
tuple(torch.Tensor), необязательный, возвращается, если переданоoutput_attentions=Trueиconfig.add_cross_attention=Trueили еслиconfig.output_attentions=True) — Кортежtorch.Tensor(по одному на каждый слой) формы(batch_size, num_heads, sequence_length, sequence_length).Веса внимания кросс-внимания декодера после softmax внимания, используемые для вычисления взвешенного среднего в головах кросс-внимания.
Примеры:
>>> from transformers import AutoImageProcessor, ImageGPTModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> image_processor = AutoImageProcessor.from_pretrained("openai/imagegpt-small")
>>> model = ImageGPTModel.from_pretrained("openai/imagegpt-small")

>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
ImageGPTForCausalImageModeling
класс transformers.ImageGPTForCausalImageModeling
< source >( config: ImageGPTConfig )
Параметры
- config (ImageGPTConfig) — Класс конфигурации модели, содержащий все параметры модели. Инициализация с помощью файла конфигурации не загружает веса, связанные с моделью, а только конфигурацию. Чтобы загрузить веса модели, используйте метод from_pretrained().
Модель ImageGPT: трансформер с головой для моделирования языка (линейный слой с весами, связанными с входными эмбеддингами).
Эта модель наследуется от PreTrainedModel. См. документацию родительского класса для общих методов, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка голов и т. д.)
Эта модель также является подклассом torch.nn.Module в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneattention_mask: typing.Optional[torch.Tensor] = Nonetoken_type_ids: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneencoder_hidden_states: typing.Optional[torch.Tensor] = Noneencoder_attention_mask: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs: Any ) → CausalLMOutputWithCrossAttentions or tuple(torch.Tensor)
Параметры
- input_ids (
torch.LongTensorформы(batch_size, input_ids_length)) —input_ids_length=sequence_lengthеслиpast_key_valuesравноNoneиначеpast_key_values.get_seq_length()(sequence_lengthвходных состояний past key value). Индексы токенов входной последовательности в словаре.Если используется
past_key_values, в качествеinput_idsследует передавать только теinput_ids, для которых ещё не вычислено прошлое.Индексы можно получить с помощью AutoImageProcessor. Подробности см. в ImageGPTImageProcessor.call().
- past_key_values (
~cache_utils.Cache, необязательный) — Предвычисленные скрытые состояния (ключи и значения в блоках само-внимания и кросс-внимания), которые можно использовать для ускорения последовательного декодирования. Обычно этоpast_key_values, возвращённые моделью на предыдущем этапе декодирования, когдаuse_cache=Trueилиconfig.use_cache=True.В качестве входного параметра допускается только экземпляр Cache, см. наше руководство по кэшу KV. Если
past_key_valuesне переданы, по умолчанию будет инициализирован DynamicCache.Модель будет выводить тот же формат кэша, который был передан на вход.
Если используются
past_key_values, ожидается, что пользователь передаст только необработанныеinput_ids(те, для которых в этой модели ещё не заданы состояния прошлых ключей и значений) формы(batch_size, unprocessed_length), а не всеinput_idsформы(batch_size, sequence_length). - attention_mask (
torch.Tensorформы(batch_size, sequence_length), , необязательный) — Маска для исключения токенов-заполнителей из внимания. Значения маски из диапазона[0, 1]:- 1 для токенов, которые не замаскированы,
- 0 для токенов, которые замаскированы.
- token_type_ids (
torch.Tensorформы(batch_size, sequence_length), , необязательный) — Индексы сегментных токенов для указания первой и второй частей входных данных. Индексы выбираются из[0, 1]:- 0 соответствует токену sentence A,
- 1 соответствует токену sentence B.
- position_ids (
torch.Tensorформы(batch_size, sequence_length), , необязательный) — Индексы позиций токенов каждого входного последовательности в позиционных эмбеддингах. Выбираются из диапазона[0, config.n_positions - 1]. - inputs_embeds (
torch.Tensorформы(batch_size, sequence_length, hidden_size), необязательный) — При необходимости, вместо передачиinput_idsможно напрямую передать встроенное представление. Это полезно, если требуется больший контроль над тем, как индексыinput_idsпреобразуются в соответствующие векторы, чем это обеспечивает внутренняя матрица поиска встраиваний модели. - encoder_hidden_states (
torch.Tensorформы(batch_size, sequence_length, hidden_size), необязательный) — Последовательность скрытых состояний на выходе последнего слоя энкодера. Используется в кросс-внимании, если модель настроена как декодер. - encoder_attention_mask (
torch.Tensorформы(batch_size, sequence_length), , необязательный) — Маска для исключения внимания к индексам токенов отступов во входных данных энкодера. Эта маска используется в кросс-внимании, если модель настроена как декодер. Значения маски из[0, 1]:- 1 для токенов, которые не замаскированы,
- 0 для токенов, которые замаскированы.
- labels (
torch.LongTensorформы(batch_size, input_ids_length), необязательный) — Метки для моделирования языка. Обратите внимание, что метки сдвигаются внутри модели, то есть можно задатьlabels = input_idsИндексы выбираются из[-100, 0, ..., config.vocab_size]Все метки, установленные в-100, игнорируются (маскируются); потеря вычисляется только для меток из[0, ..., config.vocab_size] - use_cache (
bool, необязательный) — Если установлено вTrue, возвращаются состояния ключей и значенийpast_key_values, которые можно использовать для ускорения декодирования (см.past_key_values). - output_attentions (
bool, необязательный) — Указывает, следует ли возвращать тензоры внимания всех слоев внимания. Подробности см. в описанииattentionsв разделе возвращаемых тензоров. - output_hidden_states (
bool, необязательный) — Указывает, следует ли возвращать скрытые состояния всех слоев. Подробности см. в описанииhidden_statesсреди возвращаемых тензоров. - return_dict (
bool, необязательный) — Указывает, следует ли возвращать ModelOutput вместо обычного кортежа.
Возвращает
CausalLMOutputWithCrossAttentions или tuple(torch.Tensor)
Объект CausalLMOutputWithCrossAttentions или кортеж из
torch.Tensor (если передано return_dict=False или если config.return_dict=False), содержащий различные
элементы в зависимости от конфигурации (ImageGPTConfig) и входных данных.
Метод forward класса ImageGPTForCausalImageModeling переопределяет специальный метод __call__.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр
Module, а не эту функцию, поскольку первый вариант обеспечивает выполнение шагов предварительной и последующей обработки, тогда как второй молча их игнорирует.
loss (
torch.Tensorформы(1,), необязательный, возвращается, если заданlabels) — Потери языковой модели (для предсказания следующего токена).logits (
torch.Tensorформы(batch_size, sequence_length, config.vocab_size)) — Оценки предсказаний языковой модели (оценки для каждого токена словаря до применения SoftMax).hidden_states (
tuple(torch.Tensor), optional, возвращается, если переданоoutput_hidden_states=Trueили еслиconfig.output_hidden_states=True) — кортеж изtorch.Tensor(один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы(batch_size, sequence_length, hidden_size).Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
attentions (
tuple(torch.Tensor), необязательный, возвращается при передачеoutput_attentions=Trueили приconfig.output_attentions=True) — Кортежtorch.Tensor(по одному на каждый слой) формы(batch_size, num_heads, sequence_length, sequence_length).Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
cross_attentions (
tuple(torch.Tensor), необязательный, возвращается при передачеoutput_attentions=Trueили приconfig.output_attentions=True) — Кортежtorch.Tensor(по одному на каждый слой) формы(batch_size, num_heads, sequence_length, sequence_length).Веса кросс-внимания после softmax внимания, используемые для вычисления взвешенного среднего в головах кросс-внимания.
past_key_values (
Cache, необязательный, возвращается при передачеuse_cache=Trueили когдаconfig.use_cache=True) — это экземпляр Cache. Подробнее см. в нашем руководстве по кэшу kv.Содержит предварительно вычисленные скрытые состояния (ключи и значения в блоках внимания), которые можно использовать (см. вход
past_key_values) для ускорения последовательного декодирования.
Примеры:
>>> from transformers import AutoImageProcessor, ImageGPTForCausalImageModeling
>>> import torch
>>> import matplotlib.pyplot as plt
>>> import numpy as np

>>> image_processor = AutoImageProcessor.from_pretrained("openai/imagegpt-small")
>>> model = ImageGPTForCausalImageModeling.from_pretrained("openai/imagegpt-small")
>>> device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
>>> model.to(device)
>>> # unconditional generation of 8 images
>>> batch_size = 4
>>> context = torch.full((batch_size, 1), model.config.vocab_size - 1)  # initialize with SOS token
>>> context = context.to(device)
>>> output = model.generate(
...     input_ids=context, max_length=model.config.n_positions + 1, temperature=1.0, do_sample=True, top_k=40
... )

>>> clusters = image_processor.clusters
>>> height = image_processor.size["height"]
>>> width = image_processor.size["width"]

>>> samples = output[:, 1:].detach().cpu().numpy()
>>> samples_img = [
...     np.reshape(np.rint(127.5 * (clusters[s] + 1.0)), [height, width, 3]).astype(np.uint8) for s in samples
... ]  # convert color cluster tokens back to pixels
>>> f, axes = plt.subplots(1, batch_size, dpi=300)

>>> for img, ax in zip(samples_img, axes):
...     ax.axis("off")
...     ax.imshow(img)
ImageGPTForImageClassification
класс transformers.ImageGPTForImageClassification
< source >( config: ImageGPTConfig )
Параметры
- config (ImageGPTConfig) — Класс конфигурации модели, содержащий все параметры модели. Инициализация с помощью файла конфигурации не загружает веса, связанные с моделью, а только конфигурацию. Чтобы загрузить веса модели, используйте метод from_pretrained().
Модель ImageGPT — это трансформер с головой для классификации изображений (линейный слой) сверху. ImageGPTForImageClassification выполняет усреднение скрытых состояний для классификации.
Эта модель наследуется от PreTrainedModel. См. документацию родительского класса для общих методов, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка голов и т. д.)
Эта модель также является подклассом torch.nn.Module в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
forward
< source >( input_ids: typing.Optional[torch.Tensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneattention_mask: typing.Optional[torch.Tensor] = Nonetoken_type_ids: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.Tensor] = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs: Any ) → SequenceClassifierOutputWithPast or tuple(torch.Tensor)
Параметры
- input_ids (
torch.LongTensorформы(batch_size, input_ids_length)) —input_ids_length=sequence_lengthеслиpast_key_valuesравноNoneиначеpast_key_values.get_seq_length()(sequence_lengthвходных состояний past key value). Индексы токенов входной последовательности в словаре.Если используется
past_key_values, в качествеinput_idsследует передавать только теinput_ids, для которых ещё не вычислено прошлое.Индексы можно получить с помощью AutoImageProcessor. Подробности см. в ImageGPTImageProcessor.call().
- past_key_values (
~cache_utils.Cache, необязательный) — Предвычисленные скрытые состояния (ключи и значения в блоках само-внимания и кросс-внимания), которые можно использовать для ускорения последовательного декодирования. Обычно этоpast_key_values, возвращённые моделью на предыдущем этапе декодирования, когдаuse_cache=Trueилиconfig.use_cache=True.В качестве входного параметра допускается только экземпляр Cache, см. наше руководство по кэшу KV. Если
past_key_valuesне переданы, по умолчанию будет инициализирован DynamicCache.Модель будет выводить тот же формат кэша, который был передан на вход.
Если используются
past_key_values, ожидается, что пользователь передаст только необработанныеinput_ids(те, для которых в этой модели ещё не заданы состояния прошлых ключей и значений) формы(batch_size, unprocessed_length), а не всеinput_idsформы(batch_size, sequence_length). - attention_mask (
torch.Tensorформы(batch_size, sequence_length), , необязательный) — Маска для исключения токенов-заполнителей из внимания. Значения маски из диапазона[0, 1]:- 1 для токенов, которые не замаскированы,
- 0 для токенов, которые замаскированы.
- token_type_ids (
torch.Tensorформы(batch_size, sequence_length), , необязательный) — Индексы сегментных токенов для указания первой и второй частей входных данных. Индексы выбираются из[0, 1]:- 0 соответствует токену sentence A,
- 1 соответствует токену sentence B.
- position_ids (
torch.Tensorформы(batch_size, sequence_length), , необязательный) — Индексы позиций токенов каждого входного последовательности в позиционных эмбеддингах. Выбираются из диапазона[0, config.n_positions - 1]. - inputs_embeds (
torch.Tensorформы(batch_size, sequence_length, hidden_size), необязательный) — При необходимости, вместо передачиinput_idsможно напрямую передать встроенное представление. Это полезно, если требуется больший контроль над тем, как индексыinput_idsпреобразуются в соответствующие векторы, чем это обеспечивает внутренняя матрица поиска встраиваний модели. - labels (
torch.LongTensorформы(batch_size,), необязательный) — Метки для вычисления функции потерь классификации/регрессии последовательности. Индексы должны находиться в диапазоне[0, ..., config.num_labels - 1]. Еслиconfig.num_labels == 1, вычисляется функция потерь регрессии (среднеквадратичная ошибка), еслиconfig.num_labels > 1, вычисляется функция потерь классификации (кросс-энтропия). - use_cache (
bool, необязательный) — Если установлено вTrue, возвращаются состояния ключей и значенийpast_key_values, которые можно использовать для ускорения декодирования (см.past_key_values). - output_attentions (
bool, необязательный) — Указывает, следует ли возвращать тензоры внимания всех слоев внимания. Подробности см. в описанииattentionsв разделе возвращаемых тензоров. - output_hidden_states (
bool, необязательный) — Указывает, следует ли возвращать скрытые состояния всех слоев. Подробности см. в описанииhidden_statesсреди возвращаемых тензоров. - return_dict (
bool, необязательный) — Указывает, следует ли возвращать ModelOutput вместо обычного кортежа.
Возвращает
SequenceClassifierOutputWithPast или tuple(torch.Tensor)
SequenceClassifierOutputWithPast или кортеж из
torch.Tensor (если передано return_dict=False или если config.return_dict=False), содержащий различные
элементы в зависимости от конфигурации (ImageGPTConfig) и входных данных.
Метод forward класса ImageGPTForImageClassification переопределяет специальный метод __call__.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр
Module, а не эту функцию, поскольку первый вариант обеспечивает выполнение шагов предварительной и последующей обработки, тогда как второй молча их игнорирует.
loss (
torch.Tensorформы(1,), необязательный, возвращается, если заданlabels) — Потери классификации (или регрессии, если config.num_labels==1).logits (
torch.Tensorформы(batch_size, config.num_labels)) — Оценки для классификации (или регрессии, если config.num_labels==1) до применения SoftMax.past_key_values (
Cache, необязательный, возвращается при передачеuse_cache=Trueили когдаconfig.use_cache=True) — это экземпляр Cache. Подробнее см. в нашем руководстве по кэшу kv.Содержит предварительно вычисленные скрытые состояния (ключи и значения в блоках само-внимания), которые можно использовать (см. вход
past_key_values) для ускорения последовательного декодирования.hidden_states (
tuple(torch.Tensor), optional, возвращается, если переданоoutput_hidden_states=Trueили еслиconfig.output_hidden_states=True) — кортеж изtorch.Tensor(один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы(batch_size, sequence_length, hidden_size).Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
attentions (
tuple(torch.Tensor), необязательный, возвращается при передачеoutput_attentions=Trueили приconfig.output_attentions=True) — Кортежtorch.Tensor(по одному на каждый слой) формы(batch_size, num_heads, sequence_length, sequence_length).Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
>>> from transformers import AutoImageProcessor, ImageGPTForImageClassification
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO

>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
...     image = Image.open(BytesIO(response.read()))

>>> image_processor = AutoImageProcessor.from_pretrained("openai/imagegpt-small")
>>> model = ImageGPTForImageClassification.from_pretrained("openai/imagegpt-small")

>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> logits = outputs.logits