
Transformers documentation
Wav2Vec2
Mô hình này được công bố trên HF papers vào ngày 2020-06-20 và được đóng góp cho Hugging Face Transformers vào ngày 2021-02-02.
Wav2Vec2


Tổng quan
Mô hình Wav2Vec2 được đề xuất trong wav2vec 2.0: A Framework for Self-Supervised Learning of Speech Representations bởi Alexei Baevski, Henry Zhou, Abdelrahman Mohamed, Michael Auli.
Tóm tắt từ bài báo như sau:
Chúng tôi lần đầu tiên chỉ ra rằng việc học các biểu diễn mạnh mẽ chỉ từ âm thanh nói, sau đó tinh chỉnh trên giọng nói đã được chuyển tự, có thể vượt trội hơn các phương pháp bán giám sát tốt nhất trong khi đơn giản hơn về mặt khái niệm. wav2vec 2.0 che mờ (mask) đầu vào giọng nói trong không gian ẩn và giải quyết một bài toán tương phản được định nghĩa trên lượng tử hóa của các biểu diễn ẩn, vốn được học đồng thời. Các thí nghiệm sử dụng toàn bộ dữ liệu có nhãn của Librispeech đạt WER 1,8/3,3 trên các tập kiểm tra clean/other. Khi giảm lượng dữ liệu có nhãn xuống còn một giờ, wav2vec 2.0 vượt trội hơn trạng thái nghệ thuật trước đó trên tập con 100 giờ trong khi sử dụng ít hơn 100 lần dữ liệu có nhãn. Chỉ sử dụng mười phút dữ liệu có nhãn và tiền huấn luyện trên 53k giờ dữ liệu không nhãn vẫn đạt WER 4,8/8,2. Điều này chứng minh tính khả thi của nhận dạng giọng nói với lượng dữ liệu có nhãn hạn chế.
Mô hình này được đóng góp bởi patrickvonplaten.
Lưu ý: Meta (FAIR) đã phát hành một phiên bản mới của Wav2Vec2-BERT 2.0 - nó được huấn luyện trước trên 4,5 triệu giờ âm thanh. Chúng tôi đặc biệt khuyến nghị sử dụng nó cho các tác vụ tinh chỉnh, ví dụ như theo hướng dẫn này.
Đặt
use_kernels=Truetrong from_pretrained() để thay thế các lớp được hỗ trợ bằng các kernel tối ưu từ Hub. Xem Tải kernel để biết thêm.
Mẹo sử dụng
- Wav2Vec2 là một mô hình giọng nói, nhận vào một mảng float tương ứng với dạng sóng thô của tín hiệu giọng nói.
- Mô hình Wav2Vec2 được huấn luyện bằng phân loại thời gian liên kết (CTC) nên đầu ra của mô hình phải được giải mã bằng Wav2Vec2CTCTokenizer.
Sử dụng Flash Attention 2
Flash Attention 2 là phiên bản nhanh hơn, được tối ưu hóa của mô hình.
Cài đặt
Đầu tiên, hãy kiểm tra xem phần cứng của bạn có tương thích với Flash Attention 2 hay không. Danh sách phần cứng tương thích mới nhất có thể được tìm thấy trong tài liệu chính thức.
Tiếp theo, cài đặt phiên bản mới nhất của Flash Attention 2:
pip install -U flash-attn --no-build-isolation
Cách sử dụng
Để tải một mô hình sử dụng Flash Attention 2, chúng ta có thể truyền tham số attn_implementation="flash_attention_2" vào from_pretrained(). Chúng ta cũng sẽ tải mô hình ở độ chính xác nửa (ví dụ torch.float16), vì điều này hầu như không làm giảm chất lượng âm thanh nhưng giúp giảm đáng kể lượng bộ nhớ sử dụng và tăng tốc độ suy luận:
from transformers import Wav2Vec2Model


model = Wav2Vec2Model.from_pretrained("facebook/wav2vec2-large-960h-lv60-self", attn_implementation="flash_attention_2", device_map="auto")
...
Tốc độ tăng tốc dự kiến
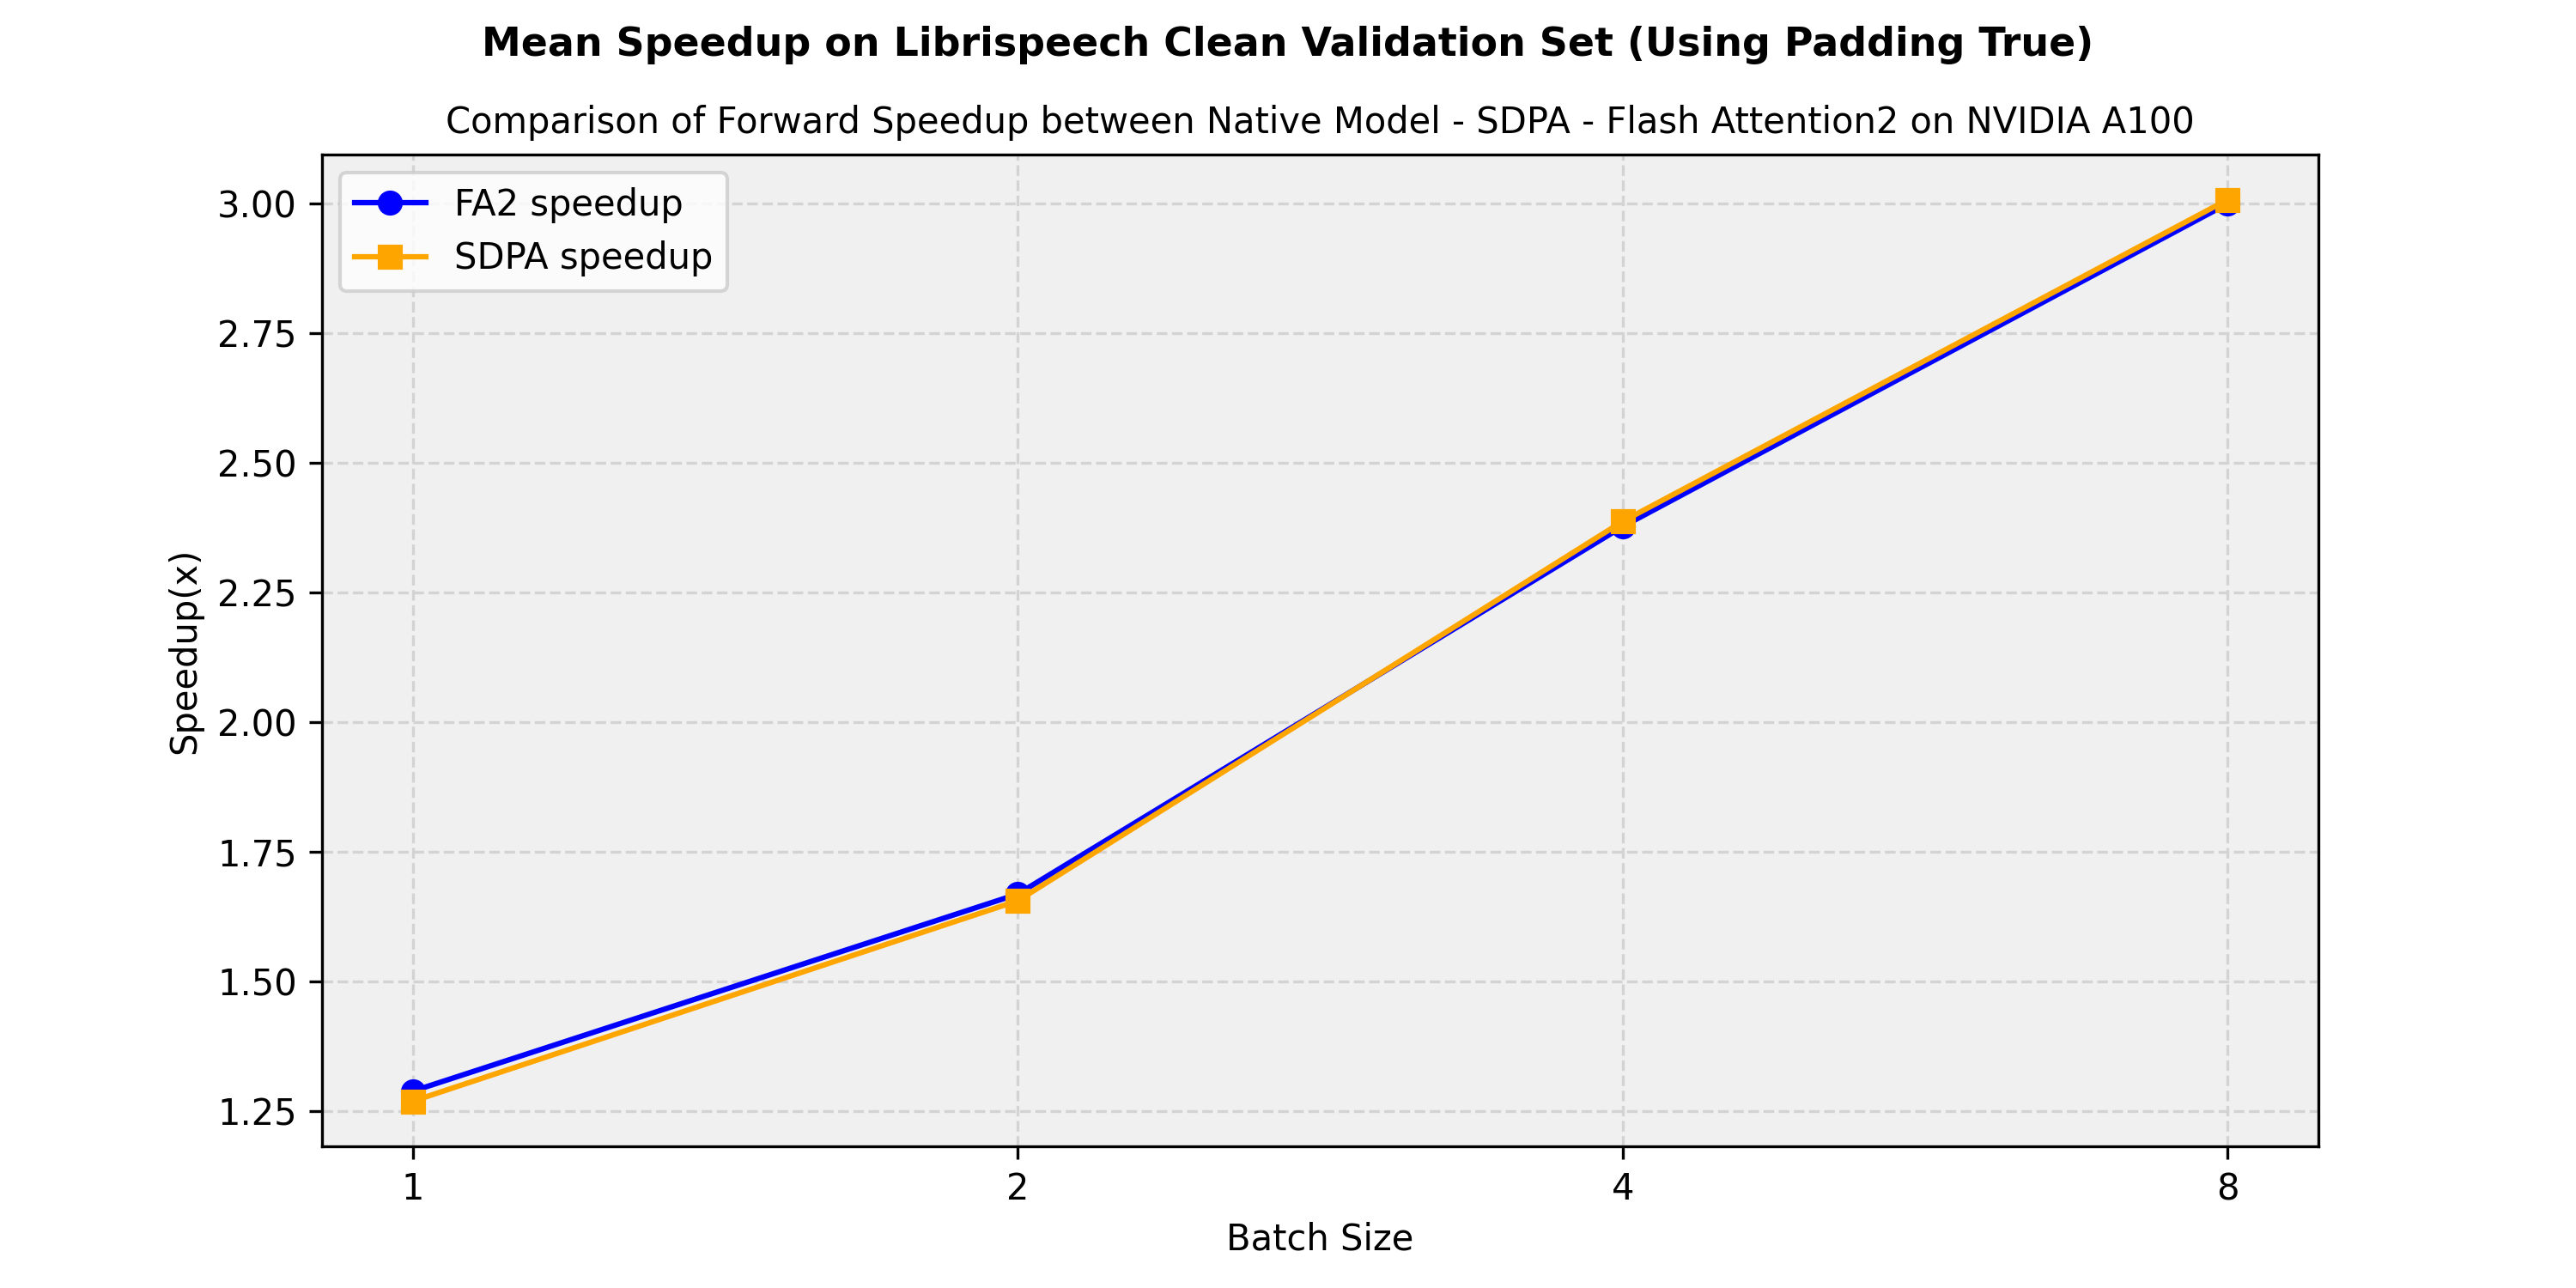
Dưới đây là biểu đồ tốc độ dự kiến so sánh thời gian suy luận thuần túy giữa bản triển khai gốc trong transformers của mô hình facebook/wav2vec2-large-960h-lv60-self và các phiên bản flash-attention-2 và sdpa (scale-dot-product-attention). Chúng tôi hiển thị tốc độ tăng trung bình đạt được trên tập kiểm tra librispeech_asr clean:
Tài nguyên
Danh sách các tài nguyên chính thức của Hugging Face và cộng đồng (được đánh dấu bằng 🌎) để giúp bạn bắt đầu với Wav2Vec2. Nếu bạn quan tâm đến việc gửi tài nguyên để được đưa vào đây, hãy thoải mái mở một Pull Request và chúng tôi sẽ xem xét! Tài nguyên lý tưởng nên minh họa một điều gì đó mới thay vì sao chép một tài nguyên hiện có.
- Một notebook về cách lợi dụng một mô hình Wav2Vec2 được huấn luyện trước cho phân loại cảm xúc. 🌎
- Wav2Vec2ForCTC được hỗ trợ bởi notebook này.
- Hướng dẫn tác vụ phân loại âm thanh
- Một bài viết trên blog về cách tăng cường Wav2Vec2 bằng n-grams trong 🤗 Transformers.
- Một bài viết trên blog về cách finetune Wav2Vec2 cho ASR tiếng Anh với 🤗 Transformers.
- Một bài viết trên blog về finetuning XLS-R cho Multi-Lingual ASR với 🤗 Transformers.
- Một notebook về cách tạo phụ đề YouTube từ bất kỳ video nào bằng cách chuyển văn bản từ âm thanh bằng Wav2Vec2. 🌎
- Wav2Vec2ForCTC được hỗ trợ bởi một notebook về cách tinh chỉnh mô hình nhận dạng giọng nói bằng tiếng Anh và cách tinh chỉnh mô hình nhận dạng giọng nói bằng bất kỳ ngôn ngữ nào.
- Hướng dẫn tác vụ nhận dạng giọng nói tự động
🚀 Triển khai
- Một bài viết trên blog về cách triển khai Wav2Vec2 cho Nhận dạng giọng nói tự động với Transformers của Hugging Face & Amazon SageMaker.
Wav2Vec2Config
lớp transformers.Wav2Vec2Config
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int | None = 32hidden_size: int = 768num_hidden_layers: int = 12num_attention_heads: int = 12intermediate_size: int = 3072hidden_act: str = 'gelu'hidden_dropout: float | int = 0.1activation_dropout: float | int = 0.1attention_dropout: float | int = 0.1feat_proj_dropout: float | int = 0.0feat_quantizer_dropout: float | int = 0.0final_dropout: float | int = 0.1layerdrop: float | int = 0.1initializer_range: float = 0.02layer_norm_eps: float = 1e-05feat_extract_norm: str = 'group'feat_extract_activation: str = 'gelu'conv_dim: list[int] | tuple[int, ...] = (512, 512, 512, 512, 512, 512, 512)conv_stride: list[int] | tuple[int, ...] = (5, 2, 2, 2, 2, 2, 2)conv_kernel: list[int] | tuple[int, ...] = (10, 3, 3, 3, 3, 2, 2)conv_bias: bool = Falsenum_conv_pos_embeddings: int = 128num_conv_pos_embedding_groups: int = 16do_stable_layer_norm: bool = Falseapply_spec_augment: bool = Truemask_time_prob: float | int = 0.05mask_time_length: int = 10mask_time_min_masks: int = 2mask_feature_prob: float | int = 0.0mask_feature_length: int = 10mask_feature_min_masks: int = 0num_codevectors_per_group: int = 320num_codevector_groups: int = 2contrastive_logits_temperature: float = 0.1num_negatives: int = 100codevector_dim: int = 256proj_codevector_dim: int = 256diversity_loss_weight: float = 0.1ctc_loss_reduction: str = 'sum'ctc_zero_infinity: bool = Falseuse_weighted_layer_sum: bool = Falseclassifier_proj_size: int = 256tdnn_dim: list[int] | tuple[int, ...] = (512, 512, 512, 512, 1500)tdnn_kernel: list[int] | tuple[int, ...] = (5, 3, 3, 1, 1)tdnn_dilation: list[int] | tuple[int, ...] = (1, 2, 3, 1, 1)xvector_output_dim: int = 512pad_token_id: int | None = 0bos_token_id: int | None = 1eos_token_id: int | list[int] | None = 2add_adapter: bool = Falseadapter_kernel_size: int = 3adapter_stride: int = 2num_adapter_layers: int = 3output_hidden_size: int | None = Noneadapter_attn_dim: int | None = None )
Tham số
- vocab_size (
int, tuỳ chọn, mặc định là32) — Kích thước từ vựng của mô hình. Xác định số lượng token khác nhau có thể được biểu diễn bởiinput_ids. - hidden_size (
int, tùy chọn, mặc định là768) — Kích thước của các biểu diễn ẩn. - num_hidden_layers (
int, tùy chọn, mặc định là12) — Số lượng lớp ẩn trong bộ giải mã Transformer. - num_attention_heads (
int, tùy chọn, mặc định là12) — Số lượng đầu attention cho mỗi lớp attention trong bộ giải mã Transformer. - intermediate_size (
int, tùy chọn, mặc định là3072) — Kích thước của các biểu diễn MLP. - hidden_act (
str, tùy chọn, mặc định làgelu) — Hàm kích hoạt phi tuyến (hàm hoặc chuỗi) trong bộ giải mã. Ví dụ,"gelu","relu","silu", v.v. - hidden_dropout (
Union[float, int], tùy chọn, mặc định là0.1) — Xác suất dropout cho tất cả các lớp fully connected trong embeddings, encoder và pooler. - activation_dropout (
Union[float, int], tùy chọn, mặc định là0.1) — Tỷ lệ dropout cho các kích hoạt bên trong lớp liên kết đầy đủ. - attention_dropout (
Union[float, int], tùy chọn, mặc định là0.1) — Tỷ lệ dropout cho các xác suất chú ý. - feat_proj_dropout (
float, tùy chọn, mặc định là 0.0) — Xác suất dropout cho đầu ra của bộ mã hóa đặc trưng. - feat_quantizer_dropout (
float, tuỳ chọn, mặc định là 0.0) — Xác suất dropout cho đầu ra của bộ mã hóa đặc trưng được sử dụng bởi bộ lượng tử hóa. - final_dropout (
float, tùy chọn, mặc định là 0.1) — Xác suất dropout cho lớp chiếu cuối cùng của Wav2Vec2ForCTC. - layerdrop (
Union[float, int], tùy chọn, mặc định là0.1) — Xác suất LayerDrop. Xem [bài báo LayerDrop](xem https://huggingface.co/papers/1909.11556) để biết thêm chi tiết. - initializer_range (
float, tùy chọn, mặc định là0.02) — Độ lệch chuẩn của truncated_normal_initializer để khởi tạo tất cả các ma trận trọng số. - layer_norm_eps (
float, tùy chọn, mặc định là1e-05) — Giá trị epsilon được sử dụng bởi các lớp chuẩn hóa lớp (layer normalization). - feat_extract_norm (
str, tuỳ chọn, mặc định là"group") — Loại chuẩn hóa được áp dụng cho các lớp tích chập 1D trong bộ mã hóa đặc trưng. Một trong số"group"cho chuẩn hóa nhóm chỉ trên lớp tích chập 1D đầu tiên hoặc"layer"cho chuẩn hóa lớp trên tất cả các lớp tích chập 1D. - feat_extract_activation (
str,optional, defaults to“gelu”) -- The non-linear activation function (function or string) in the 1D convolutional layers of the feature extractor. If string,“gelu”,“relu”,“selu”and“gelu_new”` are supported. - conv_dim (
tuple[int]hoặclist[int], tuỳ chọn, mặc định là(512, 512, 512, 512, 512, 512, 512)) — Một tuple các số nguyên xác định số kênh đầu vào và đầu ra của mỗi lớp tích chập 1D trong bộ mã hóa đặc trưng. Độ dài của conv_dim xác định số lượng lớp tích chập 1D. - conv_stride (
tuple[int]hoặclist[int], tuỳ chọn, mặc định là(5, 2, 2, 2, 2, 2, 2)) — Một tuple các số nguyên xác định stride của từng lớp tích chập 1D trong bộ mã hóa đặc trưng. Độ dài của conv_stride xác định số lượng lớp tích chập và phải khớp với độ dài của conv_dim. - conv_kernel (
tuple[int]hoặclist[int], tuỳ chọn, mặc định là(10, 3, 3, 3, 3, 3, 3)) — Một tuple các số nguyên xác định kích thước kernel của từng lớp tích chập 1D trong bộ mã hóa đặc trưng. Độ dài của conv_kernel xác định số lượng lớp tích chập và phải khớp với độ dài của conv_dim. - conv_bias (
bool, tùy chọn, mặc định làFalse) — Xác định xem các lớp tích chập 1D có bias hay không. - num_conv_pos_embeddings (
int, tùy chọn, mặc định là 128) — Số lượng nhúng vị trí tích chập. Xác định kích thước nhân của lớp nhúng vị trí tích chập 1D. - num_conv_pos_embedding_groups (
int, tùy chọn, mặc định là 16) — Số lượng nhóm của lớp nhúng vị trí tích chập 1 chiều. - do_stable_layer_norm (
bool, tùy chọn, mặc định làFalse) — Có áp dụng kiến trúc layer norm ổn định của bộ mã hóa Transformer hay không.do_stable_layer_norm is Truetương ứng với việc áp dụng layer norm trước lớp attention, trong khido_stable_layer_norm is Falsetương ứng với việc áp dụng layer norm sau lớp attention. - apply_spec_augment (
bool, tùy chọn, mặc định làTrue) — Liệu có áp dụng tăng cường dữ liệu SpecAugment cho đầu ra của bộ mã hóa đặc trưng hay không. Để tham khảo, xem SpecAugment: A Simple Data Augmentation Method for Automatic Speech Recognition. - mask_time_prob (
float, optional, defaults to 0.05) — Percentage (between 0 and 1) of all feature vectors along the time axis which will be masked. The masking procedure generates ”mask_time_problen(time_axis)/mask_time_length” independent masks over the axis. If reasoning from the probability of each feature vector to be chosen as the start of the vector span to be masked, mask_time_prob should be `prob_vector_startmask_time_length. Note that overlap may decrease the actual percentage of masked vectors. This is only relevant ifapply_spec_augment is True`. - mask_time_length (
int, tùy chọn, mặc định là 10) — Chiều dài của khoảng vector dọc theo trục thời gian. - mask_time_min_masks (
int, tùy chọn, mặc định là 2), — Số lượng tối thiểu các mask có độ dàimask_feature_lengthđược tạo dọc theo trục thời gian, cho mỗi bước thời gian, bất kểmask_feature_prob. Chỉ có liên quan nếu ”mask_time_prob*len(time_axis)/mask_time_length < mask_time_min_masks” - mask_feature_prob (
float, optional, defaults to 0.0) — Percentage (between 0 and 1) of all feature vectors along the feature axis which will be masked. The masking procedure generates ”mask_feature_problen(feature_axis)/mask_time_length” independent masks over the axis. If reasoning from the probability of each feature vector to be chosen as the start of the vector span to be masked, mask_feature_prob should be `prob_vector_startmask_feature_length. Note that overlap may decrease the actual percentage of masked vectors. This is only relevant ifapply_spec_augment is True`. - mask_feature_prob (
Union[float, int], tùy chọn, mặc định là0.0) — Tỷ lệ phần trăm (từ 0 đến 1) của tất cả các vector đặc trưng dọc theo trục đặc trưng sẽ bị che. Quy trình che tạo ramask_feature_prob*len(feature_axis)/mask_time_lengthcác mặt nạ độc lập trên trục. Nếu suy luận từ xác suất của mỗi vector đặc trưng được chọn làm điểm bắt đầu của khoảng vector sẽ bị che, mask_feature_prob nên làprob_vector_start*mask_feature_length. Lưu ý rằng sự chồng lấn có thể làm giảm tỷ lệ phần trăm thực tế của các vector bị che. Điều này chỉ liên quan nếuapply_spec_augmentlàTrue. - mask_feature_length (
int, tùy chọn, mặc định là 10) — Chiều dài của khoảng vector dọc theo trục đặc trưng. - mask_feature_min_masks (
int, tùy chọn, mặc định là 0), — Số lượng tối thiểu các mặt nạ có độ dàimask_feature_lengthđược tạo ra dọc theo trục đặc trưng, ở mỗi bước thời gian, bất kể giá trị củamask_feature_prob. Chỉ có ý nghĩa nếu ”mask_feature_prob*len(feature_axis)/mask_feature_length < mask_feature_min_masks” - num_codevectors_per_group (
int, tuỳ chọn, mặc định là 320) — Số lượng mục trong mỗi sổ mã lượng tử hóa (nhóm). - num_codevectors_per_group (
int, tuỳ chọn, mặc định là 320) — Số lượng mục trong mỗi sổ mã lượng tử hóa (nhóm). - num_codevector_groups (
int, tùy chọn, mặc định là 2) — Số lượng nhóm codevector cho lượng tử hóa codevector tích. - contrastive_logits_temperature (
float, tùy chọn, mặc định là 0.1) — Nhiệt độ kappa trong tổn thất tương phản. - num_negatives (
int, tùy chọn, mặc định là 100) — Số lượng mẫu âm cho tổn thất tương phản. - codevector_dim (
int, tùy chọn, mặc định là 256) — Số chiều của các vector đặc trưng đã lượng tử hóa. - proj_codevector_dim (
int, tuỳ chọn, mặc định là 256) — Kích thước của phép chiếu cuối cùng cho cả đặc trưng đã lượng tử hóa và đặc trưng transformer. - diversity_loss_weight (
int, tùy chọn, mặc định là 0.1) — Trọng số của thành phần tổn thất đa dạng hóa codebook. - ctc_loss_reduction (
str, tùy chọn, mặc định là"sum") — Chỉ định phương pháp giảm (reduction) áp dụng cho đầu ra củatorch.nn.CTCLoss. Chỉ liên quan khi huấn luyện một thực thể của Wav2Vec2ForCTC. - ctc_zero_infinity (
bool, tuỳ chọn, mặc định làFalse) — Có nên đặt bằng 0 các loss vô hạn và các gradient liên quan củatorch.nn.CTCLosshay không. Các loss vô hạn chủ yếu xảy ra khi các đầu vào quá ngắn để có thể căn chỉnh với các target. Chỉ liên quan khi huấn luyện một instance của Wav2Vec2ForCTC. - use_weighted_layer_sum (
bool, tùy chọn, mặc định làFalse) — Có sử dụng trung bình có trọng số của đầu ra các lớp với trọng số được học hay không. Chỉ liên quan khi sử dụng một instance của Wav2Vec2ForSequenceClassification. - classifier_proj_size (
int, tùy chọn, mặc định là 256) — Kích thước của phép chiếu trước khi lấy trung bình token (mean-pooling) cho phân loại. - tdnn_dim (
tuple[int]hoặclist[int], tùy chọn, mặc định là(512, 512, 512, 512, 1500)) — Một tuple các số nguyên xác định số lượng kênh đầu ra của mỗi lớp tích chập 1D trong module TDNN của mô hình XVector. Độ dài của tdnn_dim xác định số lượng lớp TDNN. - tdnn_kernel (
tuple[int]hoặclist[int], tùy chọn, mặc định là(5, 3, 3, 1, 1)) — Một tuple các số nguyên xác định kích thước kernel của từng lớp tích chập 1D trong module TDNN của mô hình XVector. Độ dài của tdnn_kernel phải khớp với độ dài của tdnn_dim. - tdnn_dilation (
tuple[int]hoặclist[int], tùy chọn, mặc định là(1, 2, 3, 1, 1)) — Một tuple các số nguyên xác định hệ số giãn nở (dilation factor) của từng lớp tích chập 1D trong module TDNN của mô hình XVector. Độ dài của tdnn_dilation phải khớp với độ dài của tdnn_dim. - xvector_output_dim (
int, tùy chọn, mặc định là 512) — Kích thước của các vector nhúng XVector. - pad_token_id (
int, tùy chọn, mặc định là0) — Token id được sử dụng để đệm (padding) trong từ vựng. - bos_token_id (
int, tùy chọn, mặc định là1) — Token id được sử dụng cho beginning-of-stream trong bảng từ vựng. - eos_token_id (
Union[int, list[int]], tùy chọn, mặc định là2) — Token id được sử dụng cho end-of-stream trong bảng từ vựng. - add_adapter (
bool, tùy chọn, mặc định làFalse) — Liệu có nên xếp chồng một mạng tích chập lên trên Wav2Vec2 Encoder hay không. Điều này có thể rất hữu ích để khởi động nóng Wav2Vec2 cho các mô hình SpeechEncoderDecoder. - adapter_kernel_size (
int, tuỳ chọn, mặc định là 3) — Kích thước kernel của các lớp tích chập trong mạng adapter. Chỉ liên quan nếuadd_adapter is True. - adapter_stride (
int, tuỳ chọn, mặc định là 2) — Stride của các lớp convolution trong mạng adapter. Chỉ liên quan nếuadd_adapter is True. - num_adapter_layers (
int, tuỳ chọn, mặc định là 3) — Số lượng lớp tích chập cần được sử dụng trong mạng adapter. Chỉ liên quan nếuadd_adapter is True. - output_hidden_size (
int, tùy chọn) — Kích thước chiều của lớp đầu ra bộ mã hóa. Nếu không được định nghĩa, giá trị mặc định là hidden-size. Chỉ có liên quan nếuadd_adapter is True. - adapter_attn_dim (
int, tùy chọn) — Kích thước của trọng số adapter attention được sử dụng trong mỗi khối attention. Một ví dụ về mô hình sử dụng attention adapters là facebook/mms-1b-all.
Đây là lớp cấu hình để lưu trữ cấu hình của một Wav2Vec2Model. Nó được sử dụng để khởi tạo một mô hình Wav2Vec2 theo các đối số được chỉ định, xác định kiến trúc của mô hình. Khởi tạo một cấu hình với các giá trị mặc định sẽ tạo ra một cấu hình tương tự như cấu hình của facebook/wav2vec2-base-960h
Các đối tượng cấu hình kế thừa từ PreTrainedConfig và có thể được sử dụng để kiểm soát đầu ra của mô hình. Đọc tài liệu từ PreTrainedConfig để biết thêm thông tin.
Ví dụ:
>>> from transformers import Wav2Vec2Config, Wav2Vec2Model

>>> # Initializing a Wav2Vec2 facebook/wav2vec2-base-960h style configuration
>>> configuration = Wav2Vec2Config()

>>> # Initializing a model (with random weights) from the facebook/wav2vec2-base-960h style configuration
>>> model = Wav2Vec2Model(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
Wav2Vec2CTCTokenizer
lớp transformers.Wav2Vec2CTCTokenizer
< source >( vocab_filebos_token = '<s>'eos_token = '</s>'unk_token = '<unk>'pad_token = '<pad>'word_delimiter_token = '|'replace_word_delimiter_char = ' 'do_lower_case = Falsetarget_lang = None**kwargs )
Tham số
- vocab_file (
str) — Tệp chứa từ vựng. - bos_token (
str, tùy chọn, mặc định là"<s>") — Token đánh dấu đầu câu. - eos_token (
str, tùy chọn, mặc định là"</s>") — Token kết thúc câu. - unk_token (
str, tùy chọn, mặc định là"<unk>") — Token không xác định. Một token không có trong từ vựng sẽ không thể được chuyển đổi thành ID và sẽ được gán thành token này thay thế. - pad_token (
str, tùy chọn, mặc định là"<pad>") — Token được sử dụng để đệm, chẳng hạn khi xử lý các lô (batch) gồm các chuỗi có độ dài khác nhau. - word_delimiter_token (
str, tùy chọn, mặc định là"|") — Token được sử dụng để xác định kết thúc của một từ. - do_lower_case (
bool, tùy chọn, mặc định làFalse) — Có chấp nhận đầu vào chữ thường và chuyển đầu ra thành chữ thường khi giải mã hay không. - target_lang (
str, tùy chọn) — Ngôn ngữ đích mà tokenizer nên đặt mặc định.target_langphải được định nghĩa cho từ điển lồng nhau đa ngôn ngữ như facebook/mms-1b-all. - **kwargs — Các đối số từ khóa bổ sung được truyền đến PreTrainedTokenizer
Tạo một tokenizer Wav2Vec2CTC.
Tokenizer này kế thừa từ PreTrainedTokenizer, bao gồm một số phương thức chính. Người dùng nên tham khảo lớp cha để biết thêm thông tin về các phương thức này.
__call__
< source >( text: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Noneadd_special_tokens: bool = Truepadding: bool | str | PaddingStrategy = Falsetruncation: bool | str | TruncationStrategy | None = Nonemax_length: int | None = Nonestride: int = 0is_split_into_words: bool = Falsepad_to_multiple_of: int | None = Nonepadding_side: str | None = Nonereturn_tensors: str | TensorType | None = Nonereturn_token_type_ids: bool | None = Nonereturn_attention_mask: bool | None = Nonereturn_overflowing_tokens: bool = Falsereturn_special_tokens_mask: bool = Falsereturn_offsets_mapping: bool = Falsereturn_length: bool = Falseverbose: bool = Truetokenizer_kwargs: dict[str, Any] | None = None**kwargs ) → BatchEncoding
Tham số
- text (
str,list[str],list[list[str]], tùy chọn) — Chuỗi hoặc lô các chuỗi cần được mã hóa. Mỗi chuỗi có thể là một chuỗi ký tự hoặc một danh sách các chuỗi ký tự (chuỗi đã được tiền mã hóa). Nếu các chuỗi được cung cấp dưới dạng danh sách các chuỗi ký tự (tiền mã hóa), bạn phải đặtis_split_into_words=True(để loại bỏ sự mơ hồ với một lô các chuỗi). - text_pair (
str,list[str],list[list[str]], tùy chọn) — Chuỗi hoặc lô các chuỗi cần được mã hóa. Mỗi chuỗi có thể là một chuỗi ký tự hoặc một danh sách các chuỗi ký tự (chuỗi đã được tách token trước). Nếu các chuỗi được cung cấp dưới dạng danh sách các chuỗi ký tự (đã tách token trước), bạn phải đặtis_split_into_words=True(để loại bỏ sự mơ hồ với một lô các chuỗi). - text_target (
str,list[str],list[list[str]], tùy chọn) — Chuỗi hoặc lô các chuỗi cần được mã hóa dưới dạng văn bản đích. Mỗi chuỗi có thể là một chuỗi ký tự hoặc một danh sách các chuỗi ký tự (chuỗi đã tách token). Nếu các chuỗi được cung cấp dưới dạng danh sách các chuỗi ký tự (đã tách token), bạn phải đặtis_split_into_words=True(để loại bỏ sự mơ hồ với một lô các chuỗi). - text_pair_target (
str,list[str],list[list[str]], tùy chọn) — Chuỗi hoặc lô các chuỗi cần được mã hóa dưới dạng văn bản đích. Mỗi chuỗi có thể là một chuỗi ký tự hoặc một danh sách các chuỗi ký tự (chuỗi đã tách token). Nếu các chuỗi được cung cấp dưới dạng danh sách các chuỗi ký tự (đã tách token), bạn phải đặtis_split_into_words=True(để loại bỏ sự mơ hồ với một lô các chuỗi). - tokenizer_kwargs (
dict[str, Any], tùy chọn) — Các kwargs bổ sung để truyền cho tokenizer. Chúng sẽ được gộp với các tham số tường minh và các kwargs khác, trong đó các tham số tường minh có độ ưu tiên cao hơn. - add_special_tokens (
bool, tùy chọn, mặc định làTrue) — Có thêm các token đặc biệt khi mã hóa các chuỗi hay không. Điều này sẽ sử dụng hàmPretrainedTokenizerBase.build_inputs_with_special_tokensbên dưới, hàm này xác định các token nào được thêm tự động vào các id đầu vào. Điều này hữu ích nếu bạn muốn thêm các tokenboshoặceosmột cách tự động. - padding (
bool,strhoặc PaddingStrategy, tùy chọn, mặc định làFalse) — Kích hoạt và kiểm soát padding. Chấp nhận các giá trị sau:Truehoặc'longest': Lấp đầy (pad) đến độ dài của chuỗi dài nhất trong batch (hoặc không lấp đầy nếu chỉ cung cấp một chuỗi duy nhất).'max_length': Đệm (pad) đến độ dài tối đa được chỉ định bằng tham sốmax_lengthhoặc đến độ dài đầu vào tối đa mà mô hình chấp nhận được nếu tham số đó không được cung cấp.Falsehoặc'do_not_pad'(mặc định): Không đệm (tức là có thể xuất ra một lô với các chuỗi có độ dài khác nhau).
- truncation (
bool,strhoặc TruncationStrategy, tùy chọn, mặc định làFalse) — Kích hoạt và kiểm soát việc cắt ngắn. Chấp nhận các giá trị sau:Truehoặc'longest_first': Cắt ngắn xuống độ dài tối đa được chỉ định bằng tham sốmax_lengthhoặc xuống độ dài đầu vào tối đa chấp nhận được của mô hình nếu tham số đó không được cung cấp. Thao tác này sẽ cắt ngắn theo từng token, loại bỏ một token từ chuỗi dài nhất trong cặp nếu một cặp chuỗi (hoặc một lô các cặp) được cung cấp.'only_first': Cắt ngắn xuống độ dài tối đa được chỉ định bằng tham sốmax_lengthhoặc xuống độ dài đầu vào tối đa mà mô hình chấp nhận được nếu tham số đó không được cung cấp. Thao tác này chỉ cắt ngắn chuỗi đầu tiên của một cặp nếu một cặp chuỗi (hoặc một lô các cặp) được cung cấp.'only_second': Cắt ngắn xuống độ dài tối đa được chỉ định bằng tham sốmax_lengthhoặc xuống độ dài đầu vào tối đa mà mô hình chấp nhận được nếu tham số đó không được cung cấp. Thao tác này chỉ cắt ngắn chuỗi thứ hai của một cặp nếu một cặp chuỗi (hoặc một lô các cặp) được cung cấp.Falsehoặc'do_not_truncate'(mặc định): Không cắt bớt (tức là có thể xuất ra batch với độ dài chuỗi lớn hơn kích thước đầu vào tối đa cho phép của mô hình).
- max_length (
int, tuỳ chọn) — Kiểm soát độ dài tối đa được sử dụng bởi một trong các tham số cắt/giữ chỗ (truncation/padding).Nếu không được đặt hoặc được đặt thành
None, tham số này sẽ sử dụng độ dài tối đa định trước của mô hình nếu một trong các tham số cắt/giữ chỗ yêu cầu độ dài tối đa. Nếu mô hình không có độ dài đầu vào tối đa cụ thể (như XLNet), việc cắt/giữ chỗ đến độ dài tối đa sẽ bị vô hiệu hóa. - stride (
int, tùy chọn, mặc định là 0) — Nếu được đặt thành một số cùng vớimax_length, các token tràn ra được trả về khireturn_overflowing_tokens=Truesẽ chứa một số token từ cuối của chuỗi bị cắt ngắn được trả về để tạo ra một phần chồng lấn giữa các chuỗi bị cắt ngắn và các chuỗi tràn ra. Giá trị của đối số này xác định số lượng token chồng lấn. - is_split_into_words (
bool, tùy chọn, mặc định làFalse) — Cho biết đầu vào đã được tiền xử lý token hay chưa (ví dụ: đã tách thành các từ). Nếu đặt thànhTrue, bộ phân tích token sẽ giả định rằng đầu vào đã được tách thành các từ (chẳng hạn, bằng cách tách theo khoảng trắng) và sẽ tiến hành phân tích token cho chúng. Điều này hữu ích cho NER hoặc phân loại token. - pad_to_multiple_of (
int, tùy chọn) — Nếu được đặt, chuỗi sẽ được đệm đến một bội số của giá trị được cung cấp. Yêu cầupaddingphải được kích hoạt. Điều này đặc biệt hữu ích để cho phép sử dụng Tensor Cores trên phần cứng NVIDIA có khả năng tính toán>= 7.5(Volta). - padding_side (
str, tùy chọn) — Bên mà mô hình cần được áp dụng padding. Nên chọn giữa [‘right’, ‘left’]. Giá trị mặc định được lấy từ thuộc tính lớp có cùng tên. - return_tensors (
strhoặc TensorType, tùy chọn) — Nếu được đặt, sẽ trả về tensor thay vì danh sách các số nguyên Python. Các giá trị chấp nhận được là:'pt': Trả về các đối tượngtorch.Tensorcủa PyTorch.'np': Trả về các đối tượng Numpynp.ndarray.
- return_token_type_ids (
bool, tuỳ chọn) — Có trả về token type IDs hay không. Nếu để mặc định, sẽ trả về token type IDs theo mặc định của tokenizer cụ thể, được xác định bởi thuộc tínhreturn_outputs. - return_attention_mask (
bool, tuỳ chọn) — Có trả về attention mask hay không. Nếu để mặc định, sẽ trả về attention mask theo mặc định của tokenizer cụ thể, được xác định bởi thuộc tínhreturn_outputs. - return_overflowing_tokens (
bool, tùy chọn, mặc định làFalse) — Có trả về các chuỗi token tràn hay không. Nếu một cặp chuỗi input ids (hoặc một batch các cặp) được cung cấp vớitruncation_strategy = longest_firsthoặcTrue, một lỗi sẽ được ném thay vì trả về các token tràn. - return_special_tokens_mask (
bool, tùy chọn, mặc định làFalse) — Có trả về thông tin mặt nạ (mask) cho các token đặc biệt hay không. - return_offsets_mapping (
bool, tuỳ chọn, mặc định làFalse) — Có trả về(char_start, char_end)cho từng token hay không.Tính năng này chỉ khả dụng trên các bộ phân từ nhanh kế thừa từ PreTrainedTokenizerFast; nếu sử dụng bộ phân từ của Python, phương thức này sẽ gây ra
NotImplementedError. - return_length (
bool, tùy chọn, mặc định làFalse) — Có trả về độ dài của các đầu vào đã mã hóa hay không. - verbose (
bool, tùy chọn, mặc định làTrue) — Có in thêm thông tin và cảnh báo hay không. - **kwargs — được truyền đến phương thức
self.tokenize()
Trả về
Một BatchEncoding với các trường sau:
-
input_ids — Danh sách các id token để đưa vào mô hình.
-
token_type_ids — Danh sách các id loại token để đưa vào mô hình (khi
return_token_type_ids=Truehoặc nếu “token_type_ids” nằm trongself.model_input_names). -
attention_mask — Danh sách các chỉ số chỉ định những token nào nên được mô hình chú ý đến (khi
return_attention_mask=Truehoặc nếu “attention_mask” nằm trongself.model_input_names). -
overflowing_tokens — Danh sách các chuỗi token bị tràn (khi
max_lengthđược chỉ định vàreturn_overflowing_tokens=True). -
num_truncated_tokens — Số lượng token bị cắt bỏ (khi có chỉ định
max_lengthvàreturn_overflowing_tokens=True). -
special_tokens_mask — Danh sách các số 0 và 1, trong đó 1 chỉ định các token đặc biệt được thêm vào và 0 chỉ định các token chuỗi thông thường (khi
add_special_tokens=Truevàreturn_special_tokens_mask=True). -
length — Độ dài của các đầu vào (khi
return_length=True)
Phương thức chính để mã hóa token và chuẩn bị cho mô hình một hoặc nhiều chuỗi, hoặc một hoặc nhiều cặp chuỗi.
decode
< source >( token_ids: typing.Union[int, list[int], numpy.ndarray, ForwardRef('torch.Tensor')]skip_special_tokens: bool = Falseclean_up_tokenization_spaces: bool | None = Noneoutput_char_offsets: bool = Falseoutput_word_offsets: bool = False**kwargs ) → str or Wav2Vec2CTCTokenizerOutput
Tham số
- token_ids (
Union[int, list[int], np.ndarray, torch.Tensor]) — Danh sách các id đầu vào đã được token hóa. Có thể lấy bằng cách sử dụng phương thức__call__. - skip_special_tokens (
bool, tùy chọn, mặc định làFalse) — Có loại bỏ các token đặc biệt trong quá trình giải mã hay không. - clean_up_tokenization_spaces (
bool, tùy chọn) — Có dọn dẹp khoảng trắng trong token hóa hay không. - output_char_offsets (
bool, tuỳ chọn, mặc định làFalse) — Có xuất offset ký tự hay không. Offset ký tự có thể được kết hợp với tần suất lấy mẫu và tần suất hạ mẫu của mô hình để tính toán mốc thời gian của các ký tự được chuyển tự.Hãy xem ví dụ bên dưới để hiểu rõ hơn cách sử dụng
output_char_offsets. - output_word_offsets (
bool, tuỳ chọn, mặc định làFalse) — Có xuất offset của từ hay không. Offset của từ có thể được kết hợp với tần số lấy mẫu và tần số hạ mẫu của mô hình để tính toán mốc thời gian của các từ được chuyển tự.Hãy xem ví dụ bên dưới để hiểu rõ hơn cách sử dụng
output_word_offsets. - kwargs (các tham số từ khóa bổ sung, tùy chọn) — Sẽ được truyền đến phương thức decode cụ thể của model bên dưới.
Trả về
str hoặc Wav2Vec2CTCTokenizerOutput
Danh sách các câu đã giải mã. Sẽ là Wav2Vec2CTCTokenizerOutput khi
output_char_offsets == True hoặc output_word_offsets == True.
Chuyển đổi một chuỗi các id trong một chuỗi ký tự, sử dụng tokenizer và từ vựng với các tùy chọn để loại bỏ các token đặc biệt và dọn dẹp khoảng trắng trong token hóa.
Tương tự như việc thực hiện self.convert_tokens_to_string(self.convert_ids_to_tokens(token_ids)).
Ví dụ:
>>> # Let's see how to retrieve time steps for a model
>>> from transformers import AutoTokenizer, AutoFeatureExtractor, AutoModelForCTC
>>> from datasets import load_dataset
>>> import datasets
>>> import torch

>>> # import model, feature extractor, tokenizer
>>> model = AutoModelForCTC.from_pretrained("facebook/wav2vec2-base-960h")
>>> tokenizer = AutoTokenizer.from_pretrained("facebook/wav2vec2-base-960h")
>>> feature_extractor = AutoFeatureExtractor.from_pretrained("facebook/wav2vec2-base-960h")

>>> # load first sample of English common_voice
>>> dataset = load_dataset("mozilla-foundation/common_voice_11_0", "en", split="train", streaming=True)
>>> dataset = dataset.cast_column("audio", datasets.Audio(sampling_rate=16_000))
>>> dataset_iter = iter(dataset)
>>> sample = next(dataset_iter)

>>> # forward sample through model to get greedily predicted transcription ids
>>> input_values = feature_extractor(sample["audio"]["array"], return_tensors="pt").input_values
>>> logits = model(input_values).logits[0]
>>> pred_ids = torch.argmax(logits, axis=-1)

>>> # retrieve word stamps (analogous commands for `output_char_offsets`)
>>> outputs = tokenizer.decode(pred_ids, output_word_offsets=True)
>>> # compute `time_offset` in seconds as product of downsampling ratio and sampling_rate
>>> time_offset = model.config.inputs_to_logits_ratio / feature_extractor.sampling_rate

>>> word_offsets = [
...     {
...         "word": d["word"],
...         "start_time": round(d["start_offset"] * time_offset, 2),
...         "end_time": round(d["end_offset"] * time_offset, 2),
...     }
...     for d in outputs.word_offsets
... ]
>>> # compare word offsets with audio `en_train_0/common_voice_en_19121553.mp3` online on the dataset viewer:
>>> # https://huggingface.co/datasets/mozilla-foundation/common_voice_11_0/viewer/en
>>> word_offsets[:3]
[{'word': 'THE', 'start_time': 0.7, 'end_time': 0.78}, {'word': 'TRICK', 'start_time': 0.88, 'end_time': 1.08}, {'word': 'APPEARS', 'start_time': 1.2, 'end_time': 1.64}]
batch_decode
< source >( sequences: typing.Union[list[int], list[list[int]], numpy.ndarray, ForwardRef('torch.Tensor')]skip_special_tokens: bool = Falseclean_up_tokenization_spaces: bool | None = Noneoutput_char_offsets: bool = Falseoutput_word_offsets: bool = False**kwargs ) → list[str] or Wav2Vec2CTCTokenizerOutput
Tham số
- sequences (
Union[list[int], list[list[int]], np.ndarray, torch.Tensor]) — Danh sách các id đầu vào đã được token hóa. Có thể lấy được bằng cách sử dụng phương thức__call__. - skip_special_tokens (
bool, tùy chọn, mặc định làFalse) — Có loại bỏ các token đặc biệt trong quá trình giải mã hay không. - clean_up_tokenization_spaces (
bool, tùy chọn) — Có dọn dẹp khoảng trắng trong token hóa hay không. - output_char_offsets (
bool, tuỳ chọn, mặc định làFalse) — Có xuất offset ký tự hay không. Offset ký tự có thể được sử dụng kết hợp với tần suất lấy mẫu và tần suất giảm mẫu của mô hình để tính toán mốc thời gian của các ký tự được chuyển tự.Hãy xem decode() để hiểu rõ hơn cách sử dụng
output_char_offsets. batch_decode() hoạt động tương tự với đầu ra dạng batch. - output_word_offsets (
bool, tuỳ chọn, mặc định làFalse) — Có xuất offset của từ hay không. Offset của từ có thể được kết hợp với tần suất lấy mẫu và tần suất hạ mẫu của mô hình để tính toán mốc thời gian của các từ được chuyển tự.Hãy xem decode() để hiểu rõ hơn cách sử dụng
output_word_offsets. batch_decode() hoạt động tương tự với đầu ra dạng batch. - kwargs (các tham số từ khóa bổ sung, tùy chọn) — Sẽ được truyền đến phương thức decode cụ thể của model bên dưới.
Trả về
list[str] hoặc Wav2Vec2CTCTokenizerOutput
Danh sách các câu đã giải mã. Sẽ là Wav2Vec2CTCTokenizerOutput khi
output_char_offsets == True hoặc output_word_offsets == True.
Chuyển đổi một danh sách các danh sách id token thành một danh sách các chuỗi bằng cách gọi decode.
Đặt ngôn ngữ đích của một từ điển đa ngôn ngữ lồng nhau
Wav2Vec2FeatureExtractor
lớp transformers.Wav2Vec2FeatureExtractor
< source >( feature_size = 1sampling_rate = 16000padding_value = 0.0return_attention_mask = Falsedo_normalize = True**kwargs )
Tham số
- feature_size (
int, tùy chọn, mặc định là 1) — Kích thước chiều của các đặc trưng đã trích xuất. - sampling_rate (
int, tùy chọn, mặc định là 16000) — Tần số lấy mẫu (tính bằng hertz (Hz)) mà các tệp âm thanh cần được số hóa. - padding_value (
float, tùy chọn, mặc định là 0.0) — Giá trị được sử dụng để điền vào các giá trị đệm. - do_normalize (
bool, tùy chọn, mặc định làTrue) — Có nên chuẩn hóa đầu vào theo phương pháp trung bình bằng không và phương sai đơn vị hay không. Việc chuẩn hóa có thể giúp cải thiện đáng kể hiệu suất cho một số mô hình, ví dụ, wav2vec2-lv60. - return_attention_mask (
bool, tuỳ chọn, mặc định làFalse) — Có nên gọi() hay không nên trả vềattention_mask.Các mô hình Wav2Vec2 có đặt
config.feat_extract_norm == "group", chẳng hạn như wav2vec2-base, không được huấn luyện bằngattention_mask. Đối với các mô hình như vậy,input_valueschỉ cần được đệm bằng 0 và không nên truyềnattention_mask.Đối với các mô hình Wav2Vec2 có đặt
config.feat_extract_norm == "layer", chẳng hạn như wav2vec2-lv60,attention_masknên được truyền vào cho suy luận theo lô (batched inference).
Tạo bộ trích xuất đặc trưng Wav2Vec2.
Feature extractor này kế thừa từ SequenceFeatureExtractor, bao gồm hầu hết các phương thức chính. Người dùng nên tham khảo lớp cha này để biết thêm thông tin về các phương thức đó.
__call__
< source >( raw_speech: numpy.ndarray | list[float] | list[numpy.ndarray] | list[list[float]]padding: bool | str | transformers.utils.generic.PaddingStrategy = Falsemax_length: int | None = Nonetruncation: bool = Falsepad_to_multiple_of: int | None = Nonereturn_attention_mask: bool | None = Nonereturn_tensors: str | transformers.utils.generic.TensorType | None = Nonesampling_rate: int | None = None**kwargs )
Tham số
- raw_speech (
np.ndarray,list[float],list[np.ndarray],list[list[float]]) — Chuỗi hoặc lô các chuỗi cần được đệm. Mỗi chuỗi có thể là một mảng numpy, một danh sách các giá trị float, một danh sách các mảng numpy hoặc một danh sách các danh sách giá trị float. Phải là âm thanh kênh đơn (mono), không phải stereo, tức là một giá trị float duy nhất cho mỗi bước thời gian. - padding (
bool,strhoặc PaddingStrategy, tùy chọn, mặc định làFalse) — Chọn một chiến lược để đệm các chuỗi trả về (theo phía đệm và chỉ số đệm của mô hình) trong số các lựa chọn sau:Truehoặc'longest': Lấp đầy đến trình tự dài nhất trong lô (hoặc không lấp đầy nếu chỉ có một trình tự được cung cấp).'max_length': Đệm (pad) đến độ dài tối đa được chỉ định bằng tham sốmax_lengthhoặc đến độ dài đầu vào tối đa mà mô hình chấp nhận được nếu tham số đó không được cung cấp.Falsehoặc'do_not_pad'(mặc định): Không đệm (tức là có thể xuất ra một lô với các chuỗi có độ dài khác nhau).
- max_length (
int, tùy chọn) — Độ dài tối đa của danh sách trả về và tùy chọn độ dài padding (xem bên trên). - truncation (
bool) — Bật tính năng cắt để giảm các chuỗi đầu vào dài hơn max_length xuống còn max_length. - pad_to_multiple_of (
int, tuỳ chọn) — Nếu được đặt, chuỗi sẽ được đệm (pad) đến bội số của giá trị được cung cấp.Điều này đặc biệt hữu ích để cho phép sử dụng Tensor Cores trên phần cứng NVIDIA có khả năng tính toán
>= 7.5(Volta), hoặc trên TPU, nơi mà việc có độ dài chuỗi là bội số của 128 sẽ mang lại lợi ích. - return_attention_mask (
bool, tuỳ chọn) — Có trả về attention mask hay không. Nếu để mặc định, sẽ trả về attention mask theo mặc định của feature_extractor cụ thể.Các mô hình Wav2Vec2 có đặt
config.feat_extract_norm == "group", chẳng hạn như wav2vec2-base, không được huấn luyện bằngattention_mask. Đối với các mô hình như vậy,input_valueschỉ cần được đệm bằng 0 và không nên truyềnattention_mask.Đối với các mô hình Wav2Vec2 có đặt
config.feat_extract_norm == "layer", chẳng hạn như wav2vec2-lv60,attention_masknên được truyền vào cho suy luận theo lô (batched inference). - return_tensors (
strhoặc TensorType, tùy chọn) — Nếu được đặt, sẽ trả về tensor thay vì danh sách các số nguyên Python. Các giá trị chấp nhận được là:'pt': Trả về các đối tượngtorch.Tensorcủa PyTorch.'np': Trả về các đối tượng Numpynp.ndarray.
- sampling_rate (
int, tùy chọn) — Tần số lấy mẫu mà đầu vàoraw_speechđược lấy mẫu. Rất khuyến nghị truyềnsampling_ratetrong lời gọi forward để ngăn các lỗi âm thầm. - padding_value (
float, tùy chọn, mặc định là 0.0) —
Phương thức chính để tạo đặc trưng và chuẩn bị một hoặc nhiều chuỗi cho mô hình.
Wav2Vec2Processor
lớp transformers.Wav2Vec2Processor
< source >( feature_extractortokenizer )
Tạo một Wav2Vec2Processor đóng gói một bộ trích xuất đặc trưng và một bộ phân từ thành một bộ xử lý duy nhất.
Wav2Vec2Processor cung cấp đầy đủ các chức năng của Wav2Vec2FeatureExtractor và Wav2Vec2CTCTokenizer. Xem ~Wav2Vec2FeatureExtractor và ~Wav2Vec2CTCTokenizer để biết thêm thông tin.
__call__
< source >( audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], NoneType] = Nonetext: str | list[str] | None = None**kwargs: *<class 'transformers.models.wav2vec2.processing_wav2vec2.Wav2Vec2ProcessorKwargs'> )
Tham số
- audio (
Union[numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor]], optional) — Âm thanh hoặc lô âm thanh cần được chuẩn bị. Mỗi âm thanh có thể là một mảng NumPy hoặc tensor PyTorch. Trong trường hợp là mảng NumPy/tensor PyTorch, mỗi âm thanh nên có hình dạng (C, T), trong đó C là số kênh và T là độ dài mẫu của âm thanh. - text (
Union[str, list[str]], tùy chọn) — Chuỗi hoặc lô các chuỗi cần được mã hóa. Mỗi chuỗi có thể là một chuỗi ký tự hoặc một danh sách các chuỗi ký tự (chuỗi đã được tách token trước). Nếu bạn truyền vào dữ liệu đầu vào đã được tách token trước, hãy đặtis_split_into_words=Trueđể tránh nhầm lẫn với các đầu vào dạng lô. - return_tensors (
strhoặc TensorType, tùy chọn) — Nếu được đặt, sẽ trả về tensor của một framework cụ thể. Các giá trị chấp nhận được là:'pt': Trả về các đối tượngtorch.Tensorcủa PyTorch.'np': Trả về các đối tượngnp.ndarraycủa NumPy.
- **kwargs (ProcessingKwargs, optional) — Các tùy chọn xử lý bổ sung cho từng modality (text, images, videos, audio). Các tham số cụ thể của model được liệt kê ở trên; xem lớp TypedDict để biết danh sách đầy đủ các đối số được hỗ trợ.
pad
< source >( *args**kwargs )
Tham số
- input_features —
Khi đối số đầu tiên là một từ điển chứa một lô tensor, hoặc khi có đối số
input_features, nó sẽ được truyền đến Wav2Vec2FeatureExtractor.pad(). - labels —
Khi có đối số
label, nó sẽ được truyền vào PreTrainedTokenizer.pad().
Phương pháp này hoạt động trên các lô (batch) các đặc trưng đã trích xuất và/hoặc văn bản đã token hóa. Nó chuyển tiếp tất cả các đối số đến Wav2Vec2FeatureExtractor.pad() và/hoặc PreTrainedTokenizer.pad() tùy thuộc vào loại dữ liệu đầu vào (modality) và trả về kết quả của chúng. Nếu cả hai loại dữ liệu đều được truyền vào, Wav2Vec2FeatureExtractor.pad() và PreTrainedTokenizer.pad() sẽ được gọi.
from_pretrained
< source >( pretrained_model_name_or_path: str | os.PathLikecache_dir: str | os.PathLike | None = Noneforce_download: bool = Falselocal_files_only: bool = Falsetoken: str | bool | None = Nonerevision: str = 'main'**kwargs )
Tham số
- pretrained_model_name_or_path (
strhoặcos.PathLike) — Đây có thể là:- một chuỗi, model id của một feature_extractor được huấn luyện trước lưu trữ trong một kho model trên huggingface.co.
- đường dẫn đến một thư mục chứa tệp feature extractor được lưu bằng phương thức
save_pretrained(), ví dụ:
./my_model_directory/. - đường dẫn đến tệp JSON bộ trích xuất đặc trưng đã lưu tệp, ví dụ:
./my_model_directory/preprocessor_config.json.
- **kwargs —
Các đối số từ khóa bổ sung được truyền đến cả
from_pretrained() và
~tokenization_utils_base.PreTrainedTokenizer.from_pretrained.
Tạo một processor liên kết với một model được huấn luyện trước.
Phương thức lớp này đơn giản là gọi phương thức from_pretrained() của bộ trích xuất đặc trưng, ImageProcessingMixin của bộ xử lý ảnh và
~tokenization_utils_base.PreTrainedTokenizer.from_pretrainedcủa bộ phân từ. Vui lòng tham khảo các docstring của các phương thức ở trên để biết thêm thông tin.
save_pretrained
< source >( save_directorypush_to_hub: bool = False**kwargs )
Tham số
- save_directory (
strhoặcos.PathLike) — Thư mục nơi tệp JSON của bộ trích xuất đặc trưng và các tệp tokenizer sẽ được lưu (thư mục sẽ được tạo nếu chưa tồn tại). - push_to_hub (
bool, tùy chọn, mặc định làFalse) — Có đẩy mô hình của bạn lên Hugging Face model hub sau khi lưu hay không. Bạn có thể chỉ định kho lưu trữ muốn đẩy đến bằngrepo_id(mặc định sẽ là tên củasave_directorytrong namespace của bạn). - kwargs (
dict[str, Any], tùy chọn) — Các đối số từ khóa bổ sung được truyền đến phương thức push_to_hub().
Lưu các thuộc tính của bộ xử lý này (bộ trích xuất đặc trưng, bộ phân từ…) vào thư mục được chỉ định để có thể tải lại bằng phương thức from_pretrained().
Phương thức lớp này đơn giản chỉ gọi save_pretrained() và save_pretrained(). Vui lòng tham khảo docstring của các phương thức ở trên để biết thêm thông tin.
Phương pháp này chuyển tiếp tất cả các đối số của nó đến batch_decode() của PreTrainedTokenizer. Vui lòng tham khảo docstring của phương pháp này để biết thêm thông tin.
Phương pháp này chuyển tiếp tất cả các đối số của nó đến decode() của PreTrainedTokenizer. Vui lòng tham khảo docstring của phương pháp này để biết thêm thông tin.
Wav2Vec2ProcessorWithLM
lớp transformers.Wav2Vec2ProcessorWithLM
< source >( feature_extractor: FeatureExtractionMixintokenizer: PreTrainedTokenizerBasedecoder: BeamSearchDecoderCTC )
Tạo một Wav2Vec2ProcessorWithLM, đóng gói một bộ trích xuất đặc trưng và một bộ phân từ thành một bộ xử lý duy nhất.
Wav2Vec2ProcessorWithLM cung cấp đầy đủ các chức năng của feature_extractor_class và tokenizer_class. Xem ~feature_extractor_class và ~tokenizer_class để biết thêm thông tin.
__call__
< source >( *args**kwargs )
Tham số
- return_tensors (
strhoặc TensorType, tùy chọn) — Nếu được đặt, sẽ trả về tensor của một framework cụ thể. Các giá trị chấp nhận được là:'pt': Trả về các đối tượngtorch.Tensorcủa PyTorch.'np': Trả về các đối tượngnp.ndarraycủa NumPy.
Khi được sử dụng ở chế độ bình thường, phương thức này chuyển tiếp tất cả các đối số của nó đến ~FeatureExtractionMixin.pad của bộ trích xuất đặc trưng và trả về kết quả đầu ra của nó. Nếu được sử dụng trong ngữ cảnh ~Wav2Vec2ProcessorWithLM.as_target_processor, phương thức này chuyển tiếp tất cả các đối số của nó đến pad() của Wav2Vec2CTCTokenizer. Vui lòng tham khảo docstring của hai phương thức nêu trên để biết thêm thông tin.
from_pretrained
< source >( pretrained_model_name_or_path**kwargs )
Tham số
- pretrained_model_name_or_path (
strhoặcos.PathLike) — Đây có thể là:- một chuỗi, model id của một feature_extractor được huấn luyện trước lưu trữ trong một kho model trên huggingface.co.
- đường dẫn đến một thư mục chứa tệp feature extractor được lưu bằng phương thức
save_pretrained(), ví dụ:
./my_model_directory/. - đường dẫn đến tệp JSON bộ trích xuất đặc trưng đã lưu tệp, ví dụ:
./my_model_directory/preprocessor_config.json.
- **kwargs — Các đối số từ khóa bổ sung được truyền đến cả SequenceFeatureExtractor và PreTrainedTokenizer
Tạo một Wav2Vec2ProcessorWithLM từ một bộ xử lý Wav2Vec2 được huấn luyện trước.
Phương thức lớp này đơn giản là gọi from_pretrained() của feature extractor, from_pretrained() của Wav2Vec2CTCTokenizer và
pyctcdecode.BeamSearchDecoderCTC.load_from_hf_hub.Vui lòng tham khảo các docstring của các phương thức ở trên để biết thêm thông tin.
batch_decode
< source >( logits: ndarraypool: multiprocessing.pool.Pool | None = Nonenum_processes: int | None = Nonebeam_width: int | None = Nonebeam_prune_logp: float | None = Nonetoken_min_logp: float | None = Nonehotwords: collections.abc.Iterable[str] | None = Nonehotword_weight: float | None = Nonealpha: float | None = Nonebeta: float | None = Noneunk_score_offset: float | None = Nonelm_score_boundary: bool | None = Noneoutput_word_offsets: bool = Falsen_best: int = 1 )
Tham số
- logits (
np.ndarray) — Vector logits đầu ra của mô hình, biểu diễn log xác suất cho từng token. - pool (
multiprocessing.Pool, tuỳ chọn) — Một pool do người dùng quản lý, tuỳ chọn. Nếu không được đặt, một pool sẽ được tạo và đóng tự động. Pool nên được khởi tạo sauWav2Vec2ProcessorWithLM. Nếu không, LM sẽ không khả dụng cho các tiến trình con của pool.Hiện tại, chỉ có các pool được tạo với ngữ cảnh ‘fork’ mới có thể được sử dụng. Nếu một pool ‘spawn’ được truyền vào, nó sẽ bị bỏ qua và thay vào đó sẽ sử dụng giải mã tuần tự.
- num_processes (
int, tùy chọn) — Nếupoolkhông được đặt, số lượng tiến trình mà hàm cần được song song hóa. Mặc định là số lượng CPU khả dụng. - beam_width (
int, tùy chọn) — Số lượng beam tối đa ở mỗi bước trong quá trình giải mã. Mặc định là DEFAULT_BEAM_WIDTH của pyctcdecode. - beam_prune_logp (
int, tùy chọn) — Các beam kém hơn nhiều so với beam tốt nhất sẽ bị loại bỏ. Mặc định là DEFAULT_PRUNE_LOGP của pyctcdecode. - token_min_logp (
int, tuỳ chọn) — Các token có logp thấp hơn ngưỡng này sẽ bị bỏ qua trừ khi chúng là argmax của frame. Mặc định là DEFAULT_MIN_TOKEN_LOGP của pyctcdecode. - hotwords (
list[str], tùy chọn) — Danh sách các từ có tầm quan trọng đặc biệt, có thể là OOV đối với LM - hotword_weight (
int, tùy chọn) — Hệ số trọng số cho mức độ quan trọng của từ khóa. Mặc định là DEFAULT_HOTWORD_WEIGHT của pyctcdecode. - alpha (
float, tùy chọn) — Trọng số cho mô hình ngôn ngữ trong quá trình dung hợp nông - beta (
float, tùy chọn) — Trọng số cho việc điều chỉnh điểm độ dài trong quá trình chấm điểm - unk_score_offset (
float, tùy chọn) — Lượng dịch chuyển điểm log cho các token không xác định - lm_score_boundary (
bool, tùy chọn) — Xác định xem kenlm có tôn trọng các ranh giới khi chấm điểm hay không - output_word_offsets (
bool, tùy chọn, mặc định làFalse) — Có xuất các vị trí từ hay không. Các vị trí từ có thể được sử dụng kết hợp với tốc độ lấy mẫu và tốc độ giảm mẫu của mô hình để tính toán mốc thời gian của các từ được chuyển tự. - n_best (
int, tuỳ chọn, mặc định là1) — Số lượng giả thuyết tốt nhất cần trả về. Nếun_bestlớn hơn 1, giá trị trả về củatextsẽ là một danh sách các danh sách chuỗi,logit_scoresẽ là một danh sách các danh sách số float, vàlm_scoresẽ là một danh sách các danh sách số float, trong đó độ dài của danh sách ngoài tương ứng với kích thước batch và độ dài của danh sách trong tương ứng với số lượng giả thuyết được trả về. Giá trị này phải >= 1.Hãy xem decode() để hiểu rõ hơn cách sử dụng
output_word_offsets. batch_decode() hoạt động tương tự với đầu ra dạng batch.
Giải mã hàng loạt đầu ra logits thành bản ghi âm thanh với hỗ trợ mô hình ngôn ngữ.
Hàm này sử dụng multiprocessing của Python. Hiện tại, multiprocessing chỉ khả dụng trên các hệ thống Unix (xem vấn đề này).
Nếu bạn đang giải mã nhiều lô, hãy cân nhắc tạo một
Poolvà truyền nó vàobatch_decode. Nếu không,batch_decodesẽ rất chậm vì nó sẽ tạo mộtPoolmới cho mỗi lần gọi. Xem ví dụ sử dụng bên dưới.
Ví dụ: Xem Giải mã nhiều tệp âm thanh.
decode
< source >( logits: ndarraybeam_width: int | None = Nonebeam_prune_logp: float | None = Nonetoken_min_logp: float | None = Nonehotwords: collections.abc.Iterable[str] | None = Nonehotword_weight: float | None = Nonealpha: float | None = Nonebeta: float | None = Noneunk_score_offset: float | None = Nonelm_score_boundary: bool | None = Noneoutput_word_offsets: bool = Falsen_best: int = 1 )
Tham số
- logits (
np.ndarray) — Vector logits đầu ra của mô hình, biểu diễn log xác suất cho từng token. - beam_width (
int, tùy chọn) — Số lượng beam tối đa ở mỗi bước trong quá trình giải mã. Mặc định là DEFAULT_BEAM_WIDTH của pyctcdecode. - beam_prune_logp (
int, tuỳ chọn) — Ngưỡng để loại bỏ các beam có log-probs nhỏ hơn best_beam_logp + beam_prune_logp. Giá trị nên là <= 0. Mặc định là DEFAULT_PRUNE_LOGP của pyctcdecode. - token_min_logp (
int, tuỳ chọn) — Các token có log-prob thấp hơn token_min_logp sẽ bị bỏ qua trừ khi chúng có log-prob lớn nhất cho một câu nói. Mặc định là DEFAULT_MIN_TOKEN_LOGP của pyctcdecode. - hotwords (
list[str], tùy chọn) — Danh sách các từ có tầm quan trọng đặc biệt, có thể không có trong từ vựng của LM, ví dụ: [“huggingface”] - hotword_weight (
int, tùy chọn) — Hệ số nhân trọng số để tăng điểm của từ khóa nóng. Mặc định là DEFAULT_HOTWORD_WEIGHT của pyctcdecode. - alpha (
float, tùy chọn) — Trọng số cho mô hình ngôn ngữ trong quá trình dung hợp nông - beta (
float, tùy chọn) — Trọng số cho việc điều chỉnh điểm độ dài trong quá trình chấm điểm - unk_score_offset (
float, tùy chọn) — Lượng dịch chuyển điểm log cho các token không xác định - lm_score_boundary (
bool, tùy chọn) — Xác định xem kenlm có tôn trọng các ranh giới khi chấm điểm hay không - output_word_offsets (
bool, tùy chọn, mặc định làFalse) — Có xuất các vị trí từ hay không. Các vị trí từ có thể được sử dụng kết hợp với tốc độ lấy mẫu và tốc độ giảm mẫu của mô hình để tính toán mốc thời gian của các từ được chuyển tự. - n_best (
int, tuỳ chọn, mặc định là1) — Số lượng giả thuyết tốt nhất cần trả về. Nếun_bestlớn hơn 1, giá trị trả về củatextsẽ là một danh sách các chuỗi,logit_scoresẽ là một danh sách các số float, vàlm_scoresẽ là một danh sách các số float, trong đó độ dài của các danh sách này sẽ tương ứng với số lượng giả thuyết được trả về. Giá trị này phải >= 1.Hãy xem ví dụ bên dưới để hiểu rõ hơn cách sử dụng
output_word_offsets.
Giải mã logits đầu ra thành bản ghi âm thanh với hỗ trợ mô hình ngôn ngữ.
Ví dụ:
>>> # Let's see how to retrieve time steps for a model
>>> from transformers import AutoTokenizer, AutoProcessor, AutoModelForCTC
>>> from datasets import load_dataset
>>> import datasets
>>> import torch

>>> # import model, feature extractor, tokenizer
>>> model = AutoModelForCTC.from_pretrained("patrickvonplaten/wav2vec2-base-100h-with-lm")
>>> processor = AutoProcessor.from_pretrained("patrickvonplaten/wav2vec2-base-100h-with-lm")

>>> # load first sample of English common_voice
>>> dataset = load_dataset("mozilla-foundation/common_voice_11_0", "en", split="train", streaming=True)
>>> dataset = dataset.cast_column("audio", datasets.Audio(sampling_rate=16_000))
>>> dataset_iter = iter(dataset)
>>> sample = next(dataset_iter)

>>> # forward sample through model to get greedily predicted transcription ids
>>> input_values = processor(sample["audio"]["array"], return_tensors="pt").input_values
>>> with torch.no_grad():
...     logits = model(input_values).logits[0].cpu().numpy()

>>> # retrieve word stamps (analogous commands for `output_char_offsets`)
>>> outputs = processor.decode(logits, output_word_offsets=True)
>>> # compute `time_offset` in seconds as product of downsampling ratio and sampling_rate
>>> time_offset = model.config.inputs_to_logits_ratio / processor.feature_extractor.sampling_rate

>>> word_offsets = [
...     {
...         "word": d["word"],
...         "start_time": round(d["start_offset"] * time_offset, 2),
...         "end_time": round(d["end_offset"] * time_offset, 2),
...     }
...     for d in outputs.word_offsets
... ]
>>> # compare word offsets with audio `en_train_0/common_voice_en_19121553.mp3` online on the dataset viewer:
>>> # https://huggingface.co/datasets/mozilla-foundation/common_voice_11_0/viewer/en
>>> word_offsets[:4]
[{'word': 'THE', 'start_time': 0.68, 'end_time': 0.78}, {'word': 'TRACK', 'start_time': 0.88, 'end_time': 1.1}, {'word': 'APPEARS', 'start_time': 1.18, 'end_time': 1.66}, {'word': 'ON', 'start_time': 1.86, 'end_time': 1.92}]
Giải mã nhiều tệp âm thanh
Nếu bạn dự định giải mã nhiều lô âm thanh, bạn nên cân nhắc sử dụng batch_decode() và truyền vào một multiprocessing.Pool đã được khởi tạo.
Ngược lại, hiệu suất của batch_decode() sẽ chậm hơn so với việc gọi decode() cho từng âm thanh riêng lẻ, vì nó khởi tạo một Pool mới bên trong cho mỗi lần gọi. Xem ví dụ bên dưới:
# Let's see how to use a user-managed pool for batch decoding multiple audios
from multiprocessing import get_context

import datasets
import torch
from datasets import load_dataset

from transformers import AutoModelForCTC, AutoProcessor


# import model, feature extractor, tokenizer
model = AutoModelForCTC.from_pretrained("patrickvonplaten/wav2vec2-base-100h-with-lm", device_map="auto")
processor = AutoProcessor.from_pretrained("patrickvonplaten/wav2vec2-base-100h-with-lm")

# load example dataset
dataset = load_dataset("hf-internal-testing/librispeech_asr_dummy", "clean", split="validation")
dataset = dataset.cast_column("audio", datasets.Audio(sampling_rate=16_000))


def map_to_array(example):
    example["speech"] = example["audio"]["array"]
    return example


# prepare speech data for batch inference
dataset = dataset.map(map_to_array, remove_columns=["audio"])


def map_to_pred(batch, pool):
    inputs = processor(batch["speech"], sampling_rate=16_000, padding=True, return_tensors="pt").to(model.device)
    inputs = {k: v.to(model.device) for k, v in inputs.items()}

    with torch.no_grad():
        logits = model(**inputs).logits

    transcription = processor.batch_decode(logits.cpu().numpy(), pool).text
    batch["transcription"] = transcription
    return batch


# note: pool should be instantiated *after* `Wav2Vec2ProcessorWithLM`.
#       otherwise, the LM won't be available to the pool's sub-processes
# select number of processes and batch_size based on number of CPU cores available and on dataset size
with get_context("fork").Pool(processes=2) as pool:
    result = dataset.map(
        map_to_pred, batched=True, batch_size=2, fn_kwargs={"pool": pool}, remove_columns=["speech"]
    )

result["transcription"][:2]
['MISTER QUILTER IS THE APOSTLE OF THE MIDDLE CLASSES AND WE ARE GLAD TO WELCOME HIS GOSPEL', "NOR IS MISTER COULTER'S MANNER LESS INTERESTING THAN HIS MATTER"]
Đầu ra cụ thể của Wav2Vec2
lớp transformers.models.wav2vec2_with_lm.processing_wav2vec2_with_lm.Wav2Vec2DecoderWithLMOutput
< source >( text: list[list[str]] | list[str] | strlogit_score: list[list[float]] | list[float] | float = Nonelm_score: list[list[float]] | list[float] | float = Noneword_offsets: list[list[list[dict[str, int | str]]]] | list[list[dict[str, int | str]]] | list[dict[str, int | str]] = None )
Tham số
- text (list of
strorstr) — Logits đã giải mã trong văn bản. Thường là bản ghi âm thanh. - logit_score (list of
floatorfloat) — Tổng điểm logit của các beam liên quan đến văn bản được tạo ra. - lm_score (list of
float) — Fused lm_score của các beam liên quan đến văn bản được tạo ra. - word_offsets (list of
list[dict[str, Union[int, str]]]orlist[dict[str, Union[int, str]]]) — Các offset của các từ đã giải mã. Khi kết hợp với tần số lấy mẫu và tỷ lệ hạ mẫu của mô hình, các offset từ có thể được sử dụng để tính toán mốc thời gian cho từng từ.
Loại đầu ra của Wav2Vec2DecoderWithLM, kèm theo bản chuyển tự.
lớp transformers.modeling_outputs.Wav2Vec2BaseModelOutput
< source >( last_hidden_state: typing.Optional[torch.Tensor] = Noneextract_features: typing.Optional[torch.Tensor] = Nonehidden_states: tuple[torch.Tensor, ...] | None = Noneattentions: tuple[torch.Tensor, ...] | None = None )
Tham số
- last_hidden_state (
torch.Tensorcó hình dạng(batch_size, sequence_length, hidden_size)) — Chuỗi các trạng thái ẩn (hidden-states) tại đầu ra của lớp cuối cùng của mô hình. - extract_features (
torch.Tensorcó hình dạng(batch_size, sequence_length, conv_dim[-1])) — Chuỗi các vector đặc trưng đã trích xuất từ lớp tích chập cuối cùng của mô hình. - hidden_states (
tuple(torch.Tensor), tuỳ chọn, được trả về khioutput_hidden_states=Trueđược truyền vào hoặc khiconfig.output_hidden_states=True) — Tuple củatorch.Tensor(một cho đầu ra của embeddings + một cho đầu ra của mỗi lớp) có hình dạng(batch_size, sequence_length, hidden_size).Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với đầu ra của lớp nhúng ban đầu.
- attentions (
tuple(torch.Tensor), tuỳ chọn, được trả về khioutput_attentions=Trueđược truyền vào hoặc khiconfig.output_attentions=True) — Tuple củatorch.Tensor(một cho mỗi lớp) có dạng(batch_size, num_heads, sequence_length, sequence_length).Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Lớp cơ sở cho các mô hình đã được huấn luyện với mục tiêu tổn thất Wav2Vec2.
lớp transformers.models.wav2vec2.modeling_wav2vec2.Wav2Vec2ForPreTrainingOutput
< source >( loss: typing.Optional[torch.Tensor] = Noneprojected_states: typing.Optional[torch.Tensor] = Noneprojected_quantized_states: typing.Optional[torch.Tensor] = Nonecodevector_perplexity: typing.Optional[torch.Tensor] = Nonehidden_states: tuple[torch.Tensor] | None = Noneattentions: tuple[torch.Tensor] | None = Nonecontrastive_loss: typing.Optional[torch.Tensor] = Nonediversity_loss: typing.Optional[torch.Tensor] = None )
Tham số
- loss (
*optional*, returned whensample_negative_indicesare passed,torch.Tensorof shape(1,)) — Total loss as the sum of the contrastive loss (L_m) and the diversity loss (L_d) as stated in the official paper. - projected_states (
torch.Tensorcó hình dạng(batch_size, sequence_length, config.proj_codevector_dim)) — Trạng thái ẩn (hidden-states) của mô hình được chiếu (projected) lên config.proj_codevector_dim, có thể được sử dụng để dự đoán các trạng thái lượng tử hóa (quantized) đã bị che (masked) sau khi chiếu. - projected_quantized_states (
torch.Tensorcó hình dạng(batch_size, sequence_length, config.proj_codevector_dim)) — Các vector đặc trưng đã trích xuất và lượng tử hóa, được chiếu lên config.proj_codevector_dim, đại diện cho các vector đích dương cho tổn thất tương phản. - codevector_perplexity (
torch.Tensorcó hình dạng(1,)) — Độ bất ngờ (perplexity) của phân phối codevector, được dùng để đo lường tính đa dạng của codebook. - hidden_states (
tuple[torch.Tensor], tuỳ chọn, được trả về khioutput_hidden_states=Trueđược truyền vào hoặc khiconfig.output_hidden_states=True) — Tuple củatorch.Tensor(một cho đầu ra của embeddings, nếu model có lớp embedding, + một cho đầu ra của mỗi lớp) có shape(batch_size, sequence_length, hidden_size).Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- attentions (
tuple[torch.Tensor], tuỳ chọn, được trả về khioutput_attentions=Trueđược truyền vào hoặc khiconfig.output_attentions=True) — Tuple củatorch.Tensor(một cho mỗi lớp) có hình dạng(batch_size, num_heads, sequence_length, sequence_length).Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
- contrastive_loss (
*optional*, được trả về khisample_negative_indicesđược truyền vào,torch.Tensorcó hình dạng(1,)) — Mất tương phản (L_m) như được nêu trong bài báo chính thức. - diversity_loss (
*optional*, được trả về khi truyềnsample_negative_indices,torch.Tensorcó hình dạng(1,)) — Mất đa dạng (L_d) như được nêu trong bài báo chính thức.
Loại đầu ra của Wav2Vec2ForPreTraining, có thể bao gồm trạng thái ẩn và chú ý.
Wav2Vec2Model
lớp transformers.Wav2Vec2Model
< source >( config: Wav2Vec2Config )
Tham số
- config (Wav2Vec2Config) — Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức from_pretrained() để tải trọng số của mô hình.
Mô hình Wav2Vec2 cơ bản, xuất ra các hidden-state thô mà không có bất kỳ head cụ thể nào ở phía trên.
Mô hình này kế thừa từ PreTrainedModel. Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu, v.v.)
Mô hình này cũng là một lớp con của torch.nn.Module trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
forward
< source >( input_values: typing.Optional[torch.Tensor]attention_mask: typing.Optional[torch.Tensor] = Nonemask_time_indices: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → Wav2Vec2BaseModelOutput or tuple(torch.Tensor)
Tham số
- input_values (
torch.Tensorcó shape(batch_size, sequence_length), tùy chọn) — Các giá trị float của dạng sóng âm thanh thô đầu vào. Các giá trị này có thể được lấy bằng cách nạp tệp âm thanh.flachoặc.wavvào một mảng có kiểulist[float], mộtnumpy.ndarrayhoặc mộttorch.Tensor, chẳng hạn thông qua thư viện torchcodec (pip install torchcodec) hoặc thư viện soundfile (pip install soundfile). Để chuẩn bị mảng thànhinput_values, cần sử dụng AutoProcessor để đệm (padding) và chuyển đổi thành tensor có kiểutorch.Tensor. Xem Wav2Vec2Processor.call() để biết thêm chi tiết. - attention_mask (
torch.Tensorcó hình dạng(batch_size, sequence_length), tùy chọn) — Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong[0, 1]:- 1 cho các token không bị che,
- 0 cho các token bị che.
- mask_time_indices (
torch.BoolTensorcó shape(batch_size, sequence_length), tuỳ chọn) — Các chỉ số để mask các đặc trưng đã trích xuất cho contrastive loss. Khi ở chế độ training, model học cách dự đoán các đặc trưng đã trích xuất bị mask trong không gian config.proj_codevector_dim.
Trả về
Wav2Vec2BaseModelOutput hoặc tuple(torch.Tensor)
Một Wav2Vec2BaseModelOutput hoặc một tuple của
torch.Tensor (nếu return_dict=False được truyền hoặc khi config.return_dict=False) bao gồm các
thành phần khác nhau tùy thuộc vào cấu hình (Wav2Vec2Config) và đầu vào.
Phương thức forward của Wav2Vec2Model ghi đè lên phương thức đặc biệt __call__.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, người dùng nên gọi instance của
Modulesau đó thay vì gọi hàm này, vì instanceModulesẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ lặng lẽ bỏ qua chúng.
last_hidden_state (
torch.Tensorcó hình dạng(batch_size, sequence_length, hidden_size)) — Chuỗi các hidden-state tại đầu ra của lớp cuối cùng của mô hình.extract_features (
torch.Tensorcó hình dạng(batch_size, sequence_length, conv_dim[-1])) — Chuỗi các vector đặc trưng đã trích xuất từ lớp tích chập cuối cùng của mô hình.hidden_states (
tuple(torch.Tensor), tuỳ chọn, được trả về khioutput_hidden_states=Trueđược truyền vào hoặc khiconfig.output_hidden_states=True) — Bộ tuple cáctorch.Tensor(một cho đầu ra của embeddings + một cho đầu ra của mỗi lớp) có shape(batch_size, sequence_length, hidden_size).Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với đầu ra của lớp nhúng ban đầu.
attentions (
tuple(torch.Tensor), tuỳ chọn, được trả về khioutput_attentions=Trueđược truyền vào hoặc khiconfig.output_attentions=True) — Tuple củatorch.Tensor(một cho mỗi lớp) có hình dạng(batch_size, num_heads, sequence_length, sequence_length).Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Wav2Vec2ForCTC
lớp transformers.Wav2Vec2ForCTC
< source >( config: Wav2Vec2Configtarget_lang: str | None = None )
Tham số
- config (Wav2Vec2Config) — Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức from_pretrained() để tải trọng số của mô hình.
- target_lang (
str, tùy chọn) — Id của ngôn ngữ cho trọng số adapter. Trọng số adapter được lưu dưới định dạng adapter..safetensors hoặc adapter. .bin. Chỉ liên quan khi sử dụng một instance của Wav2Vec2ForCTC với adapters. Mặc định sử dụng ‘eng’.
Mô hình Wav2Vec2 với đầu language modeling phía trên cho Connectionist Temporal Classification (CTC).
Mô hình này kế thừa từ PreTrainedModel. Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu, v.v.)
Mô hình này cũng là một lớp con của torch.nn.Module trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
forward
< source >( input_values: typing.Optional[torch.Tensor]attention_mask: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → CausalLMOutput or tuple(torch.Tensor)
Tham số
- input_values (
torch.Tensorcó shape(batch_size, sequence_length), tùy chọn) — Các giá trị float của dạng sóng âm thanh thô đầu vào. Các giá trị này có thể được lấy bằng cách nạp tệp âm thanh.flachoặc.wavvào một mảng có kiểulist[float], mộtnumpy.ndarrayhoặc mộttorch.Tensor, chẳng hạn thông qua thư viện torchcodec (pip install torchcodec) hoặc thư viện soundfile (pip install soundfile). Để chuẩn bị mảng thànhinput_values, cần sử dụng AutoProcessor để đệm (padding) và chuyển đổi thành tensor có kiểutorch.Tensor. Xem Wav2Vec2Processor.call() để biết thêm chi tiết. - attention_mask (
torch.Tensorcó hình dạng(batch_size, sequence_length), tùy chọn) — Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong[0, 1]:- 1 cho các token không bị che,
- 0 cho các token bị che.
- labels (
torch.LongTensorcó shape(batch_size, target_length), tùy chọn) — Nhãn cho phân loại thời gian kết nối (connectionist temporal classification). Lưu ý rằngtarget_lengthphải nhỏ hơn hoặc bằng chiều dài chuỗi của logits đầu ra. Các chỉ số được chọn trong[-100, 0, ..., config.vocab_size - 1]. Tất cả các nhãn được đặt thành-100sẽ bị bỏ qua (masked), loss chỉ được tính cho các nhãn trong[0, ..., config.vocab_size - 1].
Trả về
CausalLMOutput hoặc tuple(torch.Tensor)
Một CausalLMOutput hoặc một tuple của
torch.Tensor (nếu return_dict=False được truyền hoặc khi config.return_dict=False) bao gồm các
thành phần khác nhau tùy thuộc vào cấu hình (Wav2Vec2Config) và đầu vào.
Phương thức forward của Wav2Vec2ForCTC ghi đè lên phương thức đặc biệt __call__.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, người dùng nên gọi instance của
Modulesau đó thay vì gọi hàm này, vì instanceModulesẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ lặng lẽ bỏ qua chúng.
loss (
torch.Tensorcó shape(1,), tùy chọn, được trả về khilabelsđược cung cấp) — Loss của language modeling (cho next-token prediction).logits (
torch.Tensorcó hình dạng(batch_size, sequence_length, config.vocab_size)) — Điểm dự đoán của đầu mô hình hóa ngôn ngữ (điểm cho mỗi token trong từ vựng trước SoftMax).hidden_states (
tuple(torch.Tensor), tuỳ chọn, được trả về khioutput_hidden_states=Trueđược truyền vào hoặc khiconfig.output_hidden_states=True) — Bộ tuple củatorch.Tensor(một cho đầu ra của embeddings, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng(batch_size, sequence_length, hidden_size).Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
attentions (
tuple(torch.Tensor), tuỳ chọn, được trả về khioutput_attentions=Trueđược truyền vào hoặc khiconfig.output_attentions=True) — Tuple củatorch.Tensor(một cho mỗi lớp) có hình dạng(batch_size, num_heads, sequence_length, sequence_length).Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
>>> from transformers import AutoProcessor, Wav2Vec2ForCTC
>>> from datasets import load_dataset
>>> import torch

>>> dataset = load_dataset("hf-internal-testing/librispeech_asr_demo", "clean", split="validation")
>>> dataset = dataset.sort("id")
>>> sampling_rate = dataset.features["audio"].sampling_rate

>>> processor = AutoProcessor.from_pretrained("facebook/wav2vec2-base-960h")
>>> model = Wav2Vec2ForCTC.from_pretrained("facebook/wav2vec2-base-960h")

>>> # audio file is decoded on the fly
>>> inputs = processor(dataset[0]["audio"]["array"], sampling_rate=sampling_rate, return_tensors="pt")
>>> with torch.no_grad():
...     logits = model(**inputs).logits
>>> predicted_ids = torch.argmax(logits, dim=-1)

>>> # transcribe speech
>>> transcription = processor.batch_decode(predicted_ids)
>>> transcription[0]
...

>>> inputs["labels"] = processor(text=dataset[0]["text"], return_tensors="pt").input_ids

>>> # compute loss
>>> loss = model(**inputs).loss
>>> round(loss.item(), 2)
...
load_adapter
< source >( target_lang: strforce_load = True**kwargs )
Tham số
- target_lang (
str) — Phải là id ngôn ngữ của một trọng số adapter hiện có. Trọng số adapter được lưu trữ dưới định dạng adapter..safetensors hoặc adapter. .bin - force_load (
bool, mặc định làTrue) — Liệu có tải trọng số ngay cả khitarget_langkhớp vớiself.target_langhay không. - cache_dir (
Union[str, os.PathLike], tùy chọn) — Đường dẫn đến thư mục mà cấu hình mô hình được huấn luyện trước đã tải xuống sẽ được lưu đệm nếu không sử dụng bộ lưu đệm tiêu chuẩn. - force_download (
bool, tùy chọn, mặc định làFalse) — Có nên buộc tải lại (re-download) trọng số mô hình và các tệp cấu hình, ghi đè lên các phiên bản đã được lưu trong bộ nhớ đệm nếu chúng tồn tại hay không. - proxies (
dict[str, str], tuỳ chọn) — Một từ điển các máy chủ proxy để sử dụng theo giao thức hoặc điểm cuối, ví dụ:{'http': 'foo.bar:3128', 'http://hostname': 'foo.bar:4012'}. Các proxy này được sử dụng cho mỗi yêu cầu. - local_files_only(
bool, tuỳ chọn, mặc định làFalse) — Có chỉ xem các tệp cục bộ hay không (tức là không cố gắng tải xuống mô hình). - token (
strhoặcbool, tùy chọn) — Token được sử dụng làm HTTP bearer authorization cho các tệp từ xa. NếuTrue, hoặc không được chỉ định, sẽ sử dụng token được tạo khi chạyhf auth login(được lưu trong~/.huggingface). - revision (
str, tuỳ chọn, mặc định là"main") — Phiên bản mô hình cụ thể cần sử dụng. Nó có thể là tên nhánh, tên tag hoặc id commit, vì chúng tôi sử dụng hệ thống dựa trên git để lưu trữ mô hình và các artifact khác trên huggingface.co, do đórevisioncó thể là bất kỳ định danh nào được git cho phép.Để kiểm tra một pull request bạn đã tạo trên Hub, bạn có thể truyền
revision="refs/pr/<pr_number>". - mirror (
str, optional) — Mirror source to accelerate downloads in China. If you are from China and have an accessibility problem, you can set this option to resolve it. Note that we do not guarantee the timeliness or safety. Please refer to the mirror site for more information.
Tải một mô hình adapter ngôn ngữ từ một mô hình adapter đã được huấn luyện trước.
Kích hoạt “offline-mode” đặc biệt để sử dụng phương pháp này trong môi trường có tường lửa.
Ví dụ:
>>> from transformers import Wav2Vec2ForCTC, AutoProcessor

>>> ckpt = "facebook/mms-1b-all"
>>> processor = AutoProcessor.from_pretrained(ckpt)
>>> model = Wav2Vec2ForCTC.from_pretrained(ckpt, target_lang="eng")
>>> # set specific language
>>> processor.tokenizer.set_target_lang("spa")
>>> model.load_adapter("spa")
Wav2Vec2ForSequenceClassification
lớp transformers.Wav2Vec2ForSequenceClassification
< source >( config: Wav2Vec2Config )
Tham số
- config (Wav2Vec2Config) — Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức from_pretrained() để tải trọng số của mô hình.
Mô hình Wav2Vec2 với một đầu phân loại chuỗi phía trên (một lớp tuyến tính trên đầu ra đã được gộp) cho các tác vụ như SUPERB Keyword Spotting.
Mô hình này kế thừa từ PreTrainedModel. Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu, v.v.)
Mô hình này cũng là một lớp con của torch.nn.Module trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
forward
< source >( input_values: typing.Optional[torch.Tensor]attention_mask: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → SequenceClassifierOutput or tuple(torch.Tensor)
Tham số
- input_values (
torch.Tensorcó shape(batch_size, sequence_length)) — Các giá trị float của dạng sóng âm thanh thô đầu vào. Các giá trị này có thể được lấy bằng cách nạp tệp âm thanh.flachoặc.wavvào một mảng có kiểulist[float],numpy.ndarrayhoặctorch.Tensor, chẳng hạn thông qua thư viện torchcodec (pip install torchcodec) hoặc thư viện soundfile (pip install soundfile). Để chuẩn bị mảng thànhinput_values, cần sử dụng AutoProcessor để đệm (padding) và chuyển đổi thành tensor có kiểutorch.Tensor. Xem Wav2Vec2Processor.call() để biết thêm chi tiết. - attention_mask (
torch.Tensorcó hình dạng(batch_size, sequence_length), tùy chọn) — Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong[0, 1]:- 1 cho các token không bị che,
- 0 cho các token bị che.
- labels (
torch.LongTensorcó shape(batch_size,), tùy chọn) — Nhãn để tính loss cho phân loại/hồi quy chuỗi. Chỉ số phải nằm trong[0, ..., config.num_labels - 1]. Nếuconfig.num_labels == 1, loss hồi quy sẽ được tính (Mean-Square loss). Nếuconfig.num_labels > 1, loss phân loại sẽ được tính (Cross-Entropy).
Trả về
SequenceClassifierOutput hoặc tuple(torch.Tensor)
Một SequenceClassifierOutput hoặc một tuple của
torch.Tensor (nếu return_dict=False được truyền hoặc khi config.return_dict=False) bao gồm các
thành phần khác nhau tùy thuộc vào cấu hình (Wav2Vec2Config) và đầu vào.
Phương thức forward của Wav2Vec2ForSequenceClassification ghi đè lên phương thức đặc biệt __call__.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, người dùng nên gọi instance của
Modulesau đó thay vì gọi hàm này, vì instanceModulesẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ lặng lẽ bỏ qua chúng.
loss (
torch.Tensorcó shape(1,), optional, được trả về khilabelsđược cung cấp) — Loss phân loại (hoặc hồi quy nếu config.num_labels==1).logits (
torch.Tensorcó hình dạng(batch_size, config.num_labels)) — Điểm phân loại (hoặc hồi quy nếu config.num_labels==1) (trước SoftMax).hidden_states (
tuple(torch.Tensor), tuỳ chọn, được trả về khioutput_hidden_states=Trueđược truyền vào hoặc khiconfig.output_hidden_states=True) — Bộ tuple củatorch.Tensor(một cho đầu ra của embeddings, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng(batch_size, sequence_length, hidden_size).Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
attentions (
tuple(torch.Tensor), tuỳ chọn, được trả về khioutput_attentions=Trueđược truyền vào hoặc khiconfig.output_attentions=True) — Tuple củatorch.Tensor(một cho mỗi lớp) có hình dạng(batch_size, num_heads, sequence_length, sequence_length).Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ về phân loại nhãn đơn:
>>> import torch
>>> from transformers import AutoTokenizer, Wav2Vec2ForSequenceClassification

>>> tokenizer = AutoTokenizer.from_pretrained("facebook/wav2vec2-base-960h")
>>> model = Wav2Vec2ForSequenceClassification.from_pretrained("facebook/wav2vec2-base-960h")

>>> inputs = tokenizer("Hello, my dog is cute", return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> predicted_class_id = logits.argmax().item()
>>> model.config.id2label[predicted_class_id]
...

>>> # To train a model on `num_labels` classes, you can pass `num_labels=num_labels` to `.from_pretrained(...)`
>>> num_labels = len(model.config.id2label)
>>> model = Wav2Vec2ForSequenceClassification.from_pretrained("facebook/wav2vec2-base-960h", num_labels=num_labels)

>>> labels = torch.tensor([1])
>>> loss = model(**inputs, labels=labels).loss
>>> round(loss.item(), 2)
...
Ví dụ về phân loại đa nhãn:
>>> import torch
>>> from transformers import AutoTokenizer, Wav2Vec2ForSequenceClassification

>>> tokenizer = AutoTokenizer.from_pretrained("facebook/wav2vec2-base-960h")
>>> model = Wav2Vec2ForSequenceClassification.from_pretrained("facebook/wav2vec2-base-960h", problem_type="multi_label_classification")

>>> inputs = tokenizer("Hello, my dog is cute", return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> predicted_class_ids = torch.arange(0, logits.shape[-1])[torch.sigmoid(logits).squeeze(dim=0) > 0.5]

>>> # To train a model on `num_labels` classes, you can pass `num_labels=num_labels` to `.from_pretrained(...)`
>>> num_labels = len(model.config.id2label)
>>> model = Wav2Vec2ForSequenceClassification.from_pretrained(
...     "facebook/wav2vec2-base-960h", num_labels=num_labels, problem_type="multi_label_classification"
... )

>>> labels = torch.sum(
...     torch.nn.functional.one_hot(predicted_class_ids[None, :].clone(), num_classes=num_labels), dim=1
... ).to(torch.float)
>>> loss = model(**inputs, labels=labels).loss
Wav2Vec2ForAudioFrameClassification
lớp transformers.Wav2Vec2ForAudioFrameClassification
< source >( config: Wav2Vec2Config )
Tham số
- config (Wav2Vec2Config) — Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức from_pretrained() để tải trọng số của mô hình.
Mô hình Wav2Vec2 với một đầu phân loại khung (frame classification head) ở trên cùng cho các tác vụ như Speaker Diarization.
Mô hình này kế thừa từ PreTrainedModel. Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu, v.v.)
Mô hình này cũng là một lớp con của torch.nn.Module trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
forward
< source >( input_values: typing.Optional[torch.Tensor]attention_mask: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → TokenClassifierOutput or tuple(torch.Tensor)
Tham số
- input_values (
torch.Tensorcó shape(batch_size, sequence_length)) — Các giá trị float của dạng sóng âm thanh thô đầu vào. Các giá trị này có thể được lấy bằng cách nạp tệp âm thanh.flachoặc.wavvào một mảng có kiểulist[float],numpy.ndarrayhoặctorch.Tensor, chẳng hạn thông qua thư viện torchcodec (pip install torchcodec) hoặc thư viện soundfile (pip install soundfile). Để chuẩn bị mảng thànhinput_values, cần sử dụng AutoProcessor để đệm (padding) và chuyển đổi thành tensor có kiểutorch.Tensor. Xem Wav2Vec2Processor.call() để biết thêm chi tiết. - attention_mask (
torch.Tensorcó hình dạng(batch_size, sequence_length), tùy chọn) — Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong[0, 1]:- 1 cho các token không bị che,
- 0 cho các token bị che.
- labels (
torch.LongTensorcó shape(batch_size,), tùy chọn) — Nhãn để tính loss cho phân loại/hồi quy chuỗi. Chỉ số phải nằm trong[0, ..., config.num_labels - 1]. Nếuconfig.num_labels == 1, loss hồi quy sẽ được tính (Mean-Square loss). Nếuconfig.num_labels > 1, loss phân loại sẽ được tính (Cross-Entropy).
Trả về
TokenClassifierOutput hoặc tuple(torch.Tensor)
Một TokenClassifierOutput hoặc một tuple của
torch.Tensor (nếu return_dict=False được truyền hoặc khi config.return_dict=False) bao gồm các
thành phần khác nhau tùy thuộc vào cấu hình (Wav2Vec2Config) và đầu vào.
Phương thức forward của Wav2Vec2ForAudioFrameClassification ghi đè lên phương thức đặc biệt __call__.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, người dùng nên gọi instance của
Modulesau đó thay vì gọi hàm này, vì instanceModulesẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ lặng lẽ bỏ qua chúng.
loss (
torch.Tensorcó shape(1,), tuỳ chọn, được trả về khilabelsđược cung cấp) — Loss phân loại.logits (
torch.Tensorcó hình dạng(batch_size, sequence_length, config.num_labels)) — Điểm phân loại (trước SoftMax).hidden_states (
tuple(torch.Tensor), tuỳ chọn, được trả về khioutput_hidden_states=Trueđược truyền vào hoặc khiconfig.output_hidden_states=True) — Bộ tuple củatorch.Tensor(một cho đầu ra của embeddings, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng(batch_size, sequence_length, hidden_size).Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
attentions (
tuple(torch.Tensor), tuỳ chọn, được trả về khioutput_attentions=Trueđược truyền vào hoặc khiconfig.output_attentions=True) — Tuple củatorch.Tensor(một cho mỗi lớp) có hình dạng(batch_size, num_heads, sequence_length, sequence_length).Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
>>> from transformers import AutoFeatureExtractor, Wav2Vec2ForAudioFrameClassification
>>> from datasets import load_dataset
>>> import torch

>>> dataset = load_dataset("hf-internal-testing/librispeech_asr_demo", "clean", split="validation")
>>> dataset = dataset.sort("id")
>>> sampling_rate = dataset.features["audio"].sampling_rate

>>> feature_extractor = AutoFeatureExtractor.from_pretrained("facebook/wav2vec2-base-960h")
>>> model = Wav2Vec2ForAudioFrameClassification.from_pretrained("facebook/wav2vec2-base-960h")

>>> # audio file is decoded on the fly
>>> inputs = feature_extractor(dataset[0]["audio"]["array"], return_tensors="pt", sampling_rate=sampling_rate)
>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> probabilities = torch.sigmoid(logits[0])
>>> # labels is a one-hot array of shape (num_frames, num_speakers)
>>> labels = (probabilities > 0.5).long()
>>> labels[0].tolist()
...
Wav2Vec2ForXVector
lớp transformers.Wav2Vec2ForXVector
< source >( config: Wav2Vec2Config )
Tham số
- config (Wav2Vec2Config) — Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức from_pretrained() để tải trọng số của mô hình.
Mô hình Wav2Vec2 với đầu trích xuất đặc trưng XVector phía trên cho các tác vụ như Xác minh người nói.
Mô hình này kế thừa từ PreTrainedModel. Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu, v.v.)
Mô hình này cũng là một lớp con của torch.nn.Module trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
forward
< source >( input_values: typing.Optional[torch.Tensor]attention_mask: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.Tensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → XVectorOutput or tuple(torch.Tensor)
Tham số
- input_values (
torch.Tensorcó shape(batch_size, sequence_length)) — Các giá trị float của dạng sóng âm thanh thô đầu vào. Các giá trị này có thể được lấy bằng cách nạp tệp âm thanh.flachoặc.wavvào một mảng có kiểulist[float],numpy.ndarrayhoặctorch.Tensor, chẳng hạn thông qua thư viện torchcodec (pip install torchcodec) hoặc thư viện soundfile (pip install soundfile). Để chuẩn bị mảng thànhinput_values, cần sử dụng AutoProcessor để đệm (padding) và chuyển đổi thành tensor có kiểutorch.Tensor. Xem Wav2Vec2Processor.call() để biết thêm chi tiết. - attention_mask (
torch.Tensorcó hình dạng(batch_size, sequence_length), tùy chọn) — Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong[0, 1]:- 1 cho các token không bị che,
- 0 cho các token bị che.
- labels (
torch.LongTensorcó shape(batch_size,), tùy chọn) — Nhãn để tính loss cho phân loại/hồi quy chuỗi. Chỉ số phải nằm trong[0, ..., config.num_labels - 1]. Nếuconfig.num_labels == 1, loss hồi quy sẽ được tính (Mean-Square loss). Nếuconfig.num_labels > 1, loss phân loại sẽ được tính (Cross-Entropy).
Trả về
XVectorOutput hoặc tuple(torch.Tensor)
Một XVectorOutput hoặc một tuple của
torch.Tensor (nếu return_dict=False được truyền hoặc khi config.return_dict=False) bao gồm các
thành phần khác nhau tùy thuộc vào cấu hình (Wav2Vec2Config) và đầu vào.
Phương thức forward của Wav2Vec2ForXVector ghi đè lên phương thức đặc biệt __call__.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, người dùng nên gọi instance của
Modulesau đó thay vì gọi hàm này, vì instanceModulesẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ lặng lẽ bỏ qua chúng.
loss (
torch.Tensorcó shape(1,), tuỳ chọn, được trả về khilabelsđược cung cấp) — Loss phân loại.logits (
torch.Tensorcó hình dạng(batch_size, config.xvector_output_dim)) — Trạng thái ẩn phân loại trước AMSoftmax.embeddings (
torch.Tensorcó hình dạng(batch_size, config.xvector_output_dim)) — Các embedding của câu nói được sử dụng cho việc truy xuất dựa trên độ tương tự vector.hidden_states (
tuple(torch.Tensor), tuỳ chọn, được trả về khioutput_hidden_states=Trueđược truyền vào hoặc khiconfig.output_hidden_states=True) — Bộ tuple cáctorch.Tensor(một cho đầu ra của embeddings + một cho đầu ra của mỗi lớp) có shape(batch_size, sequence_length, hidden_size).Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với đầu ra của lớp nhúng ban đầu.
attentions (
tuple(torch.Tensor), tuỳ chọn, được trả về khioutput_attentions=Trueđược truyền vào hoặc khiconfig.output_attentions=True) — Tuple củatorch.Tensor(một cho mỗi lớp) có hình dạng(batch_size, num_heads, sequence_length, sequence_length).Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
>>> from transformers import AutoFeatureExtractor, Wav2Vec2ForXVector
>>> from datasets import load_dataset
>>> import torch

>>> dataset = load_dataset("hf-internal-testing/librispeech_asr_demo", "clean", split="validation")
>>> dataset = dataset.sort("id")
>>> sampling_rate = dataset.features["audio"].sampling_rate

>>> feature_extractor = AutoFeatureExtractor.from_pretrained("facebook/wav2vec2-base-960h")
>>> model = Wav2Vec2ForXVector.from_pretrained("facebook/wav2vec2-base-960h")

>>> # audio file is decoded on the fly
>>> inputs = feature_extractor(
...     [d["array"] for d in dataset[:2]["audio"]], sampling_rate=sampling_rate, return_tensors="pt", padding=True
... )
>>> with torch.no_grad():
...     embeddings = model(**inputs).embeddings

>>> embeddings = torch.nn.functional.normalize(embeddings, dim=-1).cpu()

>>> # the resulting embeddings can be used for cosine similarity-based retrieval
>>> cosine_sim = torch.nn.CosineSimilarity(dim=-1)
>>> similarity = cosine_sim(embeddings[0], embeddings[1])
>>> threshold = 0.7  # the optimal threshold is dataset-dependent
>>> if similarity < threshold:
...     print("Speakers are not the same!")
>>> round(similarity.item(), 2)
...
Wav2Vec2ForPreTraining
lớp transformers.Wav2Vec2ForPreTraining
< source >( config: Wav2Vec2Config )
Tham số
- config (Wav2Vec2Config) — Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức from_pretrained() để tải trọng số của mô hình.
Mô hình Wav2Vec2 có bộ lượng tử hóa và đầu VQ phía trên.
Mô hình này kế thừa từ PreTrainedModel. Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu, v.v.)
Mô hình này cũng là một lớp con của torch.nn.Module trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
forward
< source >( input_values: typing.Optional[torch.Tensor]attention_mask: typing.Optional[torch.Tensor] = Nonemask_time_indices: typing.Optional[torch.BoolTensor] = Nonesampled_negative_indices: typing.Optional[torch.BoolTensor] = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → Wav2Vec2ForPreTrainingOutput or tuple(torch.Tensor)
Tham số
- input_values (
torch.Tensorcó shape(batch_size, sequence_length), tùy chọn) — Các giá trị float của dạng sóng âm thanh thô đầu vào. Các giá trị này có thể được lấy bằng cách nạp tệp âm thanh.flachoặc.wavvào một mảng có kiểulist[float], mộtnumpy.ndarrayhoặc mộttorch.Tensor, chẳng hạn thông qua thư viện torchcodec (pip install torchcodec) hoặc thư viện soundfile (pip install soundfile). Để chuẩn bị mảng thànhinput_values, cần sử dụng AutoProcessor để đệm (padding) và chuyển đổi thành tensor có kiểutorch.Tensor. Xem Wav2Vec2Processor.call() để biết thêm chi tiết. - attention_mask (
torch.Tensorcó hình dạng(batch_size, sequence_length), tùy chọn) — Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong[0, 1]:- 1 cho các token không bị che,
- 0 cho các token bị che.
- mask_time_indices (
torch.BoolTensorcó shape(batch_size, sequence_length), tuỳ chọn) — Các chỉ số để mask các đặc trưng đã trích xuất cho contrastive loss. Khi ở chế độ training, model học cách dự đoán các đặc trưng đã trích xuất bị mask trong không gian config.proj_codevector_dim. - sampled_negative_indices (
torch.BoolTensorcó hình dạng(batch_size, sequence_length, num_negatives), tùy chọn) — Các chỉ số cho biết vector đích đã lượng tử hóa nào được sử dụng làm vector âm được lấy mẫu trong tổn thất tương phản. Là đầu vào bắt buộc cho quá trình tiền huấn luyện.
Trả về
Wav2Vec2ForPreTrainingOutput hoặc tuple(torch.Tensor)
Một Wav2Vec2ForPreTrainingOutput hoặc một tuple của
torch.Tensor (nếu return_dict=False được truyền hoặc khi config.return_dict=False) bao gồm các
thành phần khác nhau tùy thuộc vào cấu hình (Wav2Vec2Config) và đầu vào.
Phương thức forward của Wav2Vec2ForPreTraining ghi đè lên phương thức đặc biệt __call__.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, người dùng nên gọi instance của
Modulesau đó thay vì gọi hàm này, vì instanceModulesẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ lặng lẽ bỏ qua chúng.
loss (
*optional*, được trả về khisample_negative_indicesđược truyền vào,torch.Tensorcó hình dạng(1,)) — Tổng loss là tổng của contrastive loss (L_m) và diversity loss (L_d) như đã nêu trong bài báo chính thức.projected_states (
torch.Tensorcó hình dạng(batch_size, sequence_length, config.proj_codevector_dim)) — Các hidden-states của mô hình được chiếu lên config.proj_codevector_dim, có thể được sử dụng để dự đoán các trạng thái lượng tử hóa bị che khuất đã được chiếu.projected_quantized_states (
torch.Tensorcó hình dạng(batch_size, sequence_length, config.proj_codevector_dim)) — Các vector đặc trưng trích xuất đã lượng tử hóa, được chiếu lên config.proj_codevector_dim, đại diện cho các vector đích dương cho tổn thất tương phản.codevector_perplexity (
torch.Tensorcó hình dạng(1,)) — Độ perplexity của phân phối codevector, được sử dụng để đo lường tính đa dạng của codebook.hidden_states (
tuple[torch.Tensor], tuỳ chọn, được trả về khioutput_hidden_states=Trueđược truyền vào hoặc khiconfig.output_hidden_states=True) — Tuple củatorch.Tensor(một cho đầu ra của embeddings, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng(batch_size, sequence_length, hidden_size).Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
attentions (
tuple[torch.Tensor], tuỳ chọn, được trả về khioutput_attentions=Trueđược truyền vào hoặc khiconfig.output_attentions=True) — Tuple củatorch.Tensor(một cho mỗi lớp) có hình dạng(batch_size, num_heads, sequence_length, sequence_length).Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
contrastive_loss (
*optional*, được trả về khi truyềnsample_negative_indices,torch.Tensorcó hình dạng(1,)) — Mất tương phản (L_m) như được nêu trong bài báo chính thức.diversity_loss (
*optional*, được trả về khi truyềnsample_negative_indices,torch.Tensorcó hình dạng(1,)) — Mất đa dạng (L_d) như được nêu trong bài báo chính thức.
Ví dụ:
>>> import torch
>>> from transformers import AutoFeatureExtractor, Wav2Vec2ForPreTraining
>>> from transformers.models.wav2vec2.modeling_wav2vec2 import _compute_mask_indices, _sample_negative_indices
>>> from datasets import load_dataset

>>> feature_extractor = AutoFeatureExtractor.from_pretrained("facebook/wav2vec2-base")
>>> model = Wav2Vec2ForPreTraining.from_pretrained("facebook/wav2vec2-base")

>>> ds = load_dataset("hf-internal-testing/librispeech_asr_dummy", "clean", split="validation")
>>> input_values = feature_extractor(ds[0]["audio"]["array"], return_tensors="pt").input_values  # Batch size 1

>>> # compute masked indices
>>> batch_size, raw_sequence_length = input_values.shape
>>> sequence_length = model._get_feat_extract_output_lengths(raw_sequence_length).item()
>>> mask_time_indices = _compute_mask_indices(
...     shape=(batch_size, sequence_length), mask_prob=0.2, mask_length=2
... )
>>> sampled_negative_indices = _sample_negative_indices(
...     features_shape=(batch_size, sequence_length),
...     num_negatives=model.config.num_negatives,
...     mask_time_indices=mask_time_indices,
... )
>>> mask_time_indices = torch.tensor(data=mask_time_indices, device=input_values.device, dtype=torch.long)
>>> sampled_negative_indices = torch.tensor(
...     data=sampled_negative_indices, device=input_values.device, dtype=torch.long
... )

>>> with torch.no_grad():
...     outputs = model(input_values, mask_time_indices=mask_time_indices)

>>> # compute cosine similarity between predicted (=projected_states) and target (=projected_quantized_states)
>>> cosine_sim = torch.cosine_similarity(outputs.projected_states, outputs.projected_quantized_states, dim=-1)

>>> # show that cosine similarity is much higher than random
>>> cosine_sim[mask_time_indices.to(torch.bool)].mean() > 0.5
tensor(True)

>>> # for contrastive loss training model should be put into train mode
>>> model = model.train()
>>> loss = model(
...     input_values, mask_time_indices=mask_time_indices, sampled_negative_indices=sampled_negative_indices
... ).loss