
Hub documentation
WebDataset
WebDataset
WebDataset — это библиотека для создания конвейеров ввода-вывода для больших наборов данных. Её возможности последовательного ввода-вывода и шардирования делают её особенно полезной для потоковой передачи больших наборов данных в DataLoader.
Формат WebDataset
Файл WebDataset представляет собой архив TAR, содержащий серию файлов данных. Все последовательные файлы данных с одинаковым префиксом считаются частью одного примера (например, файл изображения/аудио и его метка или метаданные):
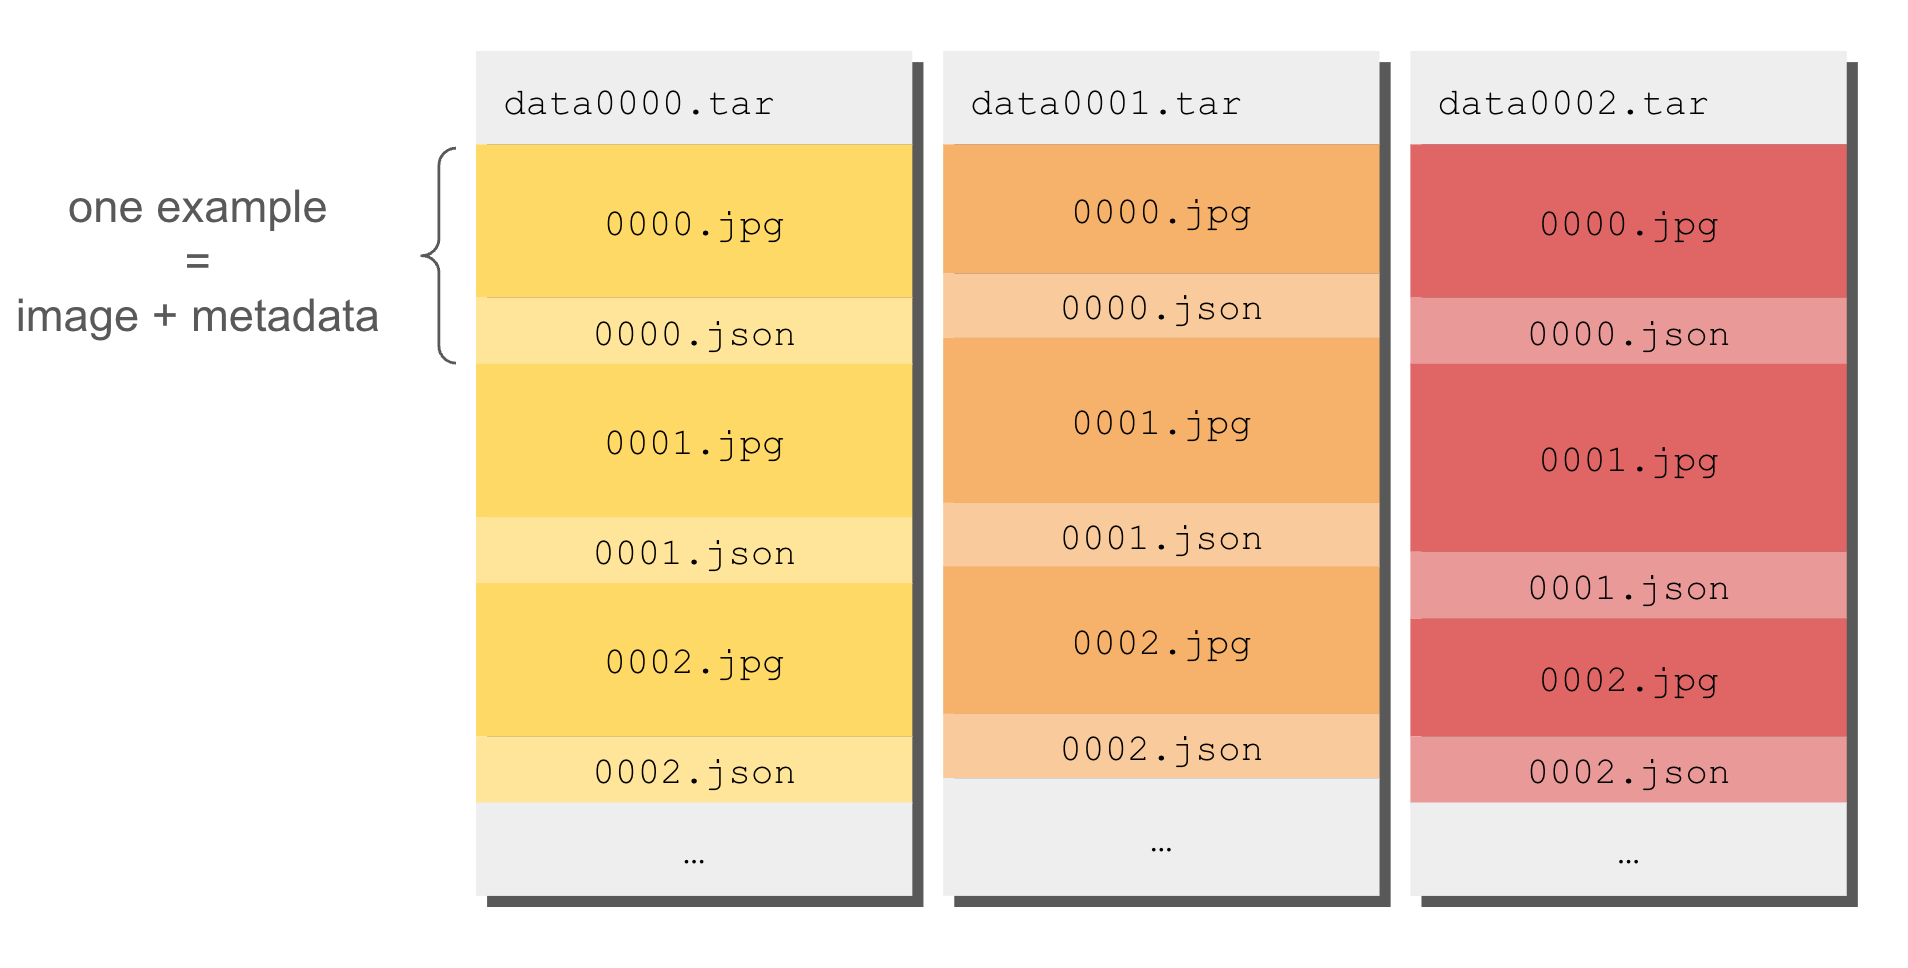

Метки и метаданные могут находиться в файле .json, в файле .txt (для подписи или описания) или в файле .cls (для индекса класса).
Большой WebDataset состоит из множества файлов, называемых шардами, каждый из которых представляет собой TAR-архив. Обычно каждый шард занимает около 1 ГБ, но полный набор данных может достигать нескольких терабайт!
Поддержка мультимодальности
WebDataset предназначен для мультимодальных наборов данных, то есть для наборов данных с изображениями, аудио и/или видео.
Действительно, поскольку медиафайлы, как правило, имеют большой размер, последовательный ввод-вывод WebDataset позволяет выполнять крупные операции чтения и буферизацию, что обеспечивает максимальную скорость загрузки данных.
Ниже приведен не исчерпывающий список поддерживаемых форматов данных:
- image: jpeg, png, tiff
- audio: mp3, m4a, wav, flac
- video: mp4, mov, avi
- other: npy, npz
Полный список со временем меняется и зависит от реализации. Например, форматы, поддерживаемые пакетом webdataset, можно найти в исходном коде здесь.
Потоковая передача
Потоковая обработка архивов TAR выполняется быстро, поскольку читает непрерывные блоки данных. Она может быть на порядки быстрее, чем чтение отдельных файлов данных по одному.
Стриминг WebDataset обеспечивает высокую скорость как при чтении с диска, так и из облачного хранилища, что делает его идеальным форматом для подачи данных в DataLoader:


Например, вот как стримить датасет timm/imagenet-12k-wds напрямую с Hugging Face:
Сначала вам нужно войти в свой аккаунт Hugging Face, например, с помощью:
hf auth loginЗатем вы можете стримить датасет с помощью WebDataset:
>>> import webdataset as wds
>>> from huggingface_hub import get_token
>>> from torch.utils.data import DataLoader

>>> hf_token = get_token()
>>> url = "https://huggingface.co/datasets/timm/imagenet-12k-wds/resolve/main/imagenet12k-train-{{0000..1023}}.tar"
>>> url = f"pipe:curl -s -L {url} -H 'Authorization:Bearer {hf_token}'"
>>> dataset = wds.WebDataset(url).decode()
>>> dataloader = DataLoader(dataset, batch_size=64, num_workers=4)
Перемешивание
Как правило, наборы данных в форматах WebDataset уже перемешаны и готовы к передаче в DataLoader. Однако вы можете перемешать данные повторно, используя приблизительное перемешивание WebDataset.
Помимо перемешивания списка шардов, WebDataset использует буфер для перемешивания набора данных без потери скорости:


Чтобы перемешать список шардированных файлов и случайным образом выбрать элементы из буфера перемешивания:
>>> buffer_size = 1000
>>> dataset = (
...     wds.WebDataset(url, shardshuffle=True)
...     .shuffle(buffer_size)
...     .decode()
... )