
Transformers documentation
Görsel-metin-metne
Görsel-metin-metne
Görüntü-metin-metin modelleri, aynı zamanda görsel dil modelleri (VLM) olarak da bilinir ve bir görüntü girdisi alan dil modelleridir. Bu modeller, görsel soru-cevaptan görüntü segmentasyonuna kadar çeşitli görevlerle uğraşabilir. Bu görev, görüntüden-metne göreviyle birçok benzerlik paylaşır; ancak görüntü açıklama gibi bazı örtüşen kullanım durumları vardır. Görüntüden-metne modelleri yalnızca görüntü girdileri alır ve genellikle belirli bir görevi gerçekleştirirken, VLM'ler açık uçlu metin ve görüntü girdileri alır ve daha genelci modellerdir.
Bu kılavuzda, VLM'ler hakkında kısa bir genel bakış sunuyor ve bunların Transformers ile çıkarım (inference) için nasıl kullanılacağını gösteriyoruz.
Başlangıç olarak, VLM'lerin birden fazla türü vardır:
- ince ayar için kullanılan temel modeller
- sohbet için ince ayar yapılmış modeller
- talimatla ince ayar yapılmış modeller
Bu kılavuz, talimatla ayarlanmış bir modelle çıkarıma (inference) üzerine odaklanır.
Bağımlılıkları kurmaya başlayalım.
pip install -q transformers accelerate
pip install flash-attn --no-build-isolation
Modeli ve işlemciyi başlatalım.
from transformers import AutoProcessor, AutoModelForImageTextToText
from accelerate import Accelerator
import torch

device = Accelerator().device
model = AutoModelForImageTextToText.from_pretrained(
    "Qwen/Qwen3-VL-4B-Instruct",
    dtype=torch.bfloat16,
    attn_implementation="flash_attention_2",
).to(device)
Qwen3-VL ve Qwen3.5 gibi dinamik çözünürlüklü modeller varsayılan olarak ~16MP
longest_edgekullanır; bu, görüntü başına 10.000'den fazla görsel token üreterek tüketici GPU'larında çıkarımı duraklatabilir veya OOM hatasına yol açabilir. Bunu sınırlamak için işlemciyi yüklerkenmin_pixelsvemax_pixelsdeğerlerini ayarlayın.
processor = AutoProcessor.from_pretrained(
    "Qwen/Qwen3-VL-4B-Instruct",
    min_pixels=224 * 224,
    max_pixels=1024 * 1024,
)
Bu modelin, kullanıcıların sohbet çıktılarını ayrıştırmasına yardımcı olan bir sohbet şablonu vardır. Ayrıca model, tek bir sohbet veya mesajda birden fazla görseli girdi olarak kabul edebilir. Şimdi girdileri hazırlayacağız.
Görsel girdiler aşağıdaki gibidir.
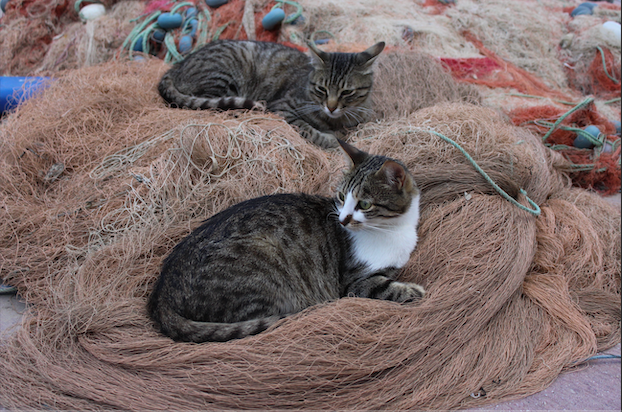
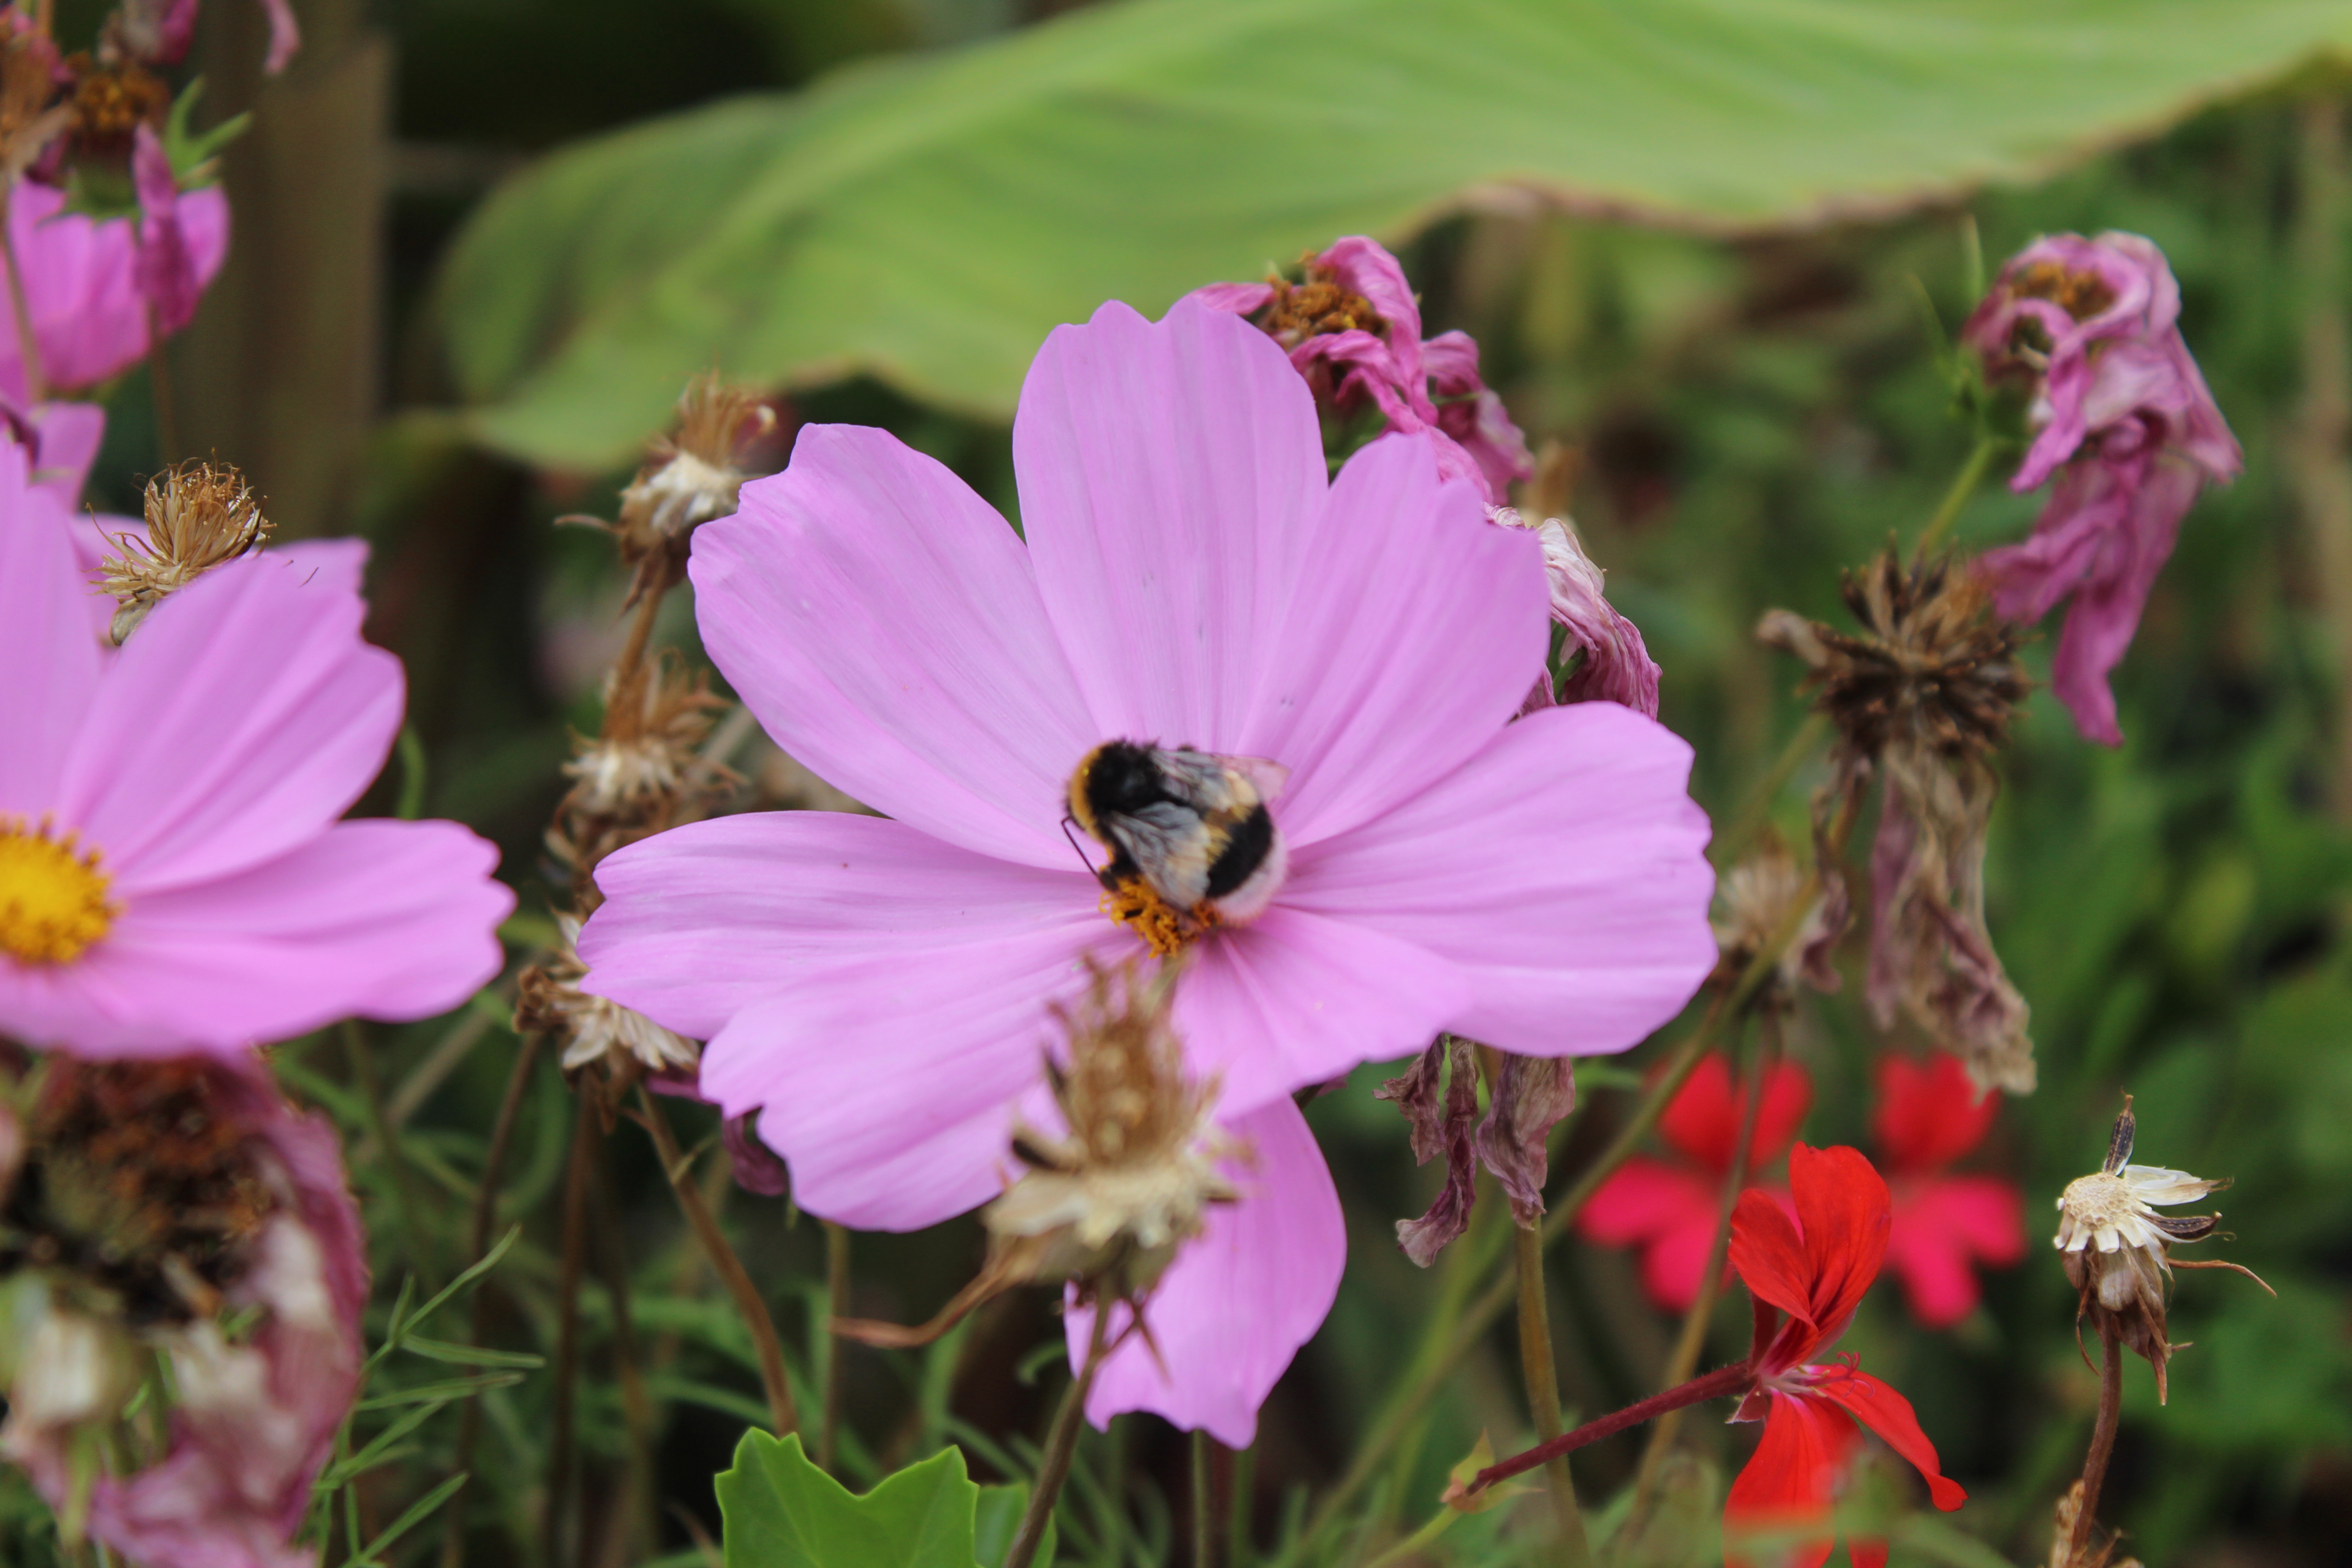
Görsel ve metin girdileri içeren tek bir istem için konuşmanızı aşağıda gösterildiği gibi yapılandırın.
messages = [
    {
        "role": "user",
        "content": [
            {"type": "image", "image": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/cats.png"},
            {"type": "text", "text": "What do we see in this image?"},
        ]
    }
]
Modelin daha iyi yanıtlar üretmesi için önceki bağlamla ilişkilendirmek üzere user ve assistant rolleri arasında geçiş yapın.
messages = [
    {
        "role": "user",
        "content": [
            {"type": "image", "image": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/cats.png"},
            {"type": "text", "text": "What do we see in this image?"},
        ]
    },
    {
        "role": "assistant",
        "content": [
            {"type": "text", "text": "In this image we can see two cats on the nets."},
        ]
    },
    {
        "role": "user",
        "content": [
            {"type": "image", "image": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/bee.jpg"},
            {"type": "text", "text": "And how about this image?"},
        ]
    },
]
Şimdi, çıktıyı görüntü girdileriyle birlikte ön işlemek için işleyicilerin apply_chat_template() yöntemini çağıracağız.
inputs = processor.apply_chat_template(messages, add_generation_prompt=True, tokenize=True, return_dict=True, return_tensors="pt").to(device)Artık ön işlenmiş girdileri modele iletebiliriz.
input_len = len(inputs.input_ids[0])

with torch.no_grad():
    generated_ids = model.generate(**inputs, max_new_tokens=200)
generated_texts = processor.batch_decode(generated_ids[:, input_len:], skip_special_tokens=True)

print(generated_texts)
## ['In this image we can see flowers, plants and insect.']
Pipeline
Başlamak için en hızlı yol, Pipeline API'sini kullanmaktır. "image-text-to-text" görevini ve kullanmak istediğiniz modeli belirtin.
from transformers import pipeline
pipe = pipeline("image-text-to-text", model="llava-hf/llava-interleave-qwen-0.5b-hf")
Aşağıdaki örnek, metin girdilerini biçimlendirmek için sohbet şablonlarını kullanır.
messages = [
     {
         "role": "user",
         "content": [
             {
                 "type": "image",
                 "image": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/bee.jpg",
             },
             {"type": "text", "text": "Describe this image."},
         ],
     },
     {
         "role": "assistant",
         "content": [
             {"type": "text", "text": "There's a pink flower"},
         ],
     },
 ]
Sohbet şablonu biçimlendirilmiş metni ve görüntüyü Pipeline nesnesine iletin ve üretilen çıktıdan girdiyi kaldırmak için return_full_text=False değerini ayarlayın.
outputs = pipe(text=messages, max_new_tokens=20, return_full_text=False)
outputs[0]["generated_text"]
#  with a yellow center in the foreground. The flower is surrounded by red and white flowers with green stems
İsterseniz, görselleri ayrı ayrı yükleyip pipeline nesnesine şu şekilde iletebilirsiniz:
import requests
from PIL import Image
from transformers import pipeline

pipe = pipeline("image-text-to-text", model="HuggingFaceTB/SmolVLM-256M-Instruct")

img_urls = [
    "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/cats.png",
    "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/bee.jpg",
]
images = [
    Image.open(requests.get(img_urls[0], stream=True).raw),
    Image.open(requests.get(img_urls[1], stream=True).raw),
]

messages = [
    {
        "role": "user",
        "content": [
            {"type": "image"},
            {"type": "image"},
            {"type": "text", "text": "What do you see in these images?"},
        ],
    }
]
outputs = pipe(text=messages, images=images, max_new_tokens=50, return_full_text=False)
outputs[0]["generated_text"]
" In the first image, there are two cats sitting on a plant. In the second image, there are flowers with a pinkish hue."
Görseller, çıktının "input_text" alanında yine yer alacaktır:
outputs[0]['input_text']
"""
[{'role': 'user',
  'content': [{'type': 'image',
    'image': <PIL.PngImagePlugin.PngImageFile image mode=RGBA size=622x412>},
   {'type': 'image',
    'image': <PIL.JpegImagePlugin.JpegImageFile image mode=RGB size=5184x3456>},
   {'type': 'text', 'text': 'What do you see in these images?'}]}]
"""
Akış
Daha iyi bir üretim deneyimi için metin akışı kullanabiliriz. Transformers, TextStreamer veya TextIteratorStreamer sınıflarıyla akışı destekler. IDEFICS-8B ile TextIteratorStreamer kullanacağız.
Sohbet geçmişini tutan ve yeni kullanıcı girdilerini alan bir uygulamamız olduğunu varsayalım. Girdileri normal şekilde ön işleyecek ve üretimi ayrı bir iş parçacığında yönetmek için TextIteratorStreamer sınıfını başlatacağız. Bu sayede üretilen metin token'larını gerçek zamanlı olarak akışa alabilirsiniz. TextIteratorStreamer sınıfına herhangi bir üretim argümanı geçirilebilir.
import time
from transformers import TextIteratorStreamer
from threading import Thread

def model_inference(
    user_prompt,
    chat_history,
    max_new_tokens,
    images
):
    user_prompt = {
        "role": "user",
        "content": [
            {"type": "image"},
            {"type": "text", "text": user_prompt},
        ]
    }
    chat_history.append(user_prompt)
    streamer = TextIteratorStreamer(
        processor.tokenizer,
        skip_prompt=True,
        timeout=5.0,
    )

    generation_args = {
        "max_new_tokens": max_new_tokens,
        "streamer": streamer,
        "do_sample": False
    }

    # add_generation_prompt=True makes model generate bot response
    prompt = processor.apply_chat_template(chat_history, add_generation_prompt=True)
    inputs = processor(
        text=prompt,
        images=images,
        return_tensors="pt",
    ).to(device)
    generation_args.update(inputs)

    thread = Thread(
        target=model.generate,
        kwargs=generation_args,
    )
    thread.start()

    acc_text = ""
    for text_token in streamer:
        time.sleep(0.04)
        acc_text += text_token
        if acc_text.endswith("<end_of_utterance>"):
            acc_text = acc_text[:-18]
        yield acc_text

    thread.join()
Şimdi oluşturduğumuz model_inference fonksiyonunu çağıralım ve değerleri akıtalım.
generator = model_inference(
    user_prompt="And what is in this image?",
    chat_history=messages[:2],
    max_new_tokens=100,
    images=images
)

for value in generator:
  print(value)

# In
# In this
# In this image ...
Daha küçük donanımlarda modelleri eğitin
VLM'ler genellikle büyük boyutludur ve daha küçük donanımlara sığabilmeleri için optimize edilmeleri gerekir. Transformers, birçok model kuantizasyon kütüphanesini destekler ve burada yalnızca Quanto ile int8 kuantizasyonunu göstereceğiz. int8 kuantizasyonu, tüm ağırlıklar kuantize edildiyse bellek kullanımında yüzde 75'e varan iyileşmeler sunar. Ancak bu bedava bir öğle yemeği değildir; 8-bit, CUDA yerel bir hassasiyet olmadığından ağırlıklar uçuşta sürekli kuantize ve dekuantize edilir, bu da gecikmeye (latency) eklenir.
Öncelikle bağımlılıkları yükleyin.
pip install -U optimum-quanto bitsandbytes
Bir modeli yükleme sırasında nicelleştirmek için önce QuantoConfig oluşturulmalıdır. Ardından model normal şekilde yüklenir, ancak model başlatma sırasında quantization_config parametresi iletilir.
from transformers import AutoModelForImageTextToText, QuantoConfig

model_id = "Qwen/Qwen3-VL-4B-Instruct"
quantization_config = QuantoConfig(weights="int8")
quantized_model = AutoModelForImageTextToText.from_pretrained(
    model_id, device_map="auto", quantization_config=quantization_config
)

messages = [
    {
        "role": "user",
        "content": [
            {"type": "image", "image": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/cats.png"},
            {"type": "text", "text": "What do we see in this image?"},
        ]
    },
]
inputs = processor.apply_chat_template(messages, add_generation_prompt=True, tokenize=True, return_dict=True, return_tensors="pt").to(quantized_model.device)
input_len = len(inputs.input_ids[0])

with torch.no_grad():
    generated_ids = quantized_model.generate(**inputs, cache_implementation="static", max_new_tokens=100)
generated_texts = processor.batch_decode(generated_ids[:, input_len:], skip_special_tokens=True)

print(generated_texts[0])
## ['In this image, we see two tabby cats resting on a large, tangled pile of fishing nets. The nets are a mix of brown, orange, and red colors, with some blue and green ropes visible in the background. The cats appear relaxed and comfortable, nestled into the fibers of the nets. One cat is in the foreground, looking slightly to the side, while the other is positioned further back, looking directly at the camera. The scene suggests a coastal or fishing-related setting, possibly near']
Ve bu kadar, modeli hiçbir değişiklik yapmadan aynı şekilde kullanabiliriz.
Önbellekle iteratif sohbet
Çok modlu sohbet ajanları geliştiriyorsanız, muhtemelen aynı görüntüleri veya sesleri turlar arasında aktarıyorsunuz. Önbellekleme, her seferinde yeniden işleme yapmak yerine bu öğelerin kodlanmış temsillerini yeniden kullanmanızı sağlayarak gereksiz hesaplamaları azaltır.
Sadece metin kullanan modellerde olduğu gibi, çok modlu modeller de sohbet geçmişini chat template ile takip eder. Temel fark, chat template'in yalnızca "text" biçiminde uygulanması ve yeni çok modlu içeriğin ayrı işlenmesidir. Şablonu işleme (processing) ile uygularsanız, Jinja daha önce kodlanmış girdileri yeni girdilerden ayırt edemediği için her turda tüm sohbet yeniden işlenir.
Aşağıdaki örnek bu deseni göstermektedir. Sadece metin kullanan modeller için iteratif üretim kılavuzuna bakın.
Bu deseni gösteren basit bir Python örneği aşağıdadır. Sadece metin kullanan modeller için bir örneğe göz atmak için bu kılavuza bakın.
import torch
from transformers import AutoProcessor, Gemma4ForConditionalGeneration, TextStreamer
from transformers.cache_utils import DynamicCache
from transformers.image_utils import load_image
from transformers.audio_utils import load_audio

model_id = 'google/gemma-4-E2B-it'
processor = AutoProcessor.from_pretrained(model_id)
model = Gemma4ForConditionalGeneration.from_pretrained(model_id, dtype=torch.float32, device_map='cpu')

past_key_values = DynamicCache()
streamer = TextStreamer(processor.tokenizer, skip_prompt=True, skip_special_tokens=True)

## Turn 1: multimodal input (text + image + audio)
audio = load_audio("https://huggingface.co/datasets/Xenova/transformers.js-docs/resolve/main/jfk.wav")
image = load_image("https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/bee.jpg")
messages = [
    {
        "role": "user",
        "content": [
            {"type": "text", "text": "In detail, describe the following audio and image."},
            {"type": "audio"},
            {"type": "image"},
        ],
    },
]
input_string = processor.apply_chat_template(messages, add_generation_prompt=True, tokenize=False)
inputs = processor(text=input_string, images=[image], audio=[audio], return_tensors='pt')
output = model.generate(**inputs, past_key_values=past_key_values, max_new_tokens=1024, do_sample=False, streamer=streamer)
first_response = processor.decode(output[0][inputs['input_ids'].shape[1]:], skip_special_tokens=True)

## Turn 2: text-only follow-up (reuses KV cache, no new media)
messages.append({"role": "assistant", "content": [{"type": "text", "text": first_response}]})
cached_string = processor.apply_chat_template(messages, tokenize=False)
messages.append({"role": "user", "content": [{"type": "text", "text": "Summarize the previous descriptions in one sentence."}]})
full_string = processor.apply_chat_template(messages, add_generation_prompt=True, tokenize=False)
new_string = full_string[len(cached_string):]

new_input_ids = processor.tokenizer(new_string, add_special_tokens=False, return_tensors='pt')['input_ids']
# Build and pass an attention mask only if batched input or there is padding
# attention_mask = torch.ones(1, past_key_values.get_seq_length() + new_input_ids.shape[1], dtype=torch.long)

output2 = model.generate(input_ids=new_input_ids, past_key_values=past_key_values, max_new_tokens=1024, do_sample=False, streamer=streamer)
second_response = processor.decode(output2[0][new_input_ids.shape[1]:], skip_special_tokens=True)

## Turn 3: new image (must go through processor for image token expansion + encoding)
image2 = load_image("https://huggingface.co/datasets/Xenova/transformers.js-docs/resolve/main/artemis.jpeg")
messages.append({"role": "assistant", "content": [{"type": "text", "text": second_response}]})
cached_string2 = processor.apply_chat_template(messages, tokenize=False)
messages.append({"role": "user", "content": [{"type": "text", "text": "Describe this image."}, {"type": "image"}]})
full_string2 = processor.apply_chat_template(messages, add_generation_prompt=True, tokenize=False)
new_string2 = full_string2[len(cached_string2):]

new_inputs2 = processor(text=new_string2, images=[image2], add_special_tokens=False, return_tensors='pt')
# new_inputs2['attention_mask'] = torch.ones(1, past_key_values.get_seq_length() + new_inputs2['input_ids'].shape[1], dtype=torch.long)
new_inputs2['past_key_values'] = past_key_values

output3 = model.generate(**new_inputs2, max_new_tokens=1024, do_sample=False, streamer=streamer)
Daha Fazla Okuma
Görsel-metinden-metne görevi için daha fazla kaynak aşağıda listelenmiştir.
- Görsel-metin-metin görevi sayfası, model türlerini, kullanım durumlarını, veri kümelerini ve daha fazlasını kapsar.
- Görüntü Dil Modellerinin Açıklanması, TRL kullanarak görüntü dil modelleri ve denetimli ince ayar hakkında her şeyi kapsayan bir blog yazısıdır.
- TRL kullanarak görme dil modellerini ince ayar yapmayı öğrenin